首先祝我生日快乐()
消息队列
紧跟之前的内容,这次我们学习消息队列
概念解析
消息队列是一种异步通信机制,用于在分布式系统中解耦发送方和接收方之间的通信。
它通过在消息生产者和消费者之间引入一个中间缓冲区(常见为 broker),将消息存储在 broker 中,然后由消费者从 broker 中读取和处理消息。
用法解析
消息队列通常有三大用处:
- 异步通信:发送消息-处理消息-返回响应 不再是单一的线性结构
- 限流削峰: 高流量是把任务消息缓冲在消息队列中,而不是立即处理
- 服务解耦:生产者和消费者不再互相影响,彻底解耦,可各自独立拓展
当不需要立即获得结果,但是并发量又需要进行控制的时候,大概就是需要使用消息队列的时候
异步通信
在常规的微服务中,存在两种通信方式:
同步通信:即一个任务流程为固定的线性消息传递,并在最后一个任务完成后依次向上传递消息给客户端
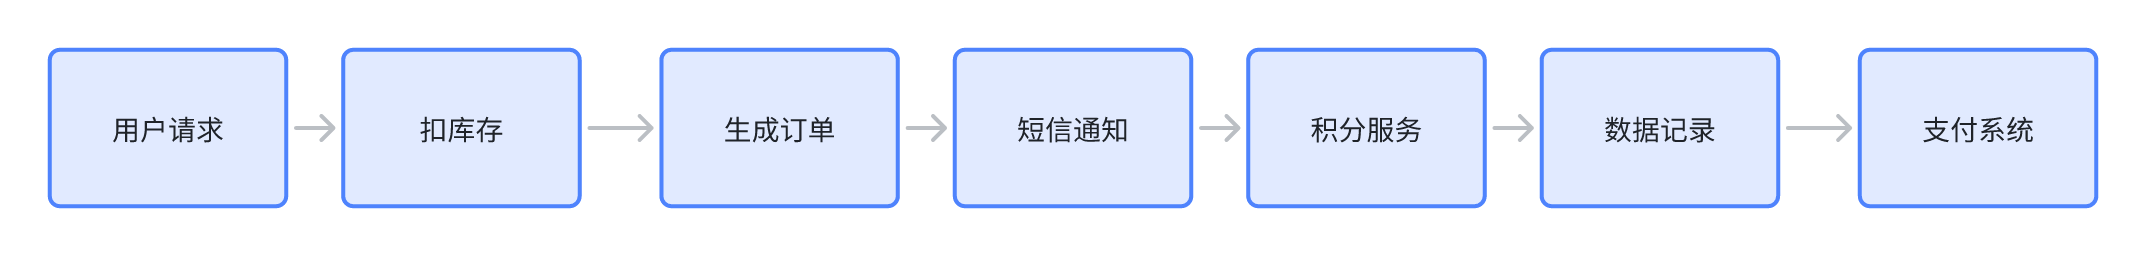
这样的信息传递方式较慢,假设每个服务需要200ms处理时间,那么这次请求一共会占用(200*n)ms的处理时间
。并且要在到达最底层才能原路返回信息消息队列(异步通信):当需要派发任务时,把派发信息传入消息队列中,然后消息队列异步分发任务并收集信息,被封发的任务会异步处理
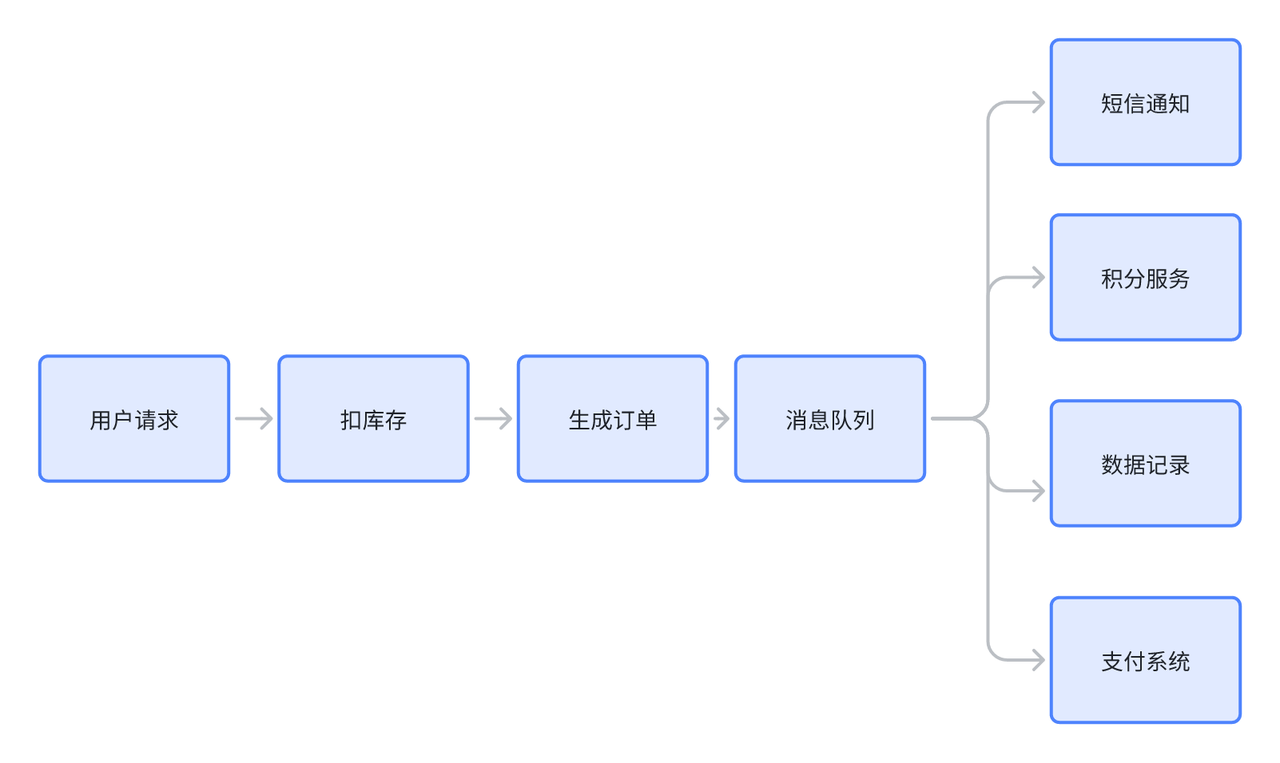
这种方式使用更少的处理时间(变为木桶效应),并在写入消息队列后立即返回成功给客户端,则总的响应时间依赖于写入消息队列的时间
严谨地说,是消息队列采用了异步通信的机制,并在异步通信的基础上使用消息队列缓冲处理,总的处理时间相比串行提高了2倍,相比并行提高了一倍
限流削峰
消息队列可以做服务通信的缓冲,广泛应用于秒杀或抢购活动中,避免流量过大导致应用系统挂掉的情况;
具体场景:购物网站开展秒杀活动,一般由于瞬时访问量过大,服务器接收过大,会导致流量暴增,相关系统无法处理请求甚至崩溃。而加入消息队列后,系统可以从消息队列中取数据,相当于消息队列做了一次缓冲。
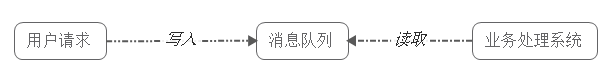
该方法有如下优点:
请求先入消息队列,而不是由业务处理系统直接处理,做了一次缓冲,极大地减少了业务处理系统的压力;
队列长度可以做限制,事实上,秒杀时,后入队列的用户无法秒杀到商品,这些请求可以直接被抛弃,返回活动已结束或商品已售完信息;
服务解耦
消息队列将服务发送方和接收方解耦,也就是说,
如果需要加新业务,只需要订阅消息队列的消息,不用去修改其他模块的代码,多应用间通过消息队列对同一消息进行处理,避免调用接口失败导致整个过程失败
如图所示:
不使用消息队列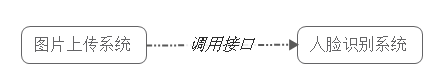
使用消息队列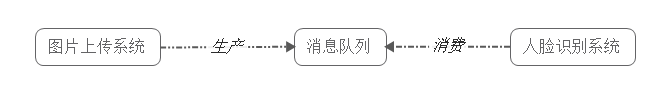
此时图片上传系统并不需要关心人脸识别系统是否对这些图片信息的处理、以及何时对这些图片信息进行处理。事实上,由于用户并不需要立即知道人脸识别结果,人脸识别系统可以选择不同的调度策略,按照闲时、忙时、正常时间,对队列中的图片信息进行处理
消息队列的系统
消息队列的系统将不同服务分为消息队列、消息生产者、消息消费者(与协程池类似)
该方法有如下优点:
- 避免了直接调用下一个系统导致当前系统失败;
- 每个子系统对于消息的处理方式可以更为灵活,可以选择收到消息时就处理,可以选择定时处理,也可以划分时间段按不同处理速度处理;
消息队列模型分类
消息队列分为两种模型:Queue与Topic
Queue(Peer-to-Peer)
简称PTP队列模式,在该模式下,一条消息只能有一位生产者和一位消费者,即消息在注册时只能由特定的消费者消费
在该模式下,工作流程/原理如下:
- 消息生产者
Producer1生产消息到Queue,然后Consumer1从Queue中取出并且消费消息。 - 消息被消费后,
Queue将不再存储消息,其它所有Consumer不可能消费到已经被其它Consumer消费过的消息。 Queue支持存在多个Producer,但是对一条消息而言,只会有一个Consumer可以消费,其它Consumer则不能再次消费。- 但
Consumer不存在时,消息则由Queue一直保存,直到有Consumer把它消费。
Topic(Publish/Subscribe)
简称发布/订阅模式,在该模式下,消息会携带主题(Topic),而所有订阅了该主题的消费者都可以接受到该消息并消费
在该模式下,工作流程/原理如下:
- 消息发布者
Publisher将消息发布到主题Topic中,同时有多个消息消费者Subscriber消费该消息。 - 和PTP方式不同,发布到
Topic的消息会被所有订阅者消费。 - 当发布者发布消息,不管是否有订阅者,都不会报错信息。
- 一定要先有消息发布者,后有消息订阅者。
Kafka所采用的就是发布/订阅模式,被称为一种高吞吐量、持久性、分布式的发布订阅的消息队列系统
消息队列常见问题与应对
消息丢失
要保证在完整的消息队列流程中做到消息不丢失,我们需要保证生产者,消费者和broker三方配合:
producer需要处理好Broker的响应,出错情况下利用重试、报警等手段Broker需要控制响应的时机,单机情况下是消息刷盘后返回响应,集群多副本情况下,即发送至两个副本及以上的情况下再返回响应consumer需要在执行完真正的业务逻辑之后再返回响应给Broker
但是消息可靠性的增强伴随着性能的下降,等待消息刷盘、多副本同步后返回都会影响性能。因此具体情况由具体业务分析,例如日志的传输可能丢那么一两条关系不大,因此没必要等消息刷盘再响应
重复消息
在使用消息队列中难免会遇到消息重复的现象:
- 当消息发到
Broker上,等待Broker响应的过程中,可能存在Broker已经写入,但由于网络原因生产者没有即使收到响应,使得生产者又重发了一次,此时就产生了重复消息 - 当消费者消费消息后更新
Consumer offset时挂了,并另一个消费者顶上时,Consumer offset还没更新,于是新消费者又拿到刚才那条消息,业务又被执行了一遍。又产生了信息重复
因此正常业务的消息重复是不可避免的,因此我们只能从另一个角度来解决重复消息的问题:保证业务流程的幂等性
早在学习数据库时我们便已经了解了幂等性这一概念,即同样的参数多次调用同一个接口和调用一次产生的结果一致
具体如何保证幂等或者使用其他方式处理重复消息,还是需要根据具体业务需求灵活对策
消息的有序性
什么是消息有序性?
消息有序性指的是消息被消费的顺序与它们被发送的顺序保持一致
假设有一个订单状态变更的场景:订单创建 → 支付成功 → 发货 → 确认收货 → 订单完成,
如果消息乱序到达,比如先收到"发货",后收到"支付成功",这就会导致业务逻辑错误
为什么会产生消息有序性错误?
消息队列为了提高并发性能,通常会采用以下设计:
- 多生产者/消费者
- 多分区/队列
- 异步处理
- 重试机制
这些设计导致消息可能不按顺序被处理
如何保证消息有序性?
我们通常使用部分有序来保证消息有序需求
即只保证同一"组"内的消息有序,不同组之间可以并行
实现思路:
- 将需要顺序的消息分组(如按订单ID、用户ID等)
- 同组消息发送到同一个队列
- 每个队列有且只有一个消费者单线程处理
这样就能在一定程度上保证消息只能以一定的顺序被接收
消息堆积
消息的堆积往往是因为生产者的生产速度与消费者的消费速度不匹配。
或者因为消息消费失败反复重试造成,也有可能就是消费者消费能力弱,渐渐地消息就积压了
因此我们需要先定位消费慢的原因,如果是bug则处理 bug ,如果是因为本身消费能力较弱,我们可以优化下消费逻辑,比如之前是一条一条消息消费处理的,这次我们批量处理,比如数据库的插入,一条一条插和批量插效率是不一样的。
假如逻辑我们已经都优化了,但还是慢,那就得考虑水平扩容了,增加Topic的队列数和消费者数量,注意队列数一定要增加,不然新增加的消费者是没东西消费的。一个Topic中,一个队列只会分配给一个消费者
选型&实践
常见消息队列: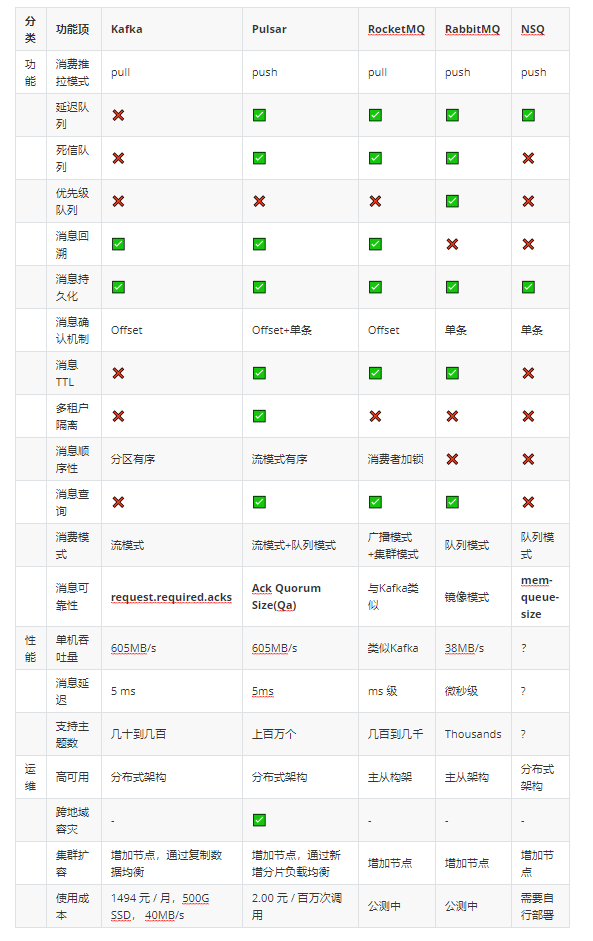
接下来我们以Kafka为例进行项目中集成消息队列的实战
概述
Kafka是Apache旗下的一款分布式流媒体平台,Kafka是一种高吞吐量、持久性、分布式的发布订阅的消息队列系统。 它最初由LinkedIn(领英)公司发布,使用Scala语言编写,与2010年12月份开源,成为Apache的顶级子项目
Kafka三大特点:
- 高吞吐量:可以满足每秒百万级别消息的生产和消费
- 持久性:有一套完善的消息存储机制,确保数据高效安全且持久化
- 分布式:基于分布式的扩展;
Kafka的数据都会复制到几台服务器上,当某台故障失效时,生产者和消费者转而使用其它的Kafka
概念介绍
- Producer:消息和数据的生产者,主要负责生产Push消息到指定的Topic中。
- Consumer:消息和数据的消费者,主要负责主动到已订阅的Topic中拉取消息并消费。
- Broker:Kafka节点就是被称为Broker,Broker主要负责创建Topic,存储Producer所发布的消息,记录消息处理的过程,现是将消息保存到内存中,然后持久化到磁盘。
- Topic:同一个Topic的消息可以分布在一个或多个Broker上,一个Topic包含一个或者多个Partition分区,数据被存储在多个Partition中。
- Partition:分区,在这里被称为Topic物理上的分组,一个Topic在Broker中被分为1个或者多个Partition,也可以说为每个Topic包含一个或多个Partition,分区在创建Topic的时候可以指定。分区才是真正存储数据的单元。
连接Kafka集群
一个Kafka集群是由下列几种类型的节点构成的,它们充当着不同的作用:
- Broker节点:即代理节点,是Kafka中的工作节点,充当消息队列的角色,负责储存和处理消息,每个Broker都是一个独立的Kafka服务器,可以在不同的机器上运行,除此之外Broker还负责分区(partition)的管理,将主题(topic)划分为多个分区,并分布在集群的不同Broker上
- Controller节点:即控制器节点,是集群中的特殊节点,负责储存和管理整个集群元数据和状态,它能够监控整个集群中的Broker,在需要时还能够进行平衡操作
- 混合节点:即同时担任Broker和Controller节点角色的节点
部署Kafka集群可用两种模式:Zookeeper模式或KRaft模式集群
Zookeeper模式集群
Zookeeper是简单、传统的集群搭建方式,在这种模式下,每个Kafka节点都是依赖于Zookeeper的,使用Zookeeper存储集群中所有节点的元数据
但该模式增加了运维成本(需要额外保护Zookeeper),且Zookeeper是强一致性的组件(符合CP理论),如果集群中数据发生变化,那么必须要等到其它节点都同步,至少超过一半同步完成,这样节点数多性能差
社区趋势:Kafka 4.0 后将完全移除 ZooKeeper 依赖
KRaft模式集群
KRaft模式是新版本Kafka中推出的集群模式,只需要数个Kafka节点就可以直接构成集群
在这时集群中的Kafka节点既有可能是Controller节点也可能是Broker节点,在这个模式中,我们不仅可以手动配置某个节点的角色(是Controller还是Broker),还可以使其同时担任Broker和Controller角色(混合节点)
实践
部署
Kafka在2.8版本正式移除了对Zookeeper的依赖,此处我们部署单节点kafka
需要注意的是,Bitnami官方近期调整了镜像分发策略。自2026年2月起,Bitnami核心安全镜像(包括Kafka、Redis、MySQL等)已全面取消Docker Hub的免费下载服务,需要商业订阅才能获取,不过轩辕镜像仓库提供了Bitnami Legacy全品类旧版遗留镜像的免费拉取服务,所以此处我们使用轩辕仓库的镜像
创建docker-compose.yaml
version: "3.5"
services:
  kafka1:
    image: 'docker.xuanyuan.run/bitnamilegacy/kafka:3.3.2-debian-11-r11'
    container_name: kafka1
    user: root
    ports:
      - "9092:9092"
      - "9093:9093"
    environment:
      KAFKA_ENABLE_KRAFT: yes # 允许使用kraft,即Kafka替代Zookeeper
      KAFKA_CFG_PROCESS_ROLES: broker,controller # kafka角色,做broker,也要做controller
      KAFKA_CFG_CONTROLLER_LISTENER_NAMES: CONTROLLER # 指定供外部使用的控制类请求信息
      KAFKA_CFG_LISTENERS: PLAINTEXT://:9092,CONTROLLER://:9093 # 定义kafka服务端socket监听端口
      KAFKA_CFG_LISTENER_SECURITY_PROTOCOL_MAP: CONTROLLER:PLAINTEXT,PLAINTEXT:PLAINTEXT # 定义安全协议
      KAFKA_KRAFT_CLUSTER_ID: LelM2dIFQkiUFvXCEcqRWA # 使用Kafka时的集群id,集群内的Kafka都要用这个id做初始化,生成一个UUID即可
      KAFKA_CFG_CONTROLLER_QUORUM_VOTERS: 1@kafka1:9093 # 集群地址
      ALLOW_PLAINTEXT_LISTENER: yes # 允许使用PLAINTEXT监听器,默认false,不建议在生产环境使用
      KAFKA_HEAP_OPTS: -Xmx512M -Xms256M # 设置broker最大内存,和初始内存
      KAFKA_CFG_AUTO_CREATE_TOPICS_ENABLE: false # 禁止自动创建主题
      KAFKA_CFG_ADVERTISED_LISTENERS: PLAINTEXT://localhost:9092 # 定义外网访问地址(宿主机ip地址和端口)
      KAFKA_BROKER_ID: 1 # broker.id,必须唯一
      KAFKA_CFG_NODE_ID: "1"
    volumes:
      - kafka1_data:/bitnami/kafka
#      extra_hosts:
#          - "kafka1:云服务器IP"
#          - "kafka2:云服务器IP"
#          - "kafka3:云服务器IP"

volumes:
kafka1_data:然后启动docker-compose
docker-compose up -d这样Kafka就会运行在docker中了
在项目中集成
有很多可以操作kafka的第三方库,比如sarama和kafka-go
消息队列使用指南
在集成消息队列之前,我们先要知道:有那些部件需要集成消息队列?在某个地方集成消息队列的意义是什么?集成消息队列时要注意什么?特别不能为了用消息队列而用消息队列
我们已经知道,消息队列的作用是削峰限流、异步通信和服务间解耦,那么我们在集成消息队列时也应该围绕这几方面进行集成
下面我们以一个最简单的微服务举例,该微服务项目只包含用户模块、帖子模块和互动模块,且只有用户登录、注册、获取/更新信息 | 帖子发布、删除、获取/更新信息 | 互动的点赞帖子、关注用户等api,具体无关的业务细节我们省略掉
那么我们就要设计消息路径:当发生用户注册等事件时,封装事件消息到消息队列,帖子服务接收该消息并创建欢迎帖子。当发生点赞事件时,封装事件消息到消息队列,帖子服务和用户服务接收消息并更新帖子/用户信息...
为了让消费者知道消息具体指向的方法,我们需要在消息中封装Event,并把不同的方法逻辑封装为不同的Event关键字,通俗的说,我们需要让消费者听懂消息内容
例如,我们想让post-service接收到来自user-service的注册消息,就创建event字段USER_REGISTERED,当post-service监听到主题为user的消息并解析到event为USER_REGISTERED时,实现对应方法
在这样的一个微服务项目里集成消息队列,我们可以先写一个消息队列公共方法包:
公共方法包
这里我们使用kafka-go,并学习DaWeSen大佬的pkg写法
package mq

import (
	"context"
	"fmt"
	"log"
	"sync"
	"time"

	"github.com/segmentio/kafka-go"
	"github.com/segmentio/kafka-go/compress"
)

// 生产者结构体
type Producer struct {
	writer *kafka.Writer
	topics map[string]string
	mu     sync.RWMutex
}

// 消费者结构体
type Consumer struct {
	reader *kafka.Reader
	topic  string // 记录消费的主题
	group  string // 记录消费者组
}

// 消息结构体
type Message struct {
	Topic     string    `json:"topic"`     // 主题
	Key       string    `json:"key"`       // 消息键
	Value     []byte    `json:"value"`     // 消息体
	Partition int       `json:"partition"` // 分区
	Offset    int64     `json:"offset"`    // 偏移量
	Time      time.Time `json:"time"`      // 时间戳
	Headers   []Header  `json:"headers"`   // 消息头
}

// 消息头结构
type Header struct {
	Key   string `json:"key"`
	Value string `json:"value"`
}

// 生产者单例实例
var (
	producerInstance *Producer
	producerOnce     sync.Once
	initErr          error // 记录初始化错误
)

type KafkaCfg struct {
	Brokers []string
	Topics   Topic
	Version string
}

type Topic struct {
	user string
	post string
}

// 获取生产者单例
func NewProducer() (*Producer, error) {
	producerOnce.Do(func() {
		kafkaConfig := &KafkaCfg{
			Brokers: []string{"127.0.0.1:9092"},
			Topics:   Topic{user: "user-events", post: "post-events"},
			Version: "2.8.0",
		}

		// 验证配置
		if len(kafkaConfig.Brokers) == 0 {
			initErr = fmt.Errorf("KafkaCfg brokers配置为空")
			return
		}

		// 初始化生产者
		producerInstance, initErr = initProducer(kafkaConfig.Brokers, kafkaConfig.Version)
		if initErr != nil {
			log.Printf("初始化Kafka生产者失败: %v", initErr)
			return
		}

		// 缓存主题映射
		producerInstance.topics = map[string]string{
			"user":        kafkaConfig.Topics.user,
			"post":        kafkaConfig.Topics.post,
		}

		// 异步创建主题(不阻塞启动)
		go func() {
			ctx, cancel := context.WithTimeout(context.Background(), 30*time.Second)
			defer cancel()

			if err := createTopics(ctx, *kafkaConfig); err != nil {
				log.Printf("异步创建Kafka主题失败: %v", err)
			} else {
				log.Println("Kafka主题创建/验证完成")
			}
		}()
	})

	return producerInstance, initErr
}

// 初始化生产者
func initProducer(brokers []string, version string) (*Producer, error) {
	// 创建Kafka Writer配置
	writer := &kafka.Writer{
		Addr:         kafka.TCP(brokers...),  // 连接地址
		Balancer:     &kafka.Hash{},          // 使用哈希分区,确保不同消费者获取自己的消息
		RequiredAcks: kafka.RequireAll,       // 需要所有副本确认
		MaxAttempts:  3,                      // 最大重试次数
		WriteTimeout: 10 * time.Second,       // 写超时
		ReadTimeout:  10 * time.Second,       // 读超时
		Async:        false,                  // 同步发送(保证顺序)
		Compression:  compress.Snappy,        // 压缩,减少网络流量
		BatchSize:    100,                    // 批量大小
		BatchBytes:   1048576,                // 1MB,控制内存
		BatchTimeout: 100 * time.Millisecond, // 批次超时
	}

	return &Producer{
		writer: writer,
		topics: make(map[string]string),
	}, nil
}

// 创建消费者
func NewConsumer(topic string, groupID string) (*Consumer, error) {
	kafkaConfig := &KafkaCfg{
		Brokers: []string{"127.0.0.1:9092"},
		Topics:   Topic{user: "user-events", post: "post-events"},
		Version: "2.8.0",
	}

	// 验证配置
	if len(kafkaConfig.Brokers) == 0 {
		return nil, fmt.Errorf("KafkaCfg brokers配置为空")
	}

	// 消费者组名处理
	if groupID == "" {
		groupID = fmt.Sprintf("consumer-group-%d", time.Now().UnixNano())
	}

	// 创建Kafka Reader配置
	reader := kafka.NewReader(kafka.ReaderConfig{
		Brokers:         kafkaConfig.Brokers,
		Topic:           topic,
		GroupID:         groupID,
		MinBytes:        10e3,              // 10KB,减少小消息的网络开销
		MaxBytes:        10e6,              // 10MB,避免大消息内存溢出
		MaxWait:         1 * time.Second,   // 调整:减少等待时间
		ReadLagInterval: -1,                // 不检查消费延迟
		StartOffset:     kafka.FirstOffset, // 从最早开始消费
		CommitInterval:  1 * time.Second,   // 提交偏移量间隔
		QueueCapacity:   100,               // 内部队列容量
	})

	return &Consumer{
		reader: reader,
		topic:  topic,
		group:  groupID,
	}, nil
}

// 发送消息到指定主题
func (p *Producer) Send(ctx context.Context, topic string, key string, value []byte, headers ...Header) error {
	// 验证参数
	if topic == "" {
		return fmt.Errorf("主题不能为空")
	}

	// 转换消息头格式
	kafkaHeaders := make([]kafka.Header, 0, len(headers))
	for _, h := range headers {
		kafkaHeaders = append(kafkaHeaders, kafka.Header{
			Key:   h.Key,
			Value: []byte(h.Value),
		})
	}

	// 构建Kafka消息
	msg := kafka.Message{
		Topic:   topic,
		Key:     []byte(key),
		Value:   value,
		Headers: kafkaHeaders,
		Time:    time.Now(), // 设置消息时间戳
	}

	// 发送消息
	err := p.writer.WriteMessages(ctx, msg)
	if err != nil {
		return fmt.Errorf("发送消息到主题[%s]失败: %w", topic, err)
	}

	// 记录日志
	log.Printf("消息发送成功: topic=%s, key=%s, size=%d bytes",
		topic, key, len(value))
	return nil
}

// 发送带重试的消息
func (p *Producer) SendWithRetry(ctx context.Context, topic string, key string, value []byte, maxRetries int, headers ...Header) error {
	var lastErr error

	for i := 0; i < maxRetries; i++ {
		err := p.Send(ctx, topic, key, value, headers...)
		if err == nil {
			return nil
		}

		lastErr = err
		log.Printf("发送消息重试 %d/%d: %v", i+1, maxRetries, err)

		// 指数退避策略
		waitTime := time.Duration(1<<i) * 100 * time.Millisecond
		if waitTime > 5*time.Second {
			waitTime = 5 * time.Second
		}

		select {
		case <-time.After(waitTime):
			continue
		case <-ctx.Done():
			return ctx.Err()
		}
	}

	return fmt.Errorf("发送消息失败,重试%d次后放弃: %w", maxRetries, lastErr)
}

// 获取主题名称(带缓存)
func (p *Producer) getTopic(topicType string) (string, error) {
	p.mu.RLock()
	topic, exists := p.topics[topicType]
	p.mu.RUnlock()

	if exists {
		return topic, nil
	}

	// 从配置重新加载
	kafkaConfig := &KafkaCfg{
		Brokers: []string{"127.0.0.1:9092"},
		Topics:   Topic{user: "user-events", post: "post-events"},
		Version: "2.8.0",
	}

	p.mu.Lock()
	defer p.mu.Unlock()

	// 重新检查(双重检查锁模式)
	if topic, exists = p.topics[topicType]; exists {
		return topic, nil
	}

	// 从配置映射获取
	switch topicType {
	case "user":
		topic = kafkaConfig.Topics.user
	case "post":
		topic = kafkaConfig.Topics.post
	default:
		return "", fmt.Errorf("未知的主题类型: %s", topicType)
	}

	p.topics[topicType] = topic
	return topic, nil
}

// 以下是各种事件类型的便捷发送方法

func (p *Producer) SendUserEvent(ctx context.Context, key string, value []byte, headers ...Header) error {
	topic, err := p.getTopic("user")
	if err != nil {
		return err
	}
	return p.Send(ctx, topic, key, value, headers...)
}

func (p *Producer) SendPostEvent(ctx context.Context, key string, value []byte, headers ...Header) error {
	topic, err := p.getTopic("post")
	if err != nil {
		return err
	}
	return p.Send(ctx, topic, key, value, headers...)
}

// 批量发送消息
func (p *Producer) SendBatch(ctx context.Context, topic string, messages []Message) error {
	if len(messages) == 0 {
		return nil
	}

	kafkaMessages := make([]kafka.Message, 0, len(messages))
	for _, msg := range messages {
		kafkaHeaders := make([]kafka.Header, 0, len(msg.Headers))
		for _, h := range msg.Headers {
			kafkaHeaders = append(kafkaHeaders, kafka.Header{
				Key:   h.Key,
				Value: []byte(h.Value),
			})
		}

		kafkaMessages = append(kafkaMessages, kafka.Message{
			Topic:   topic,
			Key:     []byte(msg.Key),
			Value:   msg.Value,
			Headers: kafkaHeaders,
			Time:    msg.Time,
		})
	}

	err := p.writer.WriteMessages(ctx, kafkaMessages...)
	if err != nil {
		return fmt.Errorf("批量发送消息失败: %w", err)
	}

	log.Printf("批量消息发送成功: topic=%s, count=%d", topic, len(messages))
	return nil
}

// 接收消息
func (c *Consumer) Receive(ctx context.Context) (*Message, error) {
	// 设置读取超时
	readCtx, cancel := context.WithTimeout(ctx, 5*time.Second)
	defer cancel()

	msg, err := c.reader.ReadMessage(readCtx)
	if err != nil {
		if err == context.DeadlineExceeded {
			// 读取超时,不是错误
			return nil, nil
		}
		return nil, fmt.Errorf("读取消息失败: %w", err)
	}

	// 转换消息头
	headers := make([]Header, 0, len(msg.Headers))
	for _, h := range msg.Headers {
		headers = append(headers, Header{
			Key:   h.Key,
			Value: string(h.Value),
		})
	}

	return &Message{
		Topic:     msg.Topic,
		Key:       string(msg.Key),
		Value:     msg.Value,
		Partition: msg.Partition,
		Offset:    msg.Offset,
		Time:      msg.Time,
		Headers:   headers,
	}, nil
}

// 批量接收消息
func (c *Consumer) ReceiveBatch(ctx context.Context, maxMessages int) ([]*Message, error) {
	if maxMessages <= 0 {
		maxMessages = 100
	}

	messages := make([]*Message, 0, maxMessages)

	for i := 0; i < maxMessages; i++ {
		msg, err := c.Receive(ctx)
		if err != nil {
			return messages, err
		}

		if msg == nil {
			break // 没有消息了
		}

		messages = append(messages, msg)
	}

	return messages, nil
}

// 手动提交偏移量
func (c *Consumer) CommitOffset(ctx context.Context) error {
	return c.reader.CommitMessages(ctx)
}

// 获取消费者状态
func (c *Consumer) GetStatus() map[string]interface{} {
	stats := c.reader.Stats()
	return map[string]interface{}{
		"topic":     c.topic,
		"group":     c.group,
		"dials":     stats.Dials,
		"messages":  stats.Messages,
		"bytes":     stats.Bytes,
		"errors":    stats.Errors,
		"timeouts":  stats.Timeouts,
		"lag":       stats.Lag,
		"partition": stats.Partition,
		"offset":    stats.Offset,
	}
}

// 关闭生产者
func (p *Producer) Close() error {
	if p.writer != nil {
		return p.writer.Close()
	}
	return nil
}

// 关闭消费者
func (c *Consumer) Close() error {
	if c.reader != nil {
		return c.reader.Close()
	}
	return nil
}

// 创建主题
func createTopics(ctx context.Context,kafkaConfig KafkaCfg) error {

	log.Printf("开始创建Kafka主题,brokers: %v", kafkaConfig.Brokers)

	// 连接到Kafka
	conn, err := kafka.Dial("tcp", kafkaConfig.Brokers[0])
	if err != nil {
		log.Printf("连接Kafka失败: %v", err)
		return err
	}
	defer conn.Close()

	// 获取集群控制器
	controller, err := conn.Controller()
	if err != nil {
		log.Printf("获取Kafka控制器失败: %v", err)
		return err
	}

	// 连接到控制器
	controllerConn, err := kafka.Dial("tcp", fmt.Sprintf("%s:%d", controller.Host, controller.Port))
	if err != nil {
		log.Printf("连接Kafka控制器失败: %v", err)
		return err
	}
	defer controllerConn.Close()

	// 主题配置
	topicConfigs := []kafka.TopicConfig{
		{
			Topic:             kafkaConfig.Topics.user,
			NumPartitions:     3, // 增加分区数
			ReplicationFactor: 1,
		},
		{
			Topic:             kafkaConfig.Topics.post,
			NumPartitions:     6, // 分区更多
			ReplicationFactor: 1,
		},
	}

	// 创建主题
	createdCount := 0
	for _, tc := range topicConfigs {
		// 检查主题是否已存在
		partitions, err := controllerConn.ReadPartitions(tc.Topic)
		if err == nil && len(partitions) > 0 {
			log.Printf("主题已存在: %s (分区数: %d)", tc.Topic, len(partitions))
			continue
		}

		// 创建主题
		err = controllerConn.CreateTopics(tc)
		if err != nil {
			log.Printf("创建主题 %s 失败: %v", tc.Topic, err)
			// 继续创建其他主题
			continue
		}

		log.Printf("主题创建成功: %s (分区数: %d, 副本数: %d)",
			tc.Topic, tc.NumPartitions, tc.ReplicationFactor)
		createdCount++
	}

	log.Printf("主题创建完成: 总数=%d, 成功=%d", len(topicConfigs), createdCount)
	return nil
}
以上的公共包包含一键创建主题、并封装了生产者的消费者,还分别为生产者和消费者封装了创建单例、(单次/批量)发送/接受消息、获取主题等方法
这样,在api-gateway/main中一键创建主题后,只需要在各服务中注入kafkaProducer *mq.Producer或kafkaConsumer *mq.Consumer依赖并序列化包装eventData并调用SendUserEvent等方法即可实现消息队列各功能的使用
业务示例
在生成/消费消息前,我们需要分析/构建各模块的消息作用关系
以上面所说的用户&帖子微服务为例,我们在用户注册后应该为用户创建示例帖子/欢迎帖子,或者在用户点赞他人帖子后更新帖子信息和被点赞用户的信息,我们就可以在用户注册后发送user主题的消息并封装相应信息,让post-service接受该消息并创建欢迎文章,或在点赞后发送interaction主题的消息并封装相应信息,让post-service和user-service接收消息并更新帖子/用户信息
生产者
需要注意的是,我们一般在service层发送消息
以user-service为例,在service层发送消息:
// 注册新用户
func (s *userServiceImpl) Register(ctx context.Context, username, password, avatar, about string) (*model.User, string, error) {
	logger.Info("用户注册请求",
		logger.StringField("username", username),
		logger.StringField("about", about))

	existingUser, err := s.repo.FindByUsername(ctx, username)
	if err != nil {
		logger.Error("查询用户失败",
			logger.ErrorField(err),
			logger.StringField("username", username))
		return nil, "", ErrInternalServer
	}
	if existingUser != nil {
		logger.Warn("用户名已存在",
			logger.StringField("username", username))
		return nil, "", ErrUsernameExists
	}

	hashedPassword, err := bcrypt.GenerateFromPassword([]byte(password), bcrypt.DefaultCost)
	if err != nil {
		logger.Error("密码加密失败",
			logger.ErrorField(err),
			logger.StringField("username", username))
		return nil, "", ErrInternalServer
	}
	user := &model.User{
		Username: username,
		Password: string(hashedPassword),
		Avatar:   avatar,
		About:    about,
	}

	if err := s.repo.Create(ctx, user); err != nil {
		logger.Error("创建用户失败",
			logger.ErrorField(err),
			logger.StringField("username", username))
		return nil, "", ErrInternalServer
	}

	token, err := s.jwtManager.GenerateToken(user.ID)
	if err != nil {
		logger.Error("生成令牌失败",
			logger.ErrorField(err),
			logger.Int64Field("user_id", user.ID))
		return nil, "", ErrInternalServer
	}

	// 生产者发送消息
	if s.kafkaProducer != nil {
		eventData, _ := json.Marshal(map[string]interface{}{
            "event_type":    "USER_REGISTERED",  // 明确的事件类型
			"user_id":       user.ID,
			"username":      user.Username,
			"registered_at": time.Now(),
			"avatar":        user.Avatar,
			"about":         user.About,
		})
		s.kafkaProducer.SendUserEvent(ctx, fmt.Sprintf("%d", user.ID), eventData)
		logger.Info("发送用户注册事件",
			logger.Int64Field("user_id", user.ID))
	}

	logger.Info("用户注册成功",
		logger.Int64Field("user_id", user.ID),
		logger.StringField("username", username))

	return user, token, nil
}
消费者
在存在消费者的service中注入消费者依赖,并创建启动消费者方法,异步监听消息。在监听到消息是判别消息事件类型并根据具体类型实现具体消费方法
package service

import (
    "context"
    "encoding/json"
    "fmt"
    "log"
    "time"

    "shortvideo/user-service/internal/repository"
    "shortvideo/user-service/pkg/mq"
)

type UserService struct {
    repo     *repository.UserRepository
    producer *mq.Producer
    consumer *mq.Consumer
    stopChan chan struct{}  // 控制消费者停止
}

func NewUserService(repo *repository.UserRepository, producer *mq.Producer) *UserService {
    return &UserService{
        repo:     repo,
        producer: producer,
        stopChan: make(chan struct{}),
    }
}

// 启动消费者(在main中调用)
func (s *UserService) StartConsumer(topic, groupID string) error {
    // 创建消费者
    consumer, err := mq.NewConsumer(topic, groupID)
    if err != nil {
        return fmt.Errorf("创建消费者失败: %v", err)
    }

    s.consumer = consumer

    // 启动goroutine消费
    go s.consumeLoop()

    log.Printf("消费者启动: topic=%s, group=%s", topic, groupID)
    return nil
}

// 消费者主循环
func (s *UserService) consumeLoop() {
    for {
        select {
        case <-s.stopChan:
            log.Println("消费者停止")
            return
        default:
            ctx, cancel := context.WithTimeout(context.Background(), 5*time.Second)

            // 接收消息
            msg, err := s.consumer.Receive(ctx)
            cancel()

            if err != nil {
                if err == context.DeadlineExceeded {
                    // 读取超时,继续循环
                    continue
                }
                log.Printf("接收消息失败: %v", err)
                time.Sleep(1 * time.Second)
                continue
            }

            if msg == nil {
                time.Sleep(100 * time.Millisecond)
                continue
            }

            // 处理消息
            go s.processMessage(msg)
        }
    }
}

// 处理消息
func (s *UserService) processMessage(msg *mq.Message) {
    // 解析消息
    var data map[string]interface{}
    if err := json.Unmarshal(msg.Value, &data); err != nil {
        log.Printf("解析消息失败: %v", err)
        return
    }

    // 获取事件类型
    eventType, ok := data["event_type"].(string)
    if !ok {
        log.Printf("消息格式错误: 缺少event_type")
        return
    }

    // 根据事件类型调用已有的Service方法
    ctx := context.Background()

    switch eventType {
    case "POST_CREATED":
        // 调用具体业务
    case "POST_DELETED":
		// 调用具体业务
    case "POST_LIKED":
		// 调用具体业务
    default:
        log.Printf("未知事件类型: %s", eventType)
    }
}

// 停止消费者
func (s *UserService) StopConsumer() {
    if s.consumer != nil {
        close(s.stopChan)
        s.consumer.Close()
    }
}
进阶
以上,我们就完成了在项目中集成基础的消息队列的功能
进一步来说,我们有多种方法进行消息队列的优化,比如死信队列、处理消息堆积等
消息队列的进阶部分,之后会详细讲解,现在暂且按下不表
评论
留言与讨论 ↗欢迎留下想法或问题。这里承接旧站已有评论。
正在加载评论…