引言
我们继续学习微服务架构中极其重要的一个环节-分布式事务。在单体式架构中,保证数据库读写ACID原则的情况下,我们往往不需要对数据的强一致性过多担心。但是在分布式架构中,不同服务节点对数据库的并发访问就很可能会带来新的一致性问题,例如两个用户在同一瞬间完成下单操作,服务器同事处理这两个请求,不足库存就会超卖。分布式事务作为微服务体系中的重要内容,可以保障不同服务或不同服务节点之间难以保证的数据一致性
数据一致性
数据一致性是分布式事务中最重要的核心理念,它表示在分布式系统的多个节点或服务中,数据副本之间保持统一和正确的状态,使得用户或程序在任何时刻、从任何节点读取数据时,都能获得符合预期的、逻辑上正确的结果
数据一致性并不是所谓非黑即白的“一致”或“不一致”,而是可以根据不同实际情况不同划分结果,是一个从绝对严格到非常宽松的谱系。我们根据这个谱系,可以将数据一致性划从严格到宽松分为三个级别:“强一致性”、“顺序一致性”和“最终一致性”
在深入了解数据一致性之前,我们先讲解一些必备的知识概念
分布式理论
CAP理论
CAP定理指出,在一个可能发生网络分区的分布式系统中,无法同时完美满足以下三点:
- Consistency (一致性):强调数据的正确性,要求各节点提供的数据都是一致准确的
- Availability (可用性):要求系统的可用性高,每个请求都能得到响应(不保证是最新数据)
- Partition Tolerance (分区容错性):系统在部分网络节点失联(分区)时,要求系统仍然能够正常运作
对于分布式系统而言,网络分区(P)是必然存在的,因此,我们只能在一致性(C)和可用性(A)之间二选一
而这种一致性(C)和可用性(A)之间的二选一,产生了两种主要的系统类型:CP和AP
CP系统选择放弃部分可用性以保证一致性,当网络分区发生时,系统会锁定数据或返回错误,直到分区恢复、数据达成一致,以保证数据绝对正确
AP系统选择放弃强一致性以保证更高可用性,当网络分区发生时,系统允许继续读写,但不同分区间的数据可能暂时不一致
一般而言,一致性的实现更加复杂,可用性的实现更加简便
需要特别说明的是,一个系统并不是一定需要极端CP或极端AP,更多时候是依据具体的业务情况来决定倾向于一致性还是可用性。例如对于用户的个人信息或帖子的统计数据,我们不需要对这些信息立即更新或者实时响应,就可以舍弃部分一致性,以简化业务代码,提升可用性。对于用户转账之类的业务,我们就需要保证数据的强一致性,舍弃部分可用性,为用户返回“正在更新信息,请稍候”之类的讯息
由此可见,我们之前所说的“强一致性”或“最终一致性”系统就是更加偏向于CP或者AP的系统
BASE理论
由上述理论我们可以知道,CP系统的实现相对复杂,因此对于非严格业务(如统计信息、边缘业务等),我们主要使用AP模式模型,而BASE理论则提供了在AP道路上如何尽可能好地走下去的具体方法论,是对强一致性模型的补充和妥协
BASE理论的核心思想是:既然无法做到强一致,就用一种更柔和、更具弹性的方式,通过接受暂时的、可控的不一致,来换取系统整体的高可用和可扩展性
BASE全称 Basically Available, Soft state, Eventually consistent(基本可用、软状态、最终一致性)
BA(基本可用):系统在出现故障时,允许损失部分非核心功能的可用性,但核心功能必须保持可用
如降级、熔断、限流:双十一期间,关闭商品评价功能,确保下单、支付核心链路畅通
S(软状态):允许系统中的数据存在中间状态,并且该状态不会影响系统整体可用性
数据副本在不同节点间同步存在延迟,这个“不一致的窗口期”就是软状态。比如主数据库写入成功,从数据库还未同步完成
E - 最终一致性:经过一段时间的同步后,所有数据副本最终会达到一致的状态
这是BASE的最终目标。系统保证,只要没有新的更新,最终所有读取都会返回最新的值
分布式ID
分布式ID是在分布式系统环境下,用于唯一标识一条数据、一个请求或一个实体的全局唯一标识符,是构建分布式系统的基石之一
我们为什么需要分布式ID?
在单机数据库时代,使用数据库的自增字段(AUTO_INCREMENT)就足够了。但在分布式系统中,这会导致一些严重问题:
当所有插入都依赖一个数据库的自增序列,数据库可能会成为单点性能瓶颈;分库分表时,不同数据库节点会产生重复ID;连续的自增ID会暴露业务量(如订单数),容易被爬取
因此,分布式ID可以在全局方位作唯一的ID标识,并满足以下核心要求:
- 全局唯一:作为基本要求,整个系统不出现重复ID
- 趋势递增:可用作数据库索引(例如数据库主键)
- 高可用:ID生成服务必须高度可靠
- 高并发:能应对海量请求
- 安全:ID本身无敏感信息,无序或难以猜测
分布式ID是在分布式系统环境下,用于唯一标识一条数据、一个请求或一个实体的全局唯一标识符。它是构建分布式系统的基石之一。
常见的分布式ID生成方案如下,其中以雪花算法(Snowflake)最为广泛应用:
| 方案 | 原理 | 优点 | 缺点 | 典型代表 |
|---|---|---|---|---|
| UUID | 基于随机数、时间、MAC地址等生成128位字符串。 | 1. 本地生成,性能极高。 2. 全球唯一性概率极高。 |
1. 字符串存储,占用空间大。 2. 无序,作为主键插入数据库时性能差。 3. 无业务含义。 |
UUID.randomUUID() |
| 数据库自增 | 单独一个数据库实例,利用其自增机制生成ID。 | 1. 实现简单。 2. ID绝对有序递增。 |
1. 数据库单点,有性能瓶颈和故障风险。 2. 扩展性差。 |
单独一个MySQL表 |
| Redis生成 | 利用Redis的 INCR 或 INCRBY 原子命令生成序列。 |
1. 性能优于数据库。 2. 数字ID,有序。 |
1. 需引入和运维Redis。 2. 存在数据持久化问题(宕机可能丢失序列)。 |
Redis INCR 命令 |
| 雪花算法 | 最流行的方案。将一个64位Long型ID按位划分,包含时间戳、工作机器ID、序列号。 | 1. 本地生成,性能超高。 2. 趋势递增,对数据库友好。 3. 可包含时间信息。 |
1. 依赖系统时钟,如果时钟回拨会导致ID重复。 2. 需要分配和管理机器ID。 |
Twitter Snowflake, 百度UidGenerator |
| 号段模式 | 从数据库批量获取一个号段(如1~1000)缓存在本地,用完后再次获取。 | 1. 数据库压力小(批量获取)。 2. 本地生成,性能好。 |
1. 服务重启可能浪费号段。 2. ID不是严格连续,是趋势递增。 |
美团Leaf(Segment模式) |
雪花算法
雪花算法基于时间戳生成分布式ID: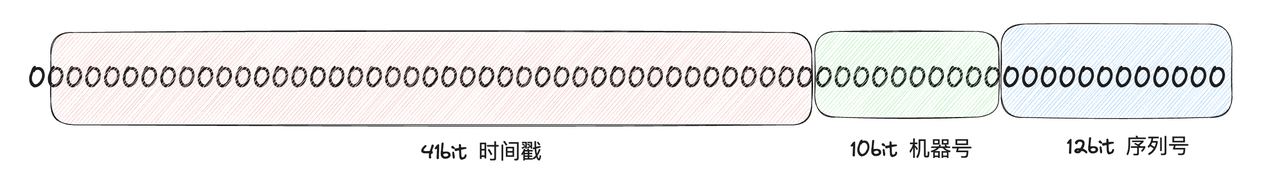
- 第1位:符号位,固定为0(表示正数)
- 接下来41位:时间戳(毫秒级),可用约69年
- 接下来10位:工作机器ID,其中5位是数据中心ID,5位是机器ID,可部署1024个节点
- 最后12位:序列号,同一毫秒内产生的自增序列,支持每节点每毫秒生成4096个ID
生成过程:在同一毫秒内,如果请求并发量超过4096,会等待下一毫秒。这保证了ID在单节点上是严格递增的,全局是趋势递增的
但是即便如此,雪花算法还是面临一些问题,例如时间回拨问题:时间被调整回到了之前的时间。由于雪花算法重度依赖机器的当前时间,所以一旦发生时间回拨,将有可能导致生成的 ID 可能与此前已经生成的某个 ID 重复(前提是刚好在同一毫秒生成 ID 时序列号也刚好一致),这就是雪花算法最经常讨论的时间回拨问题
不过,我们依然可以用基于时钟序列的方法解决时间回拨问题,详细细节参考此篇文章:雪花算法的详解及时间回拨解决方案
在实际项目中,我们可以直接使用成熟的开源实现(如美团的Leaf、百度的UidGenerator),它们已经解决了时钟回拨、机器ID分配等问题
分布式锁
其实我们早已在之前的单体式项目实践中接触过分布式锁,不过我们只是单纯以redis的setnx作简单的分布式锁实现,这里我们会更拓展一点
在分布式系统中,不同服务运行在不同机器上,我们需要一个跨进程的全局分布式锁,用于协调多个进程/服务对共享资源进行互斥访问的机制
分布式锁是分布式系统中,用于协调多个进程/服务对共享资源进行互斥访问的机制。在单机系统中,你可以用线程锁(如Go的sync.Mutex)保证同一时刻只有一个线程访问资源。但在分布式系统中,不同服务运行在不同机器上,就需要一个跨进程的全局锁。
主流的分布式锁实现方案如下
| 方案 | 核心原理 | 优点 | 缺点 | 适用场景 |
|---|---|---|---|---|
| 基于数据库 | 利用唯一约束或乐观锁版本号实现。 | 实现简单,无需引入新组件。 | 性能差,数据库压力大;连接数有限;锁释放需处理。 | 并发量低,已有数据库的场景。 |
| 基于Redis | 使用SET key value NX PX timeout命令实现。 |
性能极高,实现相对简单。 | 主从切换时可能锁失效(Redlock算法可缓解)。 | 高并发,可容忍极低概率锁失效的场景。 |
| 基于ZooKeeper | 创建临时顺序节点,最小节点获得锁。 | 可靠性高,无锁失效问题;原生支持公平锁。 | 性能较Redis低;需要维护ZK集群。 | 对可靠性要求极高,如金融交易。 |
| 基于etcd | 基于租约创建Key,利用Revision机制。 | 强一致,高可靠;支持公平锁。 | 相比Redis性能略低。 | Kubernetes生态,对一致性要求高的场景。 |
接下来我们着重对Redis分布式锁和ETCD分布式锁进行详解
Redis分布式锁
在我们之前的单体式项目中已经使用过,通过redis的setnx(set if not exist)命令实现分布式锁,我们在此基础上进阶讲解分布式系统中使用分布式锁会遇到的诸多问题的解决方案
Redis分布式锁是AP倾向的
死锁
如果一个程序获取到了分布式锁,但是在执行业务代码,还没来得及释放锁时这个程序就挂掉了,这个分布式锁就会一致锁住,造成死锁
我们可以在获取锁时为锁添加一个过期时间,来避免死锁的发生。需要注意的是,这个过程必须是原子操作(或用lua实现),否则在没来得及设置过期时间时挂掉也会造成死锁
锁续期(WatchDog机制)
如果一个程序业务执行时间超过了锁的过期时间,在业务还没来得及执行完锁就被释放了,会导致其他进程获取这个锁,导致多线程并发访问数据造成数据不一致。因此我们通常使用WatchDog续期机制为未执行完业务的程序的锁续约:
func lock(){
    setnx key1 val1 ex {exTime}
    go func{
        for holdingLock {
            // 每10秒续期一次
            time.Sleep(10 * time.Second)
			// 使用Lua脚本,只有还是自己的锁才续期
			redis.Eval("if redis.call('get', KEYS[1]) == ARGV[1] then "+
				"return redis.call('pexpire', KEYS[1], ARGV[2]) "+
				"else return 0 end",
				[]string{lockKey}, clientID, 30000)
        }
    }()
}
同理,如果在释放锁时锁就已经过期了,就会导致释放新拿到锁的线程的锁。因此,我们可以在释放锁前判断是否时自己加的锁
func unlock(){
  if getKey() == myVal{
    del key
  }
}
Redis集群
在此之前我们可能只部署了单节点Redis,这样做会导致低可用性,如果这个单节点Redis挂了,那么整个缓存层就全挂了,导致数据库压力激增造成业务熔断。因此我们在分布式架构中多部署redis集群,实现多个redis节点的部署(通常为3主3从)
Redis集群由16384个哈希槽组成,槽位分配给集群中的主节点,例如在3主集群中,节点1占槽 0-5460,节点2占槽 5461-10922,节点3占槽 10923-16383,每个键通过 CRC16 算法计算后对 16384 取模,得到槽位。每个新键值对都会进行这样的运算并被分配给相应槽位的集群节点进行缓存存储
每个Redis集群都有多个Redis节点,每个Redis节点也会有不同节点身份,通常为Master(主节点)和Slave(从节点)两个节点身份。Master节点负责处理其负责槽的所有读写命令,并参与集群管理(故障检测、投票);Slave节点作为主节点的完整副本,通过异步复制同步主节点数据,可以在主节点故障时,通过选举接替其成为新的主节点,并接管对应的槽。 一个主节点可以有多个从节点,实现读写分离和更高等级的可靠性
集群没有中心化的管理节点。所有节点通过 Gossip 协议彼此互联,定期交换以下信息:
- MEET/PING/PONG 消息:用于节点发现、心跳检测和元数据传播。每个节点每秒会随机选择几个节点发送 PING,并交换集群状态
- FAIL 消息:当某个节点判定另一个节点下线时,会向整个集群广播 FAIL 消息,触发故障转移流程
这种去中心化设计避免了单点故障,但意味着集群状态变更的传播有轻微延迟
客户端与集群交互的关键是请求路由机制。当客户端命中正确节点,客户端(如 go-redis)在启动时就会拉取一份“槽位-节点映射表”并缓存。当要操作 Key 时,它本地计算槽位,并直接连接负责该槽位的节点,让请求被直接处理。
而当客户端连接了错误节点或迁移中的槽位,可能返回两类错误:
- MOVED 错误:如果槽位已永久迁移到另一个节点,当前节点会返回
-MOVED <slot> <target-node-ip:port>错误。智能客户端会更新本地映射表,然后重试请求到新节点 - ASK 错误:发生在槽位迁移过程中。当前节点可能有一部分Key已迁走,一部分还在。如果请求的Key已迁走,它会返回
-ASK <slot> <target-node-ip:port>错误,这是一个临时重定向。客户端需要向新节点发送一个 ASKING命令,然后才能执行原命令。这确保了迁移期间的可用性
Redis集群由完全自动化的故障检测与自动故障转移机制:
- 主观下线:节点 A 在
cluster-node-timeout内未收到节点 B 的 PONG 响应,则节点 A 将节点 B 标记为 PFAIL(疑似下线) - 客观下线:节点 A 通过 Gossip 协议发现集群中大多数主节点都认为节点 B 处于 PFAIL状态。此时,节点 A 会向集群广播一个 FAIL消息,正式将节点 B 标记为客观下线
- 从节点选举:
- 当主节点 B 被标记为客观下线后,其下属的从节点会发起选举
- 从节点会延迟一段时间(与复制偏移量有关,数据越新的延迟越小)后发起投票请求
- 其他存活的主节点进行投票,获得多数票的从节点获胜
- 故障转移:获胜的从节点执行
SLAVEOF no one升级为主节点,并通过广播通知集群,接管原主节点负责的所有哈希槽
需要注意的是,Redis集群不支持多键操作:涉及多个Key的命令(如 MGET, MSET, SINTER)要求所有Key必须位于同一个节点。需用 {}哈希标签强制它们落入同一槽,如:
MSET user:{1000}:name “Alice” user:{1000}:age 30。同样的,事务和脚本中所有操作的Key也必须属于同一个槽
我们可以使用官方的github.com/go-redsync/redsync/v4包实现redis集群的链接和使用:
import "github.com/go-redsync/redsync/v4"

func main() {
    // 创建多个 Redis 连接池
    pools := []redsync.Pool{
        redis.NewPool(redisClient1),
        redis.NewPool(redisClient2),
        redis.NewPool(redisClient3),
        redis.NewPool(redisClient4),
        redis.NewPool(redisClient5),
    }

    // 创建 RedLock 实例
    rs := redsync.New(pools)

    // 获取锁
    mutex := rs.NewMutex("resource-name",
        redsync.WithExpiry(10*time.Second),
        redsync.WithTries(3), // 重试次数
    )

    if err := mutex.Lock(); err != nil {
        // 处理错误
    }

    // 执行业务操作
    defer mutex.Unlock()
}
RedLock算法
为什么需要RedLock算法?
在单个集群的主从架构中,可能存在以下问题:
- 客户端 A 在主节点 M1 上成功获取锁
- Master节点 M1 在将锁信息同步到从节点 S1 之前崩溃
- Slave节点 S1 被提升为新的主节点
- 此时新的主节点上没有锁信息
- 客户端 B 向新的主节点请求同一把锁,成功获取
- 结果:A 和 B 同时持有同一把锁 → 锁失效
这就是 RedLock 要解决的核心问题:防止因 Redis 主从切换导致的锁意外失效
算法详解
RedLock使用多个(奇数个)不同的独立Redis实例(如不同的Redis集群的Master节点),所有实例都是独立的不进行数据同步
算法基本流程如下:
- 获取锁:
- 当客户端尝试获取锁时,向集群中的多个 Redis 实例发送锁请求
- 每个请求包含一个唯一的锁标识符(例如,UUID)和一个过期时间
- 客户端尝试在所有实例上几乎同时获取锁
- 锁获取规则:
- 如果客户端在大多数(比如,N/2 + 1,其中 N 是总的实例数)的 Redis 实例上成功设置了锁,并且获取锁的总耗时小于锁的有效期,那么被认为成功获取了锁
- 如果客户端未能在大多数实例上获得锁,立即从那些设置了锁的实例上释放(删除)锁
- 锁的释放:
- 当锁的持有者完成其任务后,向所有实例发送解锁命令,释放锁
- 时间和时钟漂移:
- 重要的是要确保所有 Redis 实例的时钟尽可能同步
- 客户端应该考虑网络延迟和小的时钟漂移
原理简介
多数决
假设有 N 个实例,最多允许 f 个实例故障:
- 正确性要求:不能有两个客户端同时获得多数锁
- 可用性要求:即使有 f 个实例故障,客户端仍可能获得锁
因为客户端需要获得至少 ⌈N/2⌉ + 1 个锁才能获取锁,而由于
2 × (⌈N/2⌉ + 1) > N,所有两个客户端不可能同时满足这个条件有效期
实际有效时间 = 初始TTL - 获取锁总耗时
确保客户端在获得锁时,所有实例上的锁都还有剩余时间
轮子
"github.com/bsm/redislock"提供了专门的Redis集群分布式锁包与相关API
ETCD分布式锁
我们之前学习注册中心的时候就接触过etcd,一个键值对存储系统,有着独特的租约(lease)机制
etcd 分布式锁是基于 etcd 的强一致性特性实现的分布式锁机制。与 Redis 的 AP 倾向不同,etcd 是 CP 系统(优先保证一致性和分区容错性),使用 Raft 共识算法,所有写操作必须经过多数节点确认才成功
并且,etcd由独特的Revision 机制:etcd 中每个键都有全局单调递增的 Revision ,锁竞争时,所有客户端可以按照 Revision 顺序获得锁,实现完全公平的 FIFO 队列
我们知道有个概念叫做惊群效应:倘若一把分布式锁的竞争比较激烈,那么锁的释放事件可能同时被多个的取锁方所监听,一旦锁真的被释放了,所有的取锁方都会一拥而上尝试取锁
得益于etcd的Revision机制,对于同一把分布式锁,锁记录数据的 key 拥有共同的前缀 prefix,作为锁的标识,
每个取锁方取锁时,会以锁前缀 prefix 拼接上自身的身份标识(租约 id),生成完整的 lock key. 因此各取锁方完整的 lock key 都是互不相同的(只是有着相同的前缀),理论上所有取锁方都能成功把锁记录数据插入到 etcd 中。
每个取锁方插入锁记录数据时,会获得自身 lock key 处在锁前缀 prefix 范围下唯一且递增的版本号 revision。
取锁方插入加锁记录数据不意味着加锁成功,而是需要在插入数据后查询一次锁前缀 prefix 下的记录列表,判定自身 lock key 对应的 revision 是不是其中最小的,如果是的话,才表示加锁成功。
如果锁被他人占用,取锁方会 watch 监听 revision 小于自己但最接近自己的那个 lock key 的删除事件。
这样所有的取锁方就会在 revision 机制的协调下,根据取锁序号revision的先后顺序排成一条队列,每当锁被释放,只会惊动到下一顺位的取锁方,惊群问题得以避免.
而etcd分布式锁的实现如下所示:
1. 客户端创建会话(Session)
   ↓
2. 会话绑定租约(Lease),设置TTL
   ↓
3. 发起事务(Txn)尝试创建锁键
   ├─ 成功: 获得锁,启动租约自动续期
   └─ 失败: 监听前一个Revision的删除事件
        ↓
        等待并重试(公平排队)
   ↓
4. 执行业务逻辑
   ↓
5. 释放锁(删除键)
   ↓
6. 关闭租约,释放资源
我们可以使用官方的clientv3/concurrency包快速使用etcd分布式锁的功能:
import (
    "go.etcd.io/etcd/client/v3"
    "go.etcd.io/etcd/client/v3/concurrency"
)

func main() {
    // 连接 etcd
    cli, err := clientv3.New(clientv3.Config{
        Endpoints:   []string{"localhost:2379"},
        DialTimeout: 5 * time.Second,
    })

    // 创建会话(自动绑定租约)
    session, err := concurrency.NewSession(cli,
        concurrency.WithTTL(10)) // 10秒TTL

    // 创建互斥锁
    mutex := concurrency.NewMutex(session, "/my-lock/")

    // 获取锁(阻塞直到成功)
    ctx, cancel := context.WithTimeout(context.Background(), 30*time.Second)
    defer cancel()

    if err := mutex.Lock(ctx); err != nil {
        // 处理错误(超时或其他)
    }

    // 执行业务操作
    fmt.Println("获得锁,执行业务逻辑")

    // 释放锁
    defer mutex.Unlock(context.Background())
}

// 重入锁(同一客户端可多次加锁)
func reentrantExample(session *concurrency.Session) {
    mutex := concurrency.NewMutex(session, "/reentrant-lock")

    // 第一次加锁
    mutex.Lock(ctx)

    // 同一 goroutine 可以再次调用(实际不会阻塞)
    doWorkWithLock(mutex)

    mutex.Unlock(ctx)
}

// 读写锁
func rwLockExample(session *concurrency.Session) {
    // 创建读写锁
    rwlock := concurrency.NewRWMutex(session, "/rw-lock")

    // 读锁(共享)
    err := rwlock.RLock(ctx)
    // 多个客户端可同时持有读锁

    // 写锁(独占)
    err = rwlock.Lock(ctx) // 等待所有读锁释放
}
我们也可以进一步使用etcd的watch机制,实现类似于watch dog的死锁解决方案
分布式事务
我们都知道,在单体式架构中,事物用于保证数据库操作的原子性。而在分布式架构中,分布式事务就是用来保证别位于不同的分布式系统节点上的事务的参与者、支持事务的服务器、资源服务器以及事务管理器这些节点上的操作要么全部成功,要么全部失败
同时,在分布式系统下,传统的ACID(原子性,一致性,隔离性,持久性)面临巨大挑战:原子性不能保证多个独立系统如何保证"全成功或全失败",一致性不能保证多个数据源如何保持逻辑一致,隔离性的跨服务并发控制极其复杂,持久性的日志不能保证全部节点全部成功
本质上来说,分布式事务就是为了保证在分布式场景下,数据操作的正确执行
而分布式事务由多个核心方案:
2PC
2PC能保证数据的强一致性,偏向CP,且依赖数据库
我们通常将服务称之为事物的参与者,除此之外,我们通常还需要实现一个事物的协调者。2PC机制由两个阶段完成:
- 第一阶段(PreCommit):事物协调者会通知所有的事物参与者是否准备好,事物参与者接受通知后会开启各自事物并执行相关业务操作,但并不提交事务,而是在提交事务前全局阻塞自身进程
- 第二阶段(DoCommit):若第一阶段正常结束,则事物协调者通知所有事物参与者进行事物提交。否则,第一阶段时事物参与者发生异常或超时,事物协调者会通知所有事物参与者执行回滚操作
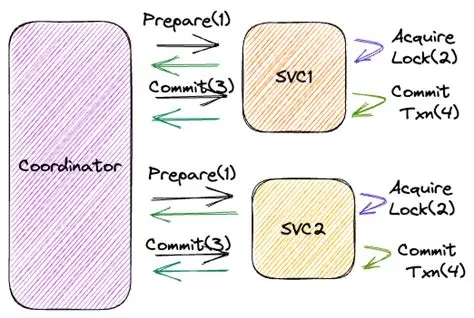
2PC带来的问题是,在第一阶段会造成整个事物的全局阻塞,进而影响系统的整体性能。且若当发生异常情况,会浪费系统资源,比如在第一阶段某个参与者发生异常,会造成其他参与者的系统资源被浪费。或当协调者宕机时,所有的参与者资源会一直锁定。且若第二阶段协调者发送部分提交后崩溃,仍有数据不一致风险,且性能开销大,在准备阶段和提交阶段需要两次网络通信,增加了延迟
2PC能保证数据的强一致性
3PC
3PC在2PC的基础上,多出了一个“询问”阶段(CanCommit),在该阶段,事物协调者会询问各个事物参与者是否存在,各个参与者收到消息后立刻返回自己是否可用,不发送任何业务逻辑,也不锁定资源。之后再进入常规的2PC机制(PreCommit&DoCommit)
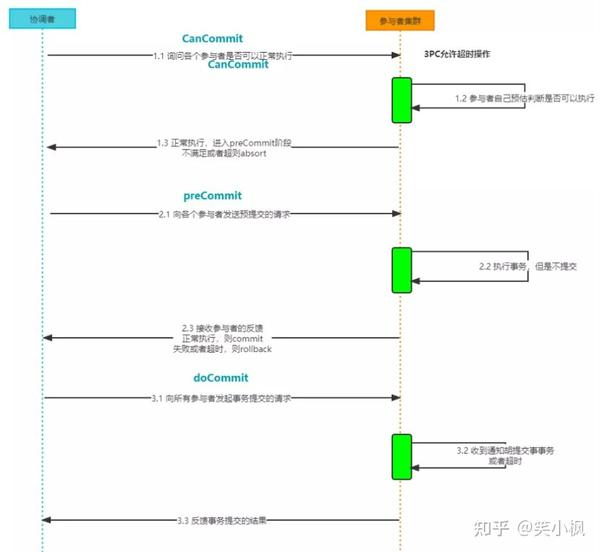
这样的机制能避免在某个参与者不可用的情况下造成的资源浪费,减少资源锁定时间,降低阻塞。但并未解决2PC机制的全部痛点
TCC
TCC机制是Try、Confirm、Cancel的缩写,类似2PC,但阻塞粒度更小,更依赖代码逻辑而非数据库,且保证最终一致性,倾向AP
TCC同样分为两步:
- 第一阶段(Try):事物协调者通知所有事物参与者尝试运行自身业务内容,进行资源的预处理(比如创建标记为“enable:false”的订单、对“冻结数据”进行增减而非真实数据)以排查一切可能的错误
- 第二阶段(Confirm):事物协调者通知所有事物参与者将预处理的数据实际执行(例如将enable设置为true,将“冻结库存”-1,将“库存”+1)
- 异常阶段(Cancel):当第一阶段由事物参与者产生异常,事物协调者对所有事物参与者通知Cancel信息,将第一阶段的改动回滚
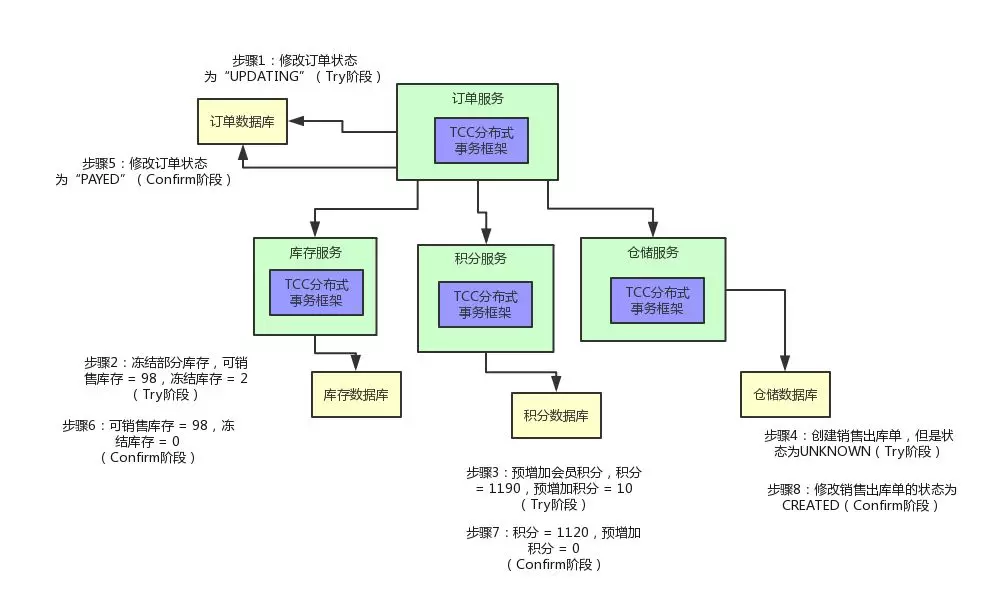
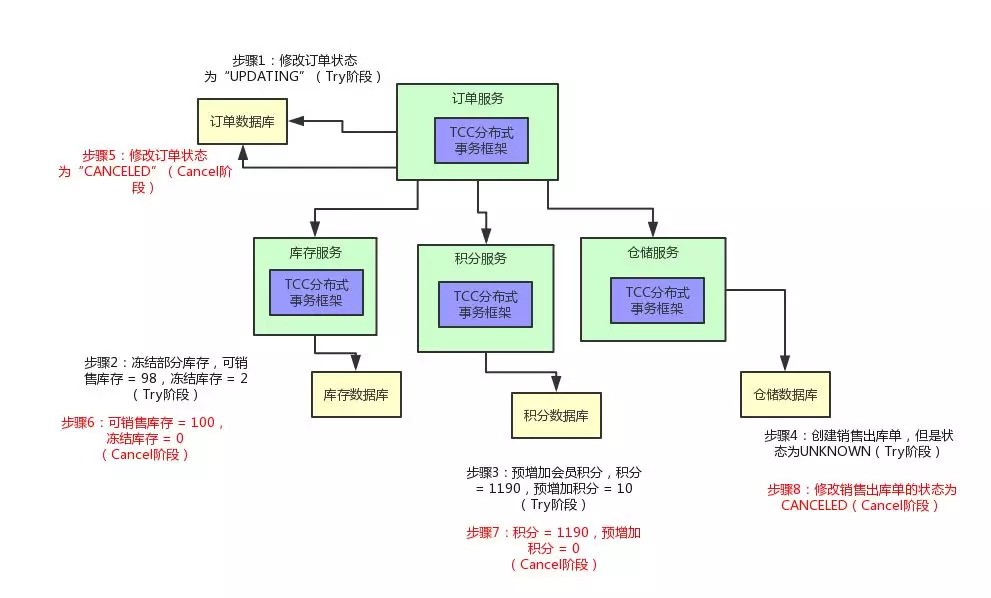
TCC能防止线程阻塞,性能更好(只在短时间内持有资源锁),但只能保证最终一致性,更适合高并发场景,同时TCC也会为业务编写增加复杂度(需要手动实现Try等方法)
本地消息表
本地消息表也是保证数据最终一致性(AP)的一个方案,利用本地数据库的事务能力,将业务操作和消息记录绑定在同一个事务中,通过异步重试确保消息最终被消费,从而实现业务与下游操作的最终一致性
本地事物表机制的实现如下,需要我们额外设计消息表数据库存储消息的元数据:
原子写入业务消息:
开启本地数据库事务,执行业务主操作(例如在orders表中插入一条新订单记录),并在同一个事务中,向本地消息表插入一条消息记录,记录消息ID(唯一标识)、业务类型和业务ID、消息内容(通常是JSON格式,包含下游服务需要的数据)、状态(初始为待发送)、重试次数(初始为0)等。之后提交事务,并保证业务数据和消息记录要么同时成功,要么同时失败,保证“业务完成”和“通知下游”这两个操作的原子性
异步消息投递:
在独立的定时任务(或线程)中扫描本地消息表,找出状态为待发送的记录,并将消息内容发送到消息队列。如果发送成功,将本地消息表中的该条记录状态更新为已发送,否则记录重试次数并等待下次重试(通常会设置最大重试次数和指数退避策略)
下游服务幂等消费:
下游服务从消息队列消费消息,并保证消费业务实现幂等逻辑。通常根据消息ID或业务唯一键检查是否已处理过。如果已处理,直接确认消息,避免重复操作。如果未处理,则执行相应的业务逻辑,并在本地记录处理完成的状态,消费成功后,向MQ确认消息
最终一致性的达成
经过上述流程,只要消息最终被成功消费,业务主系统(订单)和下游系统(库存)的状态就会达成一致。由于是异步过程,中间会有一个短暂的不一致窗口(订单已创建,但库存还未扣)。但能在最后保证数据一致(最终一致性)
消息事物
事务消息是 RocketMQ 提供的事务功能,可以由消息中间件提供的特殊机制,确保消息发送与本地业务事务具备“类2PC”的原子性:即消息要么随业务成功而最终被投递,要么随业务失败而被撤回,支持生产者在执行本地事务后决定消息的最终状态(提交或回滚),实现分布式事务,从而保证数据的最终一致性
在接触消息事物之前,我们先来了解一下RocketMQ。
RocketMQ 的事务消息基于以下设计:
- 半消息(Half Message):生产者发送的消息首先作为“半消息”存储在 Broker 中,对消费者不可见。Broker 会先等待生产者确认消息状态(提交或回滚)
- 事务状态检查:如果生产者未及时确认,Broker 会定时回查生产者的事务状态,决定消息是提交(对消费者可见)还是回滚(丢弃)
- API 支持:RocketMQ 提供了专门用于发送和管理事务消息的API并处理本地事务逻辑
- 存储与可靠性:事务消息会存储在 Broker 的专用队列中,记录事务状态日志,确保高可用性和一致
而事物消息的完整实现流程如下:
发送半消息(Half Message)并执行业务:
生产者发送“半消息”到MQ Broker。这种消息对消费者是不可见的,它只是暂存在Broker上,用于后续确认
MQ Broker持久化半消息后,向生产者返回“发送成功”
生产者在本地执行业务事务(如订单入库)
生产者根据本地事务的执行结果,向MQ Broker发送二次确认(Commit或Rollback):
如果本地事务成功,发送Commit,半消息将变为正式消息,对消费者可见。
如果本地事务失败,发送Rollback,MQ Broker将删除半消息。
事务状态回查
如果MQ Broker长时间未收到生产者的二次确认(例如生产者宕机),MQ会主动向生产者发起事务状态回查
生产者需要实现一个“事务状态回查监听器”和回调函数(Callback)。当收到回查请求时,它必须去检查本地事务的实际状态(例如查询订单表是否存在对应的订单)
生产者根据检查结果,再次向Broker返回Commit或Rollback指令,Broker据此决定消息的最终结果
消息消费
一旦消息被Commit,其流程就与普通消息一致:对消费者可见,被消费,并保证至少投递一次。
消费者同样需要实现幂等消费
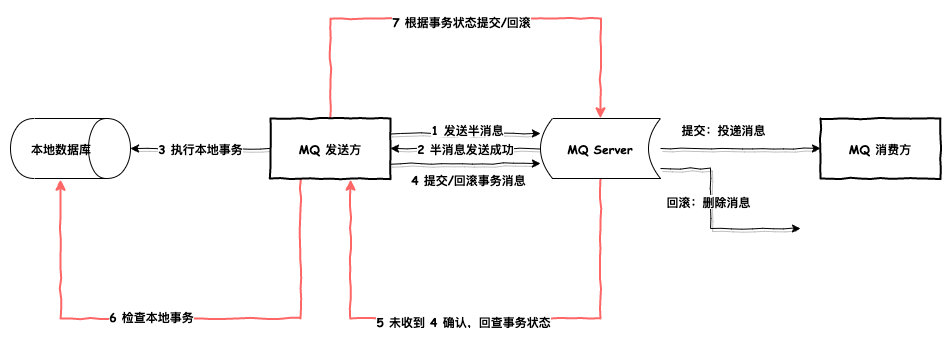
这样,业务系统和消息队列便像两个人握手合作,共同保证了原子性
Saga模式
Saga模式就是将一个庞大的分布式事务拆解为一系列按顺序执行的本地子事务。每个子事务都有对应的补偿操作。通过正向执行和反向补偿,保证整个业务链的最终一致性
Saga由两种实现模式:协同式和编排式
协同式:
事务编排与启动
- Saga协调器(Orchestrator)接收到一个业务请求(例如:“预订旅行套餐”)
- 协调器根据预定义的Saga流程,编排出一个子事务执行序列。例如:
- T1: 预订酒店
- T2: 预订机票
- T3: 租车
正向执行流程(Try-Phase)
- 协调器向“酒店服务”发送执行T1的命令。
- 酒店服务执行本地事务(在酒店库存中预留一个房间)。成功后向协调器报告成功
- 协调器收到T1成功,接着向“机票服务”发送执行T2的命令
- 机票服务执行本地事务(锁定一个航班座位)。成功后向协调器报告成功
- 协调器收到T2成功,接着向“租车服务”发送执行T3的命令
失败与补偿流程(Compensate-Phase)
- 假设租车服务执行T3失败(无车可租),它向协调器报告失败
- 协调器开始启动补偿流程,顺序与正向执行相反
- 协调器首先向“机票服务”发送补偿C2的命令(要求取消之前锁定的航班座位)
- 机票服务执行补偿操作C2(释放座位)。成功后报告
- 协调器收到C2成功,接着向“酒店服务”发送补偿C1的命令(要求取消预留的房间)
- 酒店服务执行补偿操作C1(释放房间)。成功后报告
- 至此,所有已完成的步骤都被撤销,系统状态恢复到事务开始前。协调器向客户端返回业务失败
成功流程
- 如果所有子事务(T1, T2, T3)都成功,协调器则标记整个Saga事务成功,并向客户端返回成功
由此可见,Saga可靠性的根源,依赖于每个参与者本地事务的可靠性,以及补偿操作的正确设计和执行。其关键设计补偿事务(Compensating Transaction)不是简单的回滚,而是一个业务上的逆向操作(如“取消预订”而非“删除记录”)
Saga保证最终一致性,倾向AP
一致性共识算法
虽然我们在项目内部并不会直接手搓一致性共识算法,但是我们有时会接触到相关思想,而且学习这部分对分布式系统的认知也是很重要的
要介绍一致性共识算法,我们引用一篇技术文章里的解释:
在分布式系统中,为了消除单点提高系统可用性,通常会使用副本来进行容错,但这会带来另一个问题,即如何保证多个副本之间的一致性?
所谓的强一致性(线性一致性)并不是指集群中所有节点在任一时刻的状态必须完全一致,而是指一个目标,即让一个分布式系统看起来只有一个数据副本,并且读写操作都是原子的,这样应用层就可以忽略系统底层多个数据副本间的同步问题。也就是说,我们可以将一个强一致性分布式系统当成一个整体,一旦某个客户端成功的执行了写操作,那么所有客户端都一定能读出刚刚写入的值。即使发生网络分区故障,或者少部分节点发生异常,整个集群依然能够像单机一样提供服务。
共识算法(Consensus Algorithm)就是用来做这个事情的,它保证即使在小部分(≤ (N-1)/2)节点故障的情况下,系统仍然能正常对外提供服务。共识算法通常基于状态复制机(Replicated State Machine)模型,也就是所有节点从同一个 state 出发,经过同样的操作 log,最终达到一致的 state
一致性共识算法有很多,其中又以Paxos共识算法以及在Paxos基础上诞生的Raft共识算法最为出名,我们熟知的etcd内部就是基于Raft共识算法实现的
若想详解Raft共识算法,在短篇幅内是很难完成的,看之后有时间的话我再单独开一片来单开文章剖析一下Raft和Paxos这俩共识算法
这里我们就Raft讲讲最基础的部分,以及对一致性共识算法进行一个笼统的概念解释:
在Raft算法中存在一个集群,集群中的节点由三种身份:Leader、Follower和Candidate,且整个集群中同一时期内最多只存在一个Leader节点
Raft通过三大核心机制达成数据一致性:选主(Leader election)、日志复制(Log replication)、安全性(Safety)
同时,Raft还有两个安全机制:集群身份变更和日志压缩。有关更多Raft的部分不做讲解,短篇幅内实在难以详尽讲解,且我们也不希望用流水账一般的文字对Raft囫囵吞枣,所以此处不再过度深入Raft了
关于Raft的详细讲解可以看这篇文章,可以说是易懂而且讲的很全面很透彻:深度解析 Raft 分布式一致性协议
还有这篇关于Paxos的:一致性算法Paxos
配置中心
配置中心在分布式系统中是一个独立的、中心化的服务器系统,也是分布式系统架构中的一个核心组件,用于在多个服务实例、多个环境中,高效、一致、安全地管理配置,并且能在配置变更时,实时或准实时地通知到所有相关服务,而无需重启服务
在我们之前写单体式项目时已经接触过Viper这个配置管理工具包,但是在分布式系统中,每个服务都有自己的数据库dsn,端口映射或业务内部键等这种配置文件和字段,当服务数量达到几十个甚至上百个时,我们使用viper和本地配置文件修改和管理配置会异常麻烦,为了解决分布式系统配置管理的痛点、区分不同环境的配置项以及热更新配置(Viper也有),我们遇到了配置中心
配置中心能够统一管理配置(配置项的修改编辑统一在配置中心页面进行,还包括统一的配置版本管理、环境隔离、灰度发布以及热发布,在不重启应用的情况下使得修改的配置可以生效起作用)、统一控制权限(控制配置的读取权限以及修改权限,通过统一的权限管理提升运维效率)和统一审计操作(记录用户操作修改配置的历史信息,这样在出现问题的时候可以进行复盘回查,同时进行操作审计)
当然,即使引入了配置中心,我们还是需要使用viper获取部分引导配置,如配置中心的地址和端口
常见配置中心有Nacos、Apollo等,我们这里讲解一下Nacos配置中心
我们可以使用docker快速开启Nacos服务:
docker run -d --name nacos -p 8848:8848 --privileged=true -e JVM_XMS=256m -e JVM_XMX=256m -e MODE=standalone nacos/nacos-server:latest启动后访问 http://127.0.0.1:8848/nacos/ 即可访问Nacos控制台
关于在Go里集成Nacos,可见这篇文章:go集成nacos配置中心并读取配置信息
DTM
在Go语言中也有一些出名的分布式事务框架,比如DTM,Seata。这里我们着重介绍DTM
DTM是一款开源的分布式事务管理器,解决跨数据库、跨服务、跨语言栈更新数据的一致性问题
通俗一点说,DTM提供跨服务事务能力,一组服务要么全部成功,要么全部回滚,避免只更新了一部分数据产生的一致性问题
需要注意的是,DTM本身只是一个分布式事务管理框架,只为我们提供分布式事务相关功能实现,其他功能例如分布式锁,配置中心和接口幂等性内容还需要我们手动实现
而DTM本身为我们提供了多种分布式事务模式,例如SAGA,TCC,XA和消息事物等
例如我们使用SAGA模式在项目中实践分布式事务,这就需要我们为每个参与服务实现一个正向操作接口和一个对应的补偿操作接口(若项目为三层架构则在service层进行),并对接口进行幂等性改造
快速开始:
// 具体业务微服务地址
const qsBusi = "http://localhost:8081/api/busi_saga"
req := &gin.H{"amount": 30} // 微服务的载荷
// DtmServer为DTM服务的地址,是一个url
DtmServer := "http://localhost:36789/api/dtmsvr"
saga := dtmcli.NewSaga(DtmServer, shortuuid.New()).
// 添加一个TransOut的子事务,正向操作为url: qsBusi+"/TransOut", 补偿操作为url: qsBusi+"/TransOutCompensate"
Add(qsBusi+"/TransOut", qsBusi+"/TransOutCompensate", req).
// 添加一个TransIn的子事务,正向操作为url: qsBusi+"/TransIn", 补偿操作为url: qsBusi+"/TransInCompensate"
Add(qsBusi+"/TransIn", qsBusi+"/TransInCompensate", req)
// 提交saga事务,dtm会完成所有的子事务/回滚所有的子事务
err := saga.Submit()
整个事务最终成功完成,时序图如下: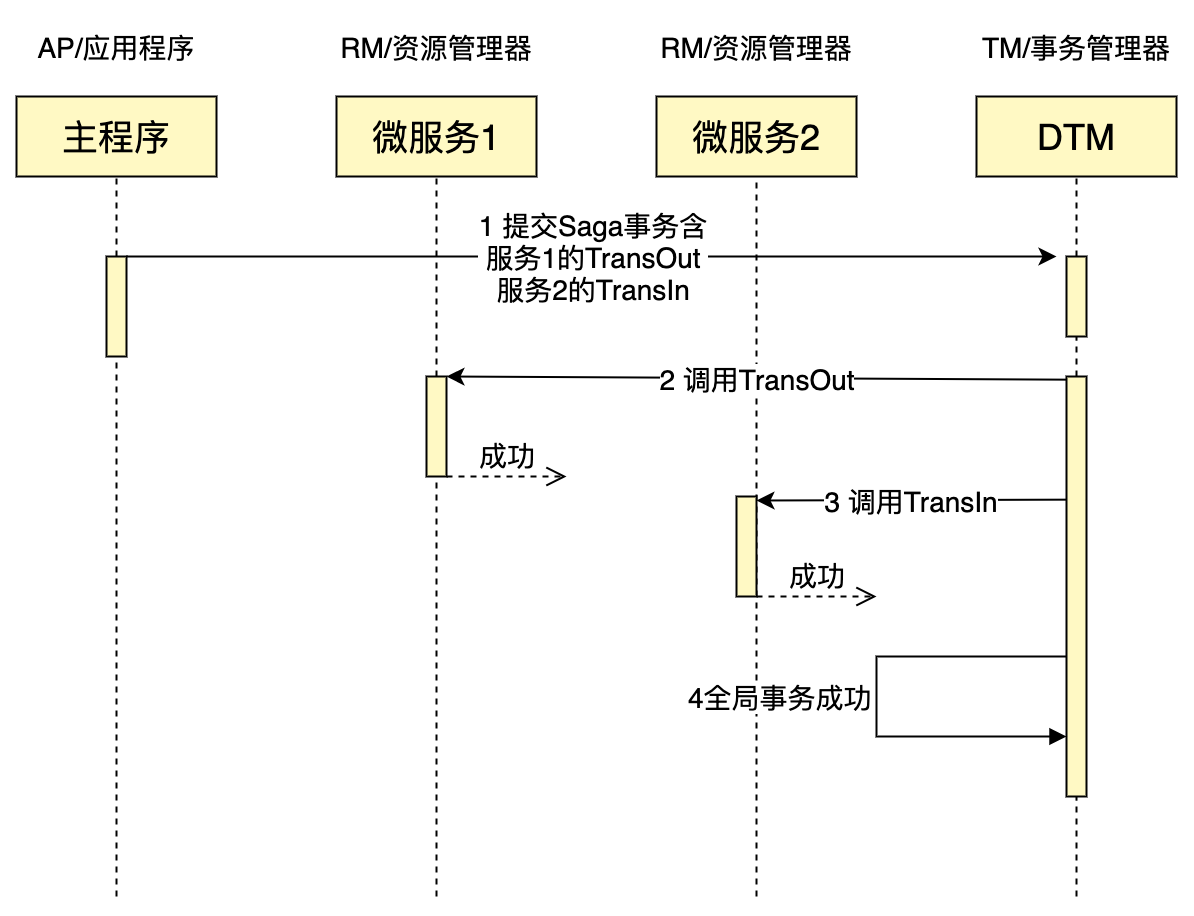
这是一个在go-zero框架下的微服务项目集成dtm的示例:go-zero实战: 11 分布式事务 DTM
后记
分布式事务可以说是分布式系统里最重要,也是较复杂的一个环节。我居然花了三天来弄完这方面的内容(其实有两天摆了半天),不过把这部分搞完让我对分布式系统的理解有了质的飞跃,博客也是突破了万字长文。特别是Raft共识算法这部分。之后打算把之前微服务的demo集成一下redis集群和分布式锁,加上配置中心,再用上dtm和SAGA进行分布式事务管理。在这之后学习一下DDD架构,就算这一大板块的结束吧,K8s之后再说,先学习AI agent,感觉各方面落后了一大截
评论
留言与讨论 ↗欢迎留下想法或问题。这里承接旧站已有评论。
正在加载评论…