引言
紧接上回,服务治理也是微服务中不可或缺的一环,能够保障有多个独立服务构成的复杂系统能稳定、可靠、高效且可控地运行
服务治理
负载均衡
均衡发展策略通常在服务发现时作为一种服务选择策略进行使用
概念
将外部请求或内部服务调用,智能地分发到多个服务实例上。这能避免单个实例过载,充分利用集群资源,提高系统的整体吞吐量和响应速度,是实现水平扩展的基础
实现
负载均衡机制有多重基础策略算法选择
加权随机
核心思想:完全随机的选择,每个实例被选中的概率 = 权重 / 总权重
适用场景:大部分无状态服务,最简单高效
func RandomSelect(instances []Instance) Instance {
    // 计算总权重
    totalWeight := 0
    for _, instance := range instances {
        totalWeight += instance.Weight
    }

    // 生成随机数 [0, totalWeight)
    random := rand.Intn(totalWeight)

    // 按权重区间选择
    current := 0
    for _, instance := range instances {
        current += instance.Weight
        if random < current {
            return instance
        }
    }
    return instances[0]
}

// 核心逻辑:权重越高,在数轴上的区间越长,被选中的概率越大
// 权重5:区间长度5
// 权重3:区间长度3
// 权重2:区间长度2
// 随机数落在哪个区间,就选哪个实例
轮询
核心思想:轮流分配请求,保证绝对公平
适用场景:需要流量均匀分配的服务
普通加权轮询
type WeightedRoundRobin struct {
    servers []*WeightedServer
    mu      sync.Mutex
}

type WeightedServer struct {
    Server   string
    Weight   int
    Current  int  // 已分配次数
}

func (wrr *WeightedRoundRobin) Next() string {
    wrr.mu.Lock()
    defer wrr.mu.Unlock()

    if len(wrr.servers) == 0 {
        return ""
    }

    // 查找权重使用次数最少的服务器
    var selected *WeightedServer
    totalWeight := 0

    for _, server := range wrr.servers {
        totalWeight += server.Weight

        // 如果这个服务器的已分配次数 < 权重
        if server.Current < server.Weight {
            if selected == nil || server.Current < selected.Current {
                selected = server
            }
        }
    }

    // 如果找到了合适的服务器
    if selected != nil {
        selected.Current++
        return selected.Server
    }

    // 如果所有服务器都达到了权重限制,重置计数器
    for _, server := range wrr.servers {
        server.Current = 0
    }

    // 重新选择
    return wrr.Next()
}

// 示例运行(权重 A:3, B:2, C:1):
// 初始状态: A:0/3, B:0/2, C:0/1
// 第1次: 选A → A:1/3
// 第2次: 选B → B:1/2
// 第3次: 选A → A:2/3
// 第4次: 选C → C:1/1
// 第5次: 选A → A:3/3
// 第6次: 选B → B:2/2
// 第7次: 所有服务器达到权重,重置 → A:0/3, B:0/2, C:0/1
// 第8次: 重新开始循环
平滑加权轮询算法(Nginx算法)
该算法也是Nginx内部使用的默认负载均衡算法,保证了策略的平滑性,权重高的服务器不会连续收到大量请求,时间复杂度为O(n)
package loadbalancer

import (
    "sync"
)

// 服务器节点定义
type SmoothWeightedServer struct {
    Server    string
    Weight    int           // 固定权重
    Current   int           // 当前权重(动态变化)
    Effective int           // 有效权重(可用于健康检查降权)
}

// 平滑加权轮询负载均衡器
type SmoothWeightedRoundRobin struct {
    servers []*SmoothWeightedServer
    mu      sync.RWMutex
    total   int           // 总权重缓存
}

// 创建新的负载均衡器
func NewSmoothWeightedRoundRobin() *SmoothWeightedRoundRobin {
    return &SmoothWeightedRoundRobin{
        servers: make([]*SmoothWeightedServer, 0),
    }
}

// 添加服务器
func (swrr *SmoothWeightedRoundRobin) AddServer(server string, weight int) {
    swrr.mu.Lock()
    defer swrr.mu.Unlock()

    swrr.servers = append(swrr.servers, &SmoothWeightedServer{
        Server:    server,
        Weight:    weight,
        Current:   0,
        Effective: weight,
    })

    // 更新总权重
    swrr.total += weight
}

// 核心算法实现
func (swrr *SmoothWeightedRoundRobin) Next() string {
    swrr.mu.Lock()
    defer swrr.mu.Unlock()

    if len(swrr.servers) == 0 {
        return ""
    }

    // 遍历所有服务器,增加当前权重
    best := swrr.servers[0]
    bestIndex := 0

    for i, server := range swrr.servers {
        // 增加当前权重(使用有效权重)
        server.Current += server.Effective

        // 选择当前权重最大的服务器
        if server.Current > best.Current {
            best = server
            bestIndex = i
        }
    }

    // 被选中的服务器减去总权重
    best.Current -= swrr.total

    return best.Server
}
// 假设有3个服务器:
// 服务器A: 权重=3, 初始Current=0
// 服务器B: 权重=2, 初始Current=0
// 服务器C: 权重=1, 初始Current=0
// 总权重 = 3+2+1 = 6

// 第1次选择:
// 步骤1: 所有服务器增加权重
//   A: 0+3=3
//   B: 0+2=2
//   C: 0+1=1
// 步骤2: 选择当前权重最大的 → A(3)
// 步骤3: 被选中的A减去总权重 → A: 3-6 = -3
// 结果: 选择A,状态: A=-3, B=2, C=1

// 第2次选择:
// 步骤1: 所有服务器增加权重
//   A: -3+3=0
//   B: 2+2=4
//   C: 1+1=2
// 步骤2: 选择当前权重最大的 → B(4)
// 步骤3: 被选中的B减去总权重 → B: 4-6 = -2
// 结果: 选择B,状态: A=0, B=-2, C=2

// 第3次选择:
// 步骤1: 所有服务器增加权重
//   A: 0+3=3
//   B: -2+2=0
//   C: 2+1=3
// 步骤2: 选择当前权重最大的 → A和C都是3,选第一个(A)
// 步骤3: 被选中的A减去总权重 → A: 3-6 = -3
// 结果: 选择A,状态: A=-3, B=0, C=3

// 第4次选择:
// 步骤1: 所有服务器增加权重
//   A: -3+3=0
//   B: 0+2=2
//   C: 3+1=4
// 步骤2: 选择当前权重最大的 → C(4)
// 步骤3: 被选中的C减去总权重 → C: 4-6 = -2
// 结果: 选择C,状态: A=0, B=2, C=-2

// 第5次选择:
// 步骤1: 所有服务器增加权重
//   A: 0+3=3
//   B: 2+2=4
//   C: -2+1=-1
// 步骤2: 选择当前权重最大的 → B(4)
// 步骤3: 被选中的B减去总权重 → B: 4-6 = -2
// 结果: 选择B,状态: A=3, B=-2, C=-1

// 第6次选择:
// 步骤1: 所有服务器增加权重
//   A: 3+3=6
//   B: -2+2=0
//   C: -1+1=0
// 步骤2: 选择当前权重最大的 → A(6)
// 步骤3: 被选中的A减去总权重 → A: 6-6 = 0
// 结果: 选择A,状态: A=0, B=0, C=0 (回到初始状态)

// 6次请求分配结果: A, B, A, C, B, A
// 符合权重比例: A:3次, B:2次, C:1次
// 而且分布很平滑: 没有连续3次A,而是穿插分配
最少链接策略
核心思想:选择当前连接数最少的服务器
适用场景:长连接服务,如数据库连接池、WebSocket
// 实现思路:
func LeastConnectionsSelect(instances []Instance) Instance {
    var best Instance
    minConnections := math.MaxInt32

    for _, instance := range instances {
        // 获取当前连接数
        conns := instance.GetCurrentConnections()

        // 选择连接数最少的
        if conns < minConnections {
            minConnections = conns
            best = instance
        }
    }

    return best
}
IP哈希
核心思想:相同来源的请求总是路由到同一实例
适用场景:需要会话保持的服务,如用户登录状态
package iphash

import (
    "crypto/sha1"
    "encoding/binary"
    "net"
    "strings"
    "sync"
)

type IPHashLoadBalancer struct {
    instances []string
    mu        sync.RWMutex
}

func NewIPHash(instances []string) *IPHashLoadBalancer {
    return &IPHashLoadBalancer{
        instances: instances,
    }
}

// 核心哈希函数
func (lb *IPHashLoadBalancer) hashIP(ip string) uint32 {
    h := sha1.New()
    h.Write([]byte(ip))
    hashBytes := h.Sum(nil)

    // 取前4个字节作为32位整数
    return binary.BigEndian.Uint32(hashBytes[:4])
}

// 选择实例
func (lb *IPHashLoadBalancer) GetInstance(clientIP string) string {
    lb.mu.RLock()
    defer lb.mu.RUnlock()

    if len(lb.instances) == 0 {
        return ""
    }

    // 核心逻辑:哈希取模
    hash := lb.hashIP(clientIP)
    index := hash % uint32(len(lb.instances))

    return lb.instances[index]
}
一致性哈希
核心思想:构建哈希环,请求映射到环上最近的节点
适用场景:缓存服务、分布式存储
内部由红黑平衡树实现,红黑树是一种自平衡的二叉查找树
红黑树的特性:
根节点必须是黑色, 红色节点不能有红色子节点(没有连续红色), 从任意节点到其叶子节点的所有路径,黑色节点数必须相同, 每个叶子节点(NIL)都是黑色
这种特性决定了红黑树总是平衡,且具有良好的查找效率
在Go中可以用
github.com/emirpasic/gods/trees/redblacktree获取红黑树实例红黑树或其他数据结构与算法在后面单开模块讲解
package consistenthash

import (
    "fmt"
    "hash/fnv"
    "strconv"
    "sync"

    rbt "github.com/emirpasic/gods/trees/redblacktree"
)

//  一致性哈希结构
type ConsistentHash struct {
    virtualNodes int                  // 每个物理节点的虚拟节点数
    hashFunc     func(string) uint32 // 哈希函数
    ring         *rbt.Tree           // 红黑树,存储虚拟节点
    nodeMap      map[string]bool     // 记录物理节点
    mu           sync.RWMutex
}

// 创建一致性哈希实例
func NewConsistentHash(virtualNodes int) *ConsistentHash {
    return &ConsistentHash{
        virtualNodes: virtualNodes,
        hashFunc:     defaultHash,      // 默认哈希函数
        ring:         rbt.NewWithIntComparator(),
        nodeMap:      make(map[string]bool),
    }
}

// 默认哈希函数
func defaultHash(key string) uint32 {
    h := fnv.New32a()
    h.Write([]byte(key))
    return h.Sum32()
}

// 添加物理节点
func (ch *ConsistentHash) AddNode(node string) {
    ch.mu.Lock()
    defer ch.mu.Unlock()

    // 如果节点已存在,直接返回
    if ch.nodeMap[node] {
        return
    }

    // 添加虚拟节点
    for i := 0; i < ch.virtualNodes; i++ {
        // 创建虚拟节点key
        virtualKey := fmt.Sprintf("%s#%d", node, i)
        hash := ch.hashFunc(virtualKey)

        // 将虚拟节点添加到红黑树
        ch.ring.Put(int(hash), node)
    }

    // 标记节点已添加
    ch.nodeMap[node] = true
}

// 删除物理节点
func (ch *ConsistentHash) RemoveNode(node string) {
    ch.mu.Lock()
    defer ch.mu.Unlock()

    // 如果节点不存在,直接返回
    if !ch.nodeMap[node] {
        return
    }

    // 删除所有虚拟节点
    for i := 0; i < ch.virtualNodes; i++ {
        virtualKey := fmt.Sprintf("%s#%d", node, i)
        hash := ch.hashFunc(virtualKey)

        ch.ring.Remove(int(hash))
    }

    // 从节点映射中删除
    delete(ch.nodeMap, node)
}

// 查找节点
func (ch *ConsistentHash) GetNode(key string) (string, bool) {
    ch.mu.RLock()
    defer ch.mu.RUnlock()

    // 如果环为空,返回空
    if ch.ring.Size() == 0 {
        return "", false
    }

    // 计算key的哈希值
    hash := ch.hashFunc(key)
    hashInt := int(hash)

    // 在红黑树中查找 >= hash 的第一个节点
    node, found := ch.ring.Ceiling(hashInt)

    if found {
        // 如果找到了,返回对应的物理节点
        return node.Value.(string), true
    } else {
        // 如果没找到,返回第一个节点(环状结构)
        firstNode := ch.ring.Left()
        if firstNode != nil {
            return firstNode.Value.(string), true
        }
    }

    return "", false
}

// 打印哈希环状态
func (ch *ConsistentHash) PrintRing() {
    ch.mu.RLock()
    defer ch.mu.RUnlock()

    fmt.Println("=== 哈希环状态 ===")
    fmt.Printf("虚拟节点数量: %d\n", ch.ring.Size())
    fmt.Printf("物理节点数量: %d\n", len(ch.nodeMap))

    fmt.Println("\n物理节点列表:")
    for node := range ch.nodeMap {
        fmt.Printf("  - %s\n", node)
    }

    fmt.Println("\n虚拟节点分布:")
    it := ch.ring.Iterator()
    for it.Next() {
        hash := it.Key().(int)
        node := it.Value().(string)
        fmt.Printf("  哈希: %d -> 物理节点: %s\n", hash, node)
    }
}
响应时间加权
核心思想:选择响应时间最短的实例
适用场景:对延迟敏感的服务
// 实现思路:
func ResponseTimeSelect(instances []Instance) Instance {
    var best Instance
    minResponseTime := time.Duration(math.MaxInt64)

    for _, instance := range instances {
        // 获取平均响应时间
        avgTime := instance.GetAverageResponseTime()

        // 考虑权重:响应时间/权重
        weightedTime := avgTime / time.Duration(instance.Weight)

        if weightedTime < minResponseTime {
            minResponseTime = weightedTime
            best = instance
        }
    }

    return best
}

// 核心逻辑:动态感知实例性能
// 实例A:响应时间10ms,权重1 → 10/1=10
// 实例B:响应时间20ms,权重2 → 20/2=10
// 实例C:响应时间15ms,权重3 → 15/3=5 ← 最优
在kitex框架下的使用
与etcd一样,kitex框架自带了多重均衡负载策略:
- 加权随机(默认方法)
- 加权轮询
- 一致性哈希
- 最少连接
- 标签匹配
在不指定均衡负载的情况下,kitex会自动使用加权随机策略
在kitex中指定并配置均衡负载策略的示例如下:
加权随机
func main() {
    // 不指定,默认使用默认负载均衡(加权随机)
    defaultClient, _ := echo.NewClient(
        "echo-service",
        client.WithHostPorts("127.0.0.1:8888", "127.0.0.1:8889"),
    )
    _ = defaultClient
}
加权轮询
func main(){
    // 指定加权轮询
    wrrClient, _ := echo.NewClient(
        "echo-service",
        client.WithHostPorts("127.0.0.1:8888", "127.0.0.1:8889"),
        client.WithLoadBalancer(loadbalance.NewWeightedRoundRobinBalancer()),
    )
    _ = wrrClient
}
一致性哈希/IP哈希/用户哈希
func main(){
    // 指定一致性哈希
    hashClient, _ := echo.NewClient(
        "echo-service",
        client.WithHostPorts("127.0.0.1:8888", "127.0.0.1:8889"),
        client.WithLoadBalancer(loadbalance.NewConsistentHashBalancer()),
    )
    _ = hashClient
}
可以通过自定义哈希键的方式把获得的哈希键设置为客户端IP或用户ID
func main() {
    // 自定义一致性哈希策略
    cli, err := echo.NewClient(
        "echo-service",
        client.WithHostPorts("127.0.0.1:8888", "127.0.0.1:8889"),
        client.WithLoadBalancer(loadbalance.NewConsistentHashBalancer(
            func(opt *loadbalance.ConsistentHashOption) {
                // 自定义哈希键提取
                opt.GetKey = func(ctx context.Context, request interface{}) string {
                    // 从上下文中获取用户ID
                    if uid, ok := ctx.Value("user_id").(string); ok {
                        return uid
                    }

                    // 从请求中获取
                    if req, ok := request.(*echo.EchoRequest); ok {
                        if req.UserID != "" {
                            return req.UserID
                        }
                        return req.Message
                    }

                    // 默认使用请求的字符串表示
                    return fmt.Sprintf("%v", request)
                }

                // 虚拟节点数(默认 100,推荐 100-200)
                opt.VirtualFactor = 160

                // 哈希函数(默认 crc32)
                // opt.HashFunc = func(data []byte) uint32 {
                //     // 自定义哈希函数
                //     return myHashFunc(data)
                // }

                // 副本数
                opt.Replica = 1
            },
        )),
    )
}
最少链接
func main(){
    // 方法4:指定最少连接
    lcClient, _ := echo.NewClient(
        "echo-service",
        client.WithHostPorts("127.0.0.1:8888", "127.0.0.1:8889"),
        client.WithLoadBalancer(loadbalance.NewLeastConnBalancer()),
    )
    _ = lcClient
}
标签匹配
在设置rpc服务端时设置标签,可以在指定标签进行匹配
func main() {
    // 使用标签进行路由
    cli, err := echo.NewClient(
        "echo-service",
        client.WithLoadBalancer(loadbalance.NewTagBalancer()),

        // 标签匹配规则
        client.WithTag("zone", "shanghai"),  // 选择上海区域
        client.WithTag("env", "prod"),       // 选择生产环境
        client.WithTag("version", "v1.2.0"), // 选择特定版本

        // 负载均衡器
        client.WithLoadBalancer(loadbalance.NewWeightedRandomBalancer()),
    )
}
限流
限流通常在网关层作为狭义中间件使用
需要注意的是,限流通常不采用某种特定方法,而是根据业务需求结合不同限流方法
概念
控制单位时间内进入系统或某个服务的请求数量。当遇到突发流量(如秒杀活动)时,通过限流保护系统不被瞬间压垮,
确保在最大承受能力内平稳运行,超出的请求会被友好地拒绝或排队,保障系统不会崩溃
实现
令牌桶算法
创建一个bucket存放令牌,请求流入时尝试获取桶内令牌,请求需要成功获取令牌才能流过,桶内令牌会以设定的速率进行补充
该算法适合应对突发流量情况
// TokenBucketLimiter 令牌桶限流器
type TokenBucketLimiter struct {
    capacity     int           // 桶容量
    tokens       int           // 当前令牌数
    fillRate     int           // 填充速率(每秒)
    lastRefill   time.Time     // 上次填充时间
    mu           sync.Mutex
}

func NewTokenBucket(capacity, fillRate int) *TokenBucketLimiter {
    return &TokenBucketLimiter{
        capacity:   capacity,
        tokens:     capacity,
        fillRate:   fillRate,
        lastRefill: time.Now(),
    }
}

func (tb *TokenBucketLimiter) Allow() bool {
    tb.mu.Lock()
    defer tb.mu.Unlock()

    // 1. 补充令牌
    now := time.Now()
    elapsed := now.Sub(tb.lastRefill)
    tokensToAdd := int(elapsed.Seconds() * float64(tb.fillRate))

    if tokensToAdd > 0 {
        tb.tokens = min(tb.capacity, tb.tokens+tokensToAdd)
        tb.lastRefill = now
    }

    // 2. 尝试获取令牌
    if tb.tokens > 0 {
        tb.tokens--
        return true
    }

    return false
}

// 核心思想:固定速率放入令牌,请求消耗令牌
// 优点:允许一定突发流量
// 场景:API限流、接口保护
漏铜算法
将所有流入的请求放入桶内,并让桶以一定速率流出请求(由chan实现)
该算法允许请求平滑通过
// LeakyBucketLimiter 漏桶限流器
type LeakyBucketLimiter struct {
    capacity     int           // 桶容量
    queue        chan struct{} // 请求队列
    leakRate     time.Duration // 漏出速率
    stopCh       chan struct{}
}

func NewLeakyBucket(capacity int, ratePerSecond int) *LeakyBucketLimiter {
    lb := &LeakyBucketLimiter{
        capacity: capacity,
        queue:    make(chan struct{}, capacity),
        leakRate: time.Second / time.Duration(ratePerSecond),
        stopCh:   make(chan struct{}),
    }

    // 启动漏水协程
    go lb.leak()
    return lb
}

func (lb *LeakyBucketLimiter) Allow() bool {
    select {
    case lb.queue <- struct{}{}:  // 水流入桶
        return true
    default:  // 桶已满,拒绝
        return false
    }
}

func (lb *LeakyBucketLimiter) leak() {
    ticker := time.NewTicker(lb.leakRate)
    defer ticker.Stop()

    for {
        select {
        case <-ticker.C:
            select {
            case <-lb.queue:  // 漏出一滴水(处理一个请求)
            default:
            }
        case <-lb.stopCh:
            return
        }
    }
}

func (lb *LeakyBucketLimiter) Stop() {
    close(lb.stopCh)
}

// 核心思想:以恒定速率处理请求,突发流量会排队
// 优点:平滑输出,防止突发流量冲击下游
// 场景:消息队列、数据库连接池
滑动窗口算法
滑动窗口算法是固定窗口算法的优化版
固定窗口算法允许请求在固定时间段流过一定数量的请求,如01秒10个,12秒十个。但是该算法的缺陷在于,当请求在0.9秒与1.1秒分别流入10个请求,就会出现在短时间内超过规定请求数的情况(0.2秒20个请求)
相比固定窗口,滑动窗口的处理更加平滑,该算法将固定的窗口分割为n个时间槽,时间槽根据当前的时间删除窗口左边缘对应的时间槽、计算当前时间的对应时间槽,并统计所有时间的槽请求次数,当所有时间槽总计的请求次数超过规定的请求数时拒绝请求流过,若请求成功流过则增加对应的时间槽的计数
工作流程图
时间轴:0.0  0.1  0.2  0.3  0.4  0.5  0.6  0.7  0.8  0.9  1.0  1.1  1.2 (秒)
槽位:  [0]  [1]  [2]  [3]  [4]  [5]  [6]  [7]  [8]  [9]

假设当前时间是1.2秒,窗口大小1秒:

滑动窗口包含:[0.2, 1.2]秒
对应槽位:[2]到[1](因为是环形的)

计算窗口内总请求数 = 槽2+槽3+槽4+...+槽9+槽0+槽1
代码实现:
// SlidingWindowLimiter 滑动窗口限流器
type SlidingWindowLimiter struct {
    limit        int           // 窗口内最大请求数
    window       time.Duration // 窗口大小
    slots        []slot       // 时间槽
    slotCount    int          // 槽数量
    mu           sync.RWMutex
}

type slot struct {
    timestamp int64  // 毫秒时间戳
    count     int    // 该槽的请求数
}

func NewSlidingWindow(limit int, window time.Duration, slotCount int) *SlidingWindowLimiter {
    if slotCount <= 0 {
        slotCount = 10
    }

    return &SlidingWindowLimiter{
        limit:     limit,
        window:    window,
        slots:     make([]slot, slotCount),
        slotCount: slotCount,
    }
}

func (sw *SlidingWindowLimiter) Allow() bool {
    sw.mu.Lock()
    defer sw.mu.Unlock()

    now := time.Now().UnixMilli()
    slotSize := int64(sw.window.Milliseconds()) / int64(sw.slotCount)

    // 清理过期槽位
    currentIdx := int((now / slotSize) % int64(sw.slotCount))
    expiredTime := now - int64(sw.window.Milliseconds())

    for i := 0; i < sw.slotCount; i++ {
        if sw.slots[i].timestamp < expiredTime {
            sw.slots[i] = slot{}  // 清空过期槽
        }
    }

    // 计算当前窗口内的总请求数
    total := 0
    for i := 0; i < sw.slotCount; i++ {
        if sw.slots[i].timestamp >= expiredTime {
            total += sw.slots[i].count
        }
    }

    if total >= sw.limit {
        return false
    }

    // 记录当前请求
    if sw.slots[currentIdx].timestamp == now/slotSize*slotSize {
        sw.slots[currentIdx].count++
    } else {
        sw.slots[currentIdx] = slot{
            timestamp: now / slotSize * slotSize,
            count:     1,
        }
    }

    return true
}

// 核心思想:将固定窗口切分为多个小窗口,只统计最近N个窗口
// 优点:解决边界问题,更加精确
// 场景:API网关、微服务限流
分布式限流(Redis)
原理是在单机限流的基础上,利用redis的原子性,在分布式环境下维护一个进程共享的计数器
分布式限流并不是某种固定的算法,而是让redis与其他限流算法结合实现分布式系统的统一限流,并使用lua脚本保证代码流程原子性
以令牌桶算法为例:
func (rl *RedisLimiter) AllowTokenBucket(ctx context.Context, key string,
    capacity int, rate float64, tokens int) (bool, error) {

    now := time.Now().UnixNano()

    script := `
        local key = KEYS[1]
        local capacity = tonumber(ARGV[1])
        local rate = tonumber(ARGV[2])
        local now = tonumber(ARGV[3])
        local requested = tonumber(ARGV[4])

        local bucket = redis.call('HMGET', key, 'tokens', 'last_refill')
        local tokens = tonumber(bucket[1]) or capacity
        local last_refill = tonumber(bucket[2]) or now

        -- 计算时间差(纳秒)
        local elapsed = (now - last_refill) / 1000000000  -- 转换为秒
        local refill = math.floor(elapsed * rate)

        -- 补充令牌
        tokens = math.min(capacity, tokens + refill)

        -- 更新最后补充时间
        if refill > 0 then
            last_refill = now
        end

        local allowed = 0
        if tokens >= requested then
            tokens = tokens - requested
            allowed = 1
        end

        -- 保存状态
        redis.call('HMSET', key,
            'tokens', tokens,
            'last_refill', last_refill
        )

        -- 设置过期时间
        local ttl = math.ceil(capacity / rate) * 2
        redis.call('EXPIRE', key, ttl)

        return {allowed, tokens}
    `

    result, err := rl.client.Eval(ctx, script, []string{rl.prefix + key},
        capacity, rate, now, tokens).Result()

    if err != nil {
        return false, err
    }

    res := result.([]interface{})
    return res[0].(int64) == 1, nil
}
在kitex框架下的使用
特别地,kitex虽然内置了以令牌桶算法实现的限流功能,但是该限流功能只作用于服务端用于保护服务提供方,客户端限流或其他限流方法需要自行实现或使用中间件
服务端限流示例代码:
package main

import (
    "context"
    "net"

    "github.com/cloudwego/kitex/pkg/limit"
    "github.com/cloudwego/kitex/server"

    "your_service/kitex_gen/your/service"  // 替换为你的服务
)

func main() {
    // 创建监听地址
    addr, _ := net.ResolveTCPAddr("tcp", ":8888")

    // 创建服务
    svr := server.NewServer(
        // 设置服务地址
        server.WithServiceAddr(addr),

        // 开启限流
        server.WithLimit(&limit.Option{
            // 连接数限制
            MaxConnections: 1000,       // 最大连接数
            MaxQPS:         1000,       // 最大QPS(每秒请求数)

            // 限流算法
            // 内置:令牌桶算法
        }),

        // 监控和统计
        server.WithStatsLevel(stats.LevelDetailed),  // 开启详细统计
    )

    // 启动服务
    err := svr.Run()
    if err != nil {
        panic(err)
    }
}
熔断
熔断器通常在业务调用或作为依赖的一部分注入发挥作用
概念
当某个下游服务调用失败率过高时(如超时、报错),主动熔断对该服务的调用,快速失败并进入降级逻辑。
这可以防止故障向上游扩散,避免因一个服务的瘫痪导致整个系统雪崩,给故障服务恢复的时间
原理解析与代码实现
熔断器状态机
熔断器的实现以状态机和状态转换为核心:
状态机的三种状态:Close,Open,HalfOpen
当熔断器处于不同状态时,会有不同的方法策略
- 关闭(Close):
- 通过流入的请求
- 记录请求失败的次数
- 当累计的请求失败次数大于设定的熔断阈值时,将熔断器设为开启状态(Open)
- 开启(Open):
- 拒绝流入的请求
- 记录熔断器开启的时间
- 检查状态持续时间是否超过设定的最大熔断时间,若超过,将熔断器设为半开状态(HalfOpen)
- 半开(HalfOpen):
- 设置规定的请求尝试数量
- 记录请求成功的次数
- 在请求数达到规定的请求尝试数量时,检查累计的请求成功次数是否达到规定的成功阈值,若达到,将熔断器设置为关闭状态(Close),若未达到则将熔断器设置为开启状态(Open)
// 1. Closed 状态(正常)
type ClosedState struct {
    failureCount int           // 失败计数
    successCount int           // 成功计数
    windowStart  time.Time     // 窗口开始时间
    threshold    int           // 失败阈值
    windowSize   time.Duration // 时间窗口
}

// 逻辑:统计失败率,超过阈值转为Open

// 2. Open 状态(熔断)
type OpenState struct {
    openedAt     time.Time     // 熔断开始时间
    timeout      time.Duration // 熔断持续时间
}

// 逻辑:所有请求立即失败,不调用下游

// 3. HalfOpen 状态(试探)
type HalfOpenState struct {
    allowedRequests int        // 允许的试探请求数
    successCount    int        // 成功计数
    threshold       int        // 成功阈值
}

// 逻辑:允许少量请求试探,成功达到阈值转Closed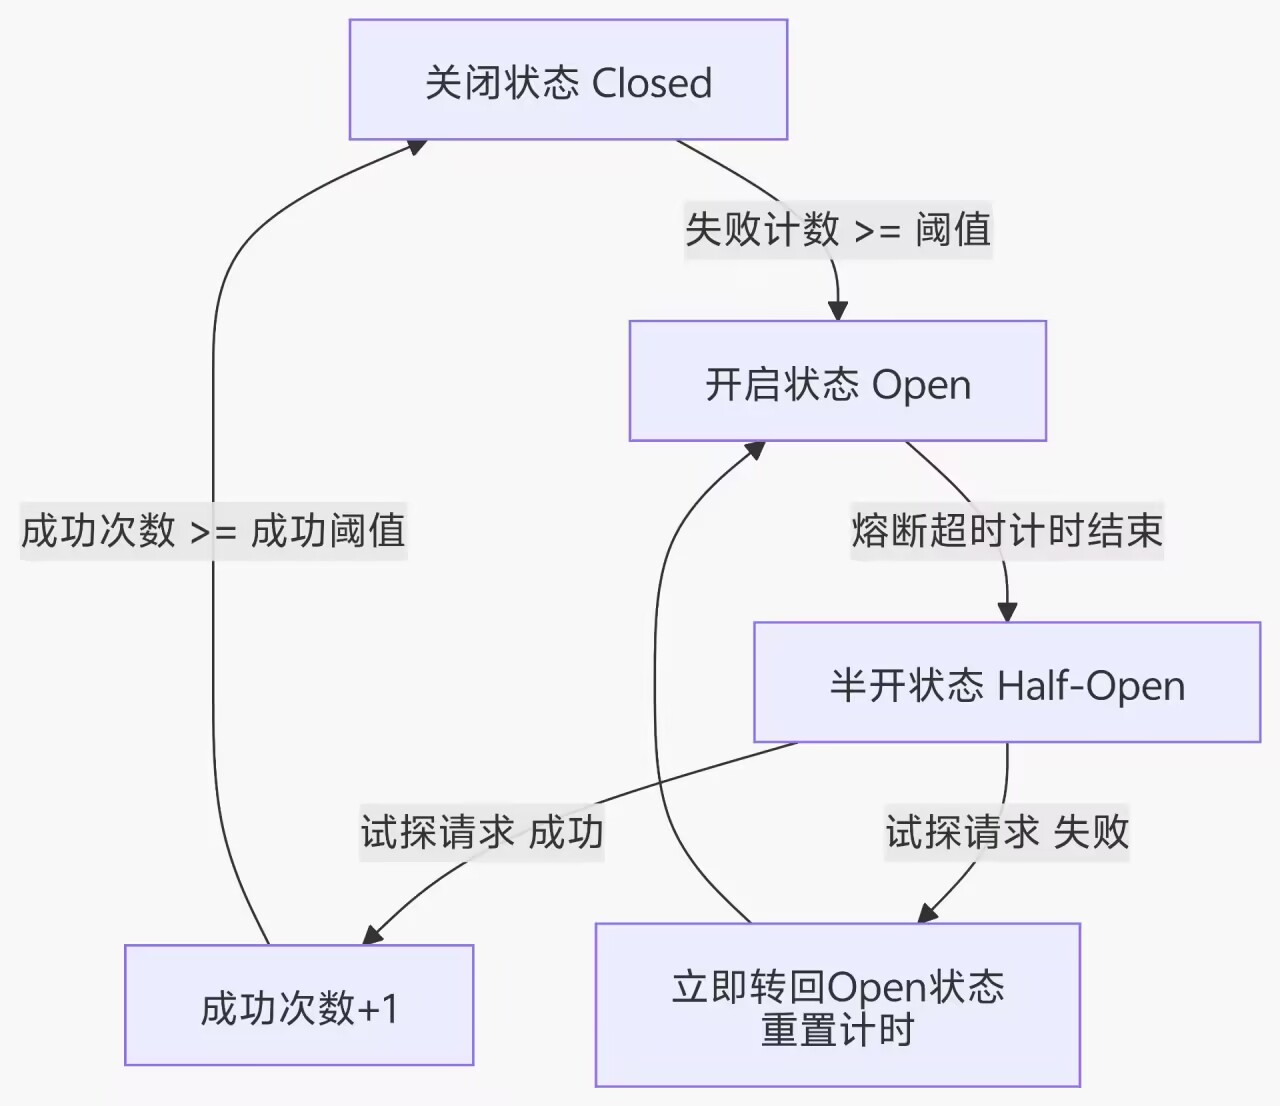
当然,一般情况下熔断器模型对状态和请求的记录是解耦的:
// 熔断器状态
type State int

const (
	StateClosed State = iota    // 关闭状态:正常处理请求
	StateOpen                   // 开启状态:快速失败
	StateHalfOpen               // 半开状态:试探请求
)

// 熔断器配置
type Config struct {
	Name              string
	FailureThreshold  int           // 失败次数阈值
	SuccessThreshold  int           // 恢复成功阈值
	HalfOpenMaxCalls  int           // 半开状态最大试探请求
	OpenTimeout       time.Duration // 熔断持续时间
	ResetTimeout      time.Duration // 统计重置时间
}

// 统计信息
type Stats struct {
	TotalRequests   int64
	SuccessCount    int64
	FailureCount    int64
	RejectedCount   int64
	LastFailureTime time.Time
	LastSuccessTime time.Time
	State           State
	StateChangeTime time.Time
}

// 精简熔断器实现
type CircuitBreaker struct {
	state     State
	config    Config
	stats     Stats

	mu             sync.RWMutex
	openTime       time.Time
	halfOpenCalls  int
	halfOpenSuccess int

	// 失败计数
	failureCount   int
	successCount   int
	lastResetTime  time.Time
}
熔断器核心方法
熔断器有两个核心方法:Allow和Record
Allow
设置了熔断器状态机后,所有请求会流过Allow方法:
Allow方法会检查当前熔断器状态机状态,根据不同的状态选择允许请求流过、拒绝请求流过或尝试半开等熔断器逻辑方法
// Allow - 检查是否允许请求
func (cb *CircuitBreaker) Allow() bool {
	cb.mu.RLock()
	defer cb.mu.RUnlock()

	now := time.Now()

	switch cb.state {
	case StateClosed:
		// 检查是否需要重置统计
		if now.Sub(cb.lastResetTime) >= cb.config.ResetTimeout {
			// 异步重置
			go cb.resetStats()
		}
		return true

	case StateOpen:
		// 检查是否超时,可以切换到半开状态
		if now.Sub(cb.openTime) >= cb.config.OpenTimeout {
			// 异步切换到半开
			go cb.tryHalfOpen()
			return true
		}
		cb.recordRejected()
		return false
case StateHalfOpen:
		// 半开状态允许有限的试探请求
		if cb.halfOpenCalls < cb.config.HalfOpenMaxCalls {
			return true
		}
		cb.recordRejected()
		return false
	}

	return false
}

// 尝试切换到半开状态
func (cb *CircuitBreaker) tryHalfOpen() {
	cb.mu.Lock()
	defer cb.mu.Unlock()

	// 确保还在Open状态并且超时了
	if cb.state == StateOpen && time.Since(cb.openTime) >= cb.config.OpenTimeout {
		cb.state = StateHalfOpen
		cb.stats.State = StateHalfOpen
		cb.stats.StateChangeTime = time.Now()
		cb.halfOpenCalls = 0
		cb.halfOpenSuccess = 0
	}
}

// 重置统计
func (cb *CircuitBreaker) resetStats() {
	cb.mu.Lock()
	defer cb.mu.Unlock()

	now := time.Now()
	if now.Sub(cb.lastResetTime) >= cb.config.ResetTimeout {
		cb.failureCount = 0
		cb.successCount = 0
		cb.lastResetTime = now
	}
}

// 记录拒绝的请求
func (cb *CircuitBreaker) recordRejected() {
	cb.mu.Lock()
	defer cb.mu.Unlock()

	cb.stats.RejectedCount++
}
Record
Record方法负责记录请求的成功与否,并根据请求记录对熔断器的状态进行切换
// Record - 记录请求结果
func (cb *CircuitBreaker) Record(success bool) {
	cb.mu.Lock()
	defer cb.mu.Unlock()

	now := time.Now()
	cb.stats.TotalRequests++

	if success {
		cb.successCount++
		cb.failureCount = 0 // 成功时重置失败计数
		cb.stats.SuccessCount++
		cb.stats.LastSuccessTime = now

		switch cb.state {
		case StateClosed:
			// 正常状态,成功请求

		case StateHalfOpen:
			cb.halfOpenCalls++
			cb.halfOpenSuccess++

						// 半开状态连续成功达到阈值,恢复关闭状态
			if cb.halfOpenSuccess >= cb.config.SuccessThreshold {
				cb.state = StateClosed
				cb.stats.State = StateClosed
				cb.stats.StateChangeTime = now
				// 重置半开统计
				cb.halfOpenCalls = 0
				cb.halfOpenSuccess = 0
				// 重置失败计数
				cb.failureCount = 0
			}
		}

	} else {
		cb.failureCount++
		cb.successCount = 0 // 失败时重置成功计数
		cb.stats.FailureCount++
		cb.stats.LastFailureTime = now

		switch cb.state {
		case StateClosed:
			// 检查是否达到熔断条件
			if cb.failureCount >= cb.config.FailureThreshold {
				cb.state = StateOpen
				cb.stats.State = StateOpen
				cb.openTime = now
				cb.stats.StateChangeTime = now
			}

		case StateHalfOpen:
			// 半开状态下任何失败都重新熔断
			cb.state = StateOpen
			cb.stats.State = StateOpen
			cb.openTime = now
			cb.stats.StateChangeTime = now
			// 重置半开统计
			cb.halfOpenCalls = 0
			cb.halfOpenSuccess = 0
		}
Excute
Excute虽然并非熔断器核心逻辑方法,但是一般会使用Excute方法对Allow和Record进行封装,使熔断器在其他方法中更容易被调用
func (cb *CircuitBreaker) Execute[T any](fn func() (T, error)) (T, error) {
    var zero T

    // 检查熔断器
    if !cb.Allow() {
        cb.recordRejected()
        return zero, ErrCircuitOpen
    }

    // 执行业务函数
    result, err := fn()

    // 记录结果
    cb.Record(err == nil)

    // 返回结果
    return result, err
}这样的Excute方法可以在其他业务代码中被调用,并返回原函数的返回值和错误
若不需要返回值或需要多个返回值,可将Excute方法修改为无泛型返回值会多返回值,或者在调用该方法时进行结构体封装或序列化数据
在业务代码中的使用
以用户服务的dao层为例
// internal/dao/user_dao_simple.go
package dao

import (
	"context"
	"errors"
	"fmt"
	"time"

	"gorm.io/gorm"
	"kitex-user-service/pkg/circuitbreaker"
)

type UserDAO struct {
	db *gorm.DB
	breaker *circuitbreaker.CircuitBreaker
}

func NewUserDAO(db *gorm.DB) *UserDAO {
	return &UserDAO{
		db: db,
		breaker: circuitbreaker.NewCircuitBreaker(circuitbreaker.Config{
			Name:             "user_dao",
			FailureThreshold: 3,
			SuccessThreshold: 2,
			HalfOpenMaxCalls: 2,
			OpenTimeout:      5 * time.Second,
			ResetTimeout:     10 * time.Second,
		}),
	}
}

// CreateUser 创建用户
func (dao *UserDAO) CreateUser(ctx context.Context, user *User) (*User, error) {
	// 使用熔断器保护
	result, err := dao.breaker.Execute(func() (*User, error) {
		// 直接创建用户
		err := dao.db.WithContext(ctx).Create(user).Error
		if err != nil {
			// 检查是否是唯一键冲突
			if errors.Is(err, gorm.ErrDuplicatedKey) {
				return nil, errors.New("用户名或邮箱已存在")
			}
			return nil, fmt.Errorf("创建用户失败: %w", err)
		}

		return user, nil
	})

	return result, err
}
正常情况下,熔断器还需要滑动窗口等算法进行性能优化,此处省略
在kitex框架下的应用
与etcd一样,kitex框架也内置了熔断器,并且使用同样非常简单
kitex中的熔断器有两种颗粒度:client-server和client-server/method,分别对相应client与server和client与server及其所有方法生效
kitex内置的熔断器实例使用NewCBSuite(KeyFunc)来获取,参数KeyFunc为获取熔断器级别标签的方法,级别标签的命名规则为fromServiceName/toServiceName/method,使用circuitbreaker.RPCInfo2Key方法可以快速获取client-server/method的级别标签:
// 默认配置
cbs := circuitbreak.NewCBSuite(circuitbreak.RPCInfo2Key)也可以自定义标签生成方法,使用From()/To()/ServiceName()/Method()获取服务名/方法名:
// 自定义Key生成函数示例
func CustomCBKeyFunc(ri rpcinfo.RPCInfo) string {
    // 获取调用信息
    from := ri.From().ServiceName()
    to := ri.To().ServiceName()
    method := ri.To().Method()

    // 自定义格式:服务名+方法名
    return fmt.Sprintf("%s_%s_%s", from, to, method)
}

// 使用自定义Key函数
cbs := circuitbreak.NewCBSuite(CustomCBKeyFunc)
以api-gateway和user-service为例:
// cmd/api-gateway/main.go
package main

import...

// 全局user-service客户端
var userClient userservice.Client

// 初始化熔断器和客户端
func initCircuitBreaker() {
	// 创建熔断器 - 使用默认的RPCInfo2Key(method粒度)
	cbs := circuitbreak.NewCBSuite(circuitbreak.RPCInfo2Key)

	// 创建etcd服务发现
	r, err := etcd.NewEtcdRegistry([]string{"127.0.0.1:2379"})
	if err != nil {
		log.Fatalf("创建etcd注册中心失败: %v", err)
	}

	// 创建user-service客户端,启用熔断器
	cli, err := userservice.NewClient(
		"user-service", // 服务名
		client.WithResolver(r),                      // 服务发现
		client.WithCircuitBreaker(cbs),              // 启用熔断器	client.WithRPCTimeout(3*time.Second),        // RPC超时	client.WithConnectTimeout(100*time.Millisecond), // 连接超时	client.WithClientBasicInfo(&rpcinfo.EndpointBasicInfo{
			ServiceName: "api-gateway",               // 当前服务名
		}),
	)
	//后续业务...
}
服务降级
服务降级在各个层级都能发挥作用
概念
一般来说,服务降级会监测服务器系统资源,即当监控到服务器资源不足时,将某些非主要业务降级或关闭
具体来说,在系统资源紧张或非核心服务故障时(如促销期间),主动关闭部分非核心功能(如商品评论、推荐),或返回兜底数据,
以保证核心交易链路(如下单、支付)的可用性。这是一种“舍车保帅”的生存策略
实现
由于服务降级一般要结合可观测行组件实现系统监控等功能,故此处只提及降级策略和方法,不进行资源监控
降级策略
当系统资源不足时,有多种降级策略可供选择:
- 默认降级:返回空响应
- 静默降级:不抛错,返回空值或默认值,用户无感知
- 缓存降级:返回缓存数据,不查实时数据
- 备用服务降级:切换到备用服务/简单逻辑
- 快速失败:立即返回错误,不处理
- 延迟处理:请求排队,异步处理
- 功能开关:关闭非核心功能
- 简化流程:跳过复杂计算/校验
- 数据裁剪:返回部分字段,不返回完整数据
- 限流降级:限制请求频率
- 超时降级:缩短超时时间
- 重试降级:减少重试次数
- 熔断降级:依赖故障时快速失败
- 异步降级:同步转异步
- 降级读:主库故障时读从库
- 降级写:写操作转为异步队列
- 静态化:动态转静态
- 合并请求:多个请求合并为一个
手动降级
package degrade

import (
    "sync/atomic"
    "time"
)

// 降级开关管理器
type DegradeManager struct {
    switches map[string]*atomic.Bool
    mu       sync.RWMutex
}

// 降级开关配置
type DegradeConfig struct {
    Name        string        // 开关名称
    Description string        // 描述
    Default     bool          // 默认状态
    AutoRecover bool          // 是否自动恢复
    RecoverTime time.Duration // 自动恢复时间
}

// 电商系统降级开关
var degradeSwitches = map[string]*DegradeConfig{
    "coupon_service": {  // 优惠券服务
        Name:        "coupon_service",
        Description: "优惠券计算服务",
        Default:     false,  // 默认不降级
        AutoRecover: true,
        RecoverTime: 5 * time.Minute,
    },
    "point_service": {  // 积分服务
        Name:        "point_service",
        Description: "用户积分服务",
        Default:     false,
        AutoRecover: true,
        RecoverTime: 10 * time.Minute,
    },
    "notification_service": {  // 通知服务
        Name:        "notification_service",
        Description: "短信/邮件通知服务",
        Default:     false,
        AutoRecover: true,
        RecoverTime: 30 * time.Minute,
    },
    "recommend_service": {  // 推荐服务
        Name:        "recommend_service",
        Description: "商品推荐服务",
        Default:     false,
        AutoRecover: true,
        RecoverTime: 15 * time.Minute,
    },
}
自动降级 (基于指标)
package degrade

import (
    "sync"
    "time"
)

// 自动降级器
type AutoDegrader struct {
    metrics     map[string]float64  // 监控指标
    thresholds  map[string]float64  // 降级阈值
    status      map[string]bool     // 降级状态
    mu          sync.RWMutex
}

// 监控指标定义
type MetricType string

const (
    CPULoad      MetricType = "cpu_load"       // CPU负载
    MemoryUsage  MetricType = "memory_usage"   // 内存使用率
    ErrorRate    MetricType = "error_rate"     // 错误率
    LatencyP99   MetricType = "latency_p99"    // P99延迟
    QPS          MetricType = "qps"            // 请求量
    Dependency   MetricType = "dependency"     // 依赖服务状态
)

// 降级规则配置
type DegradeRule struct {
    Name        string      // 规则名称
    Metric      MetricType  // 监控指标
    Threshold   float64     // 触发阈值
    Service     string      // 影响的服务
    Action      string      // 降级动作
    Duration    time.Duration // 降级持续时间
}

// 电商系统降级规则
var degradeRules = []DegradeRule{
    {
        Name:      "high_cpu_coupon",
        Metric:    CPULoad,
        Threshold: 0.8,  // CPU负载超过80%
        Service:   "coupon_service",
        Action:    "disable",  // 禁用优惠计算
        Duration:  5 * time.Minute,
    },
    {
        Name:      "high_error_notification",
        Metric:    ErrorRate,
        Threshold: 0.1,  // 错误率超过10%
        Service:   "notification_service",
        Action:    "fallback",  // 降级到简单通知
        Duration:  10 * time.Minute,
    },
    {
        Name:      "slow_dependency",
        Metric:    LatencyP99,
        Threshold: 1000,  // P99延迟超过1秒
        Service:   "recommend_service",
        Action:    "cache_only",  // 只返回缓存数据
        Duration:  3 * time.Minute,
    },
}
kitex框架下的实现
可惜,kitex并没有内置的服务降级组件,我们只能自己写相关逻辑代码,然后用kitex的中间件功能实现服务降级
以下为在项目中实现服务降级的示例代码:
核心降级管理器
package degrade

import (
    "context"
    "sync"
    "time"

    "github.com/cloudwego/kitex/pkg/klog"
    "github.com/cloudwego/kitex/pkg/rpcinfo"
    "github.com/cloudwego/kitex/server"
)

// DegradeManager 降级管理器
type DegradeManager struct {
    // 降级开关
    switches sync.Map  // map[serviceKey]*DegradeSwitch

    // 降级规则
    rules []DegradeRule

    // 监控指标
    metrics map[string]float64

    // 锁
    mu sync.RWMutex
}

// 降级开关
type DegradeSwitch struct {
    Service     string
    Method      string
    Enabled     bool
    Reason      string
    StartTime   time.Time
    Strategy    DegradeStrategy
    mu          sync.RWMutex
}

// 降级策略
type DegradeStrategy struct {
    Type       StrategyType
    Config     map[string]interface{}
    Fallback   func(ctx context.Context, req interface{}) (interface{}, error)
}

// 策略类型
type StrategyType int

const (
    StrategyFastFail StrategyType = iota  // 快速失败
    StrategySilent                        // 静默处理
    StrategyFallback                      // 备用方案
    StrategyCache                         // 缓存降级
    StrategyTimeout                       // 超时降级
    StrategyRetry                         // 重试降级
)

// 降级规则
type DegradeRule struct {
    ID          string
    Service     string
    Method      string
    Condition   DegradeCondition
    Strategy    DegradeStrategy
    Duration    time.Duration
    Priority    int
    Enabled     bool
}

// 降级条件
type DegradeCondition struct {
    Type       ConditionType
    Metric     string
    Operator   string
    Threshold  float64
    Duration   time.Duration
}

// 条件类型
type ConditionType int

const (
    ConditionManual ConditionType = iota  // 手动触发
    ConditionCPU                          // CPU负载
    ConditionMemory                       // 内存使用
    ConditionErrorRate                    // 错误率
    ConditionLatency                      // 延迟
    ConditionQPS                          // 请求量
    ConditionDependency                   // 依赖服务
)

// 初始化降级管理器
func NewDegradeManager() *DegradeManager {
    return &DegradeManager{
        switches: sync.Map{},
        rules:    make([]DegradeRule, 0),
        metrics:  make(map[string]float64),
    }
}

// 检查服务是否降级
func (dm *DegradeManager) IsDegraded(service, method string) (bool, *DegradeSwitch) {
    key := serviceKey(service, method)

    // 检查是否有明确的开关
    if switchVal, ok := dm.switches.Load(key); ok {
        s := switchVal.(*DegradeSwitch)
        s.mu.RLock()
        defer s.mu.RUnlock()
        return s.Enabled, s
    }

    // 检查是否有匹配的规则
    dm.mu.RLock()
    defer dm.mu.RUnlock()

    for i := len(dm.rules) - 1; i >= 0; i-- { // 从高优先级开始
        rule := dm.rules[i]
        if !rule.Enabled {
            continue
        }

        if matchesRule(service, method, rule) {
            if dm.checkCondition(rule.Condition) {
                // 创建临时开关
                switchVal := &DegradeSwitch{
                    Service:   service,
                    Method:    method,
                    Enabled:   true,
                    Reason:    rule.Condition.Type.String(),
                    StartTime: time.Now(),
                    Strategy:  rule.Strategy,
                }

                dm.switches.Store(key, switchVal)

                // 设置自动恢复
                if rule.Duration > 0 {
                    go dm.autoRecover(service, method, rule.Duration)
                }

                return true, switchVal
            }
        }
    }

    return false, nil
}

// 手动降级
func (dm *DegradeManager) SetDegrade(service, method, reason string,
    strategy DegradeStrategy, duration time.Duration) error {

    key := serviceKey(service, method)

    switchVal := &DegradeSwitch{
        Service:   service,
        Method:    method,
        Enabled:   true,
        Reason:    reason,
        StartTime: time.Now(),
        Strategy:  strategy,
    }

    dm.switches.Store(key, switchVal)

    if duration > 0 {
        go dm.autoRecover(service, method, duration)
    }

    klog.Infof("服务降级: %s.%s, 原因: %s", service, method, reason)
    return nil
}

// 手动恢复
func (dm *DegradeManager) Recover(service, method string) error {
    key := serviceKey(service, method)

    if switchVal, ok := dm.switches.Load(key); ok {
        s := switchVal.(*DegradeSwitch)
        s.mu.Lock()
        s.Enabled = false
        s.mu.Unlock()

        klog.Infof("服务恢复: %s.%s", service, method)
    }

    return nil
}

// 自动恢复
func (dm *DegradeManager) autoRecover(service, method string, duration time.Duration) {
    timer := time.NewTimer(duration)
    <-timer.C

    dm.Recover(service, method)
    klog.Infof("服务自动恢复: %s.%s", service, method)
}

// 检查降级条件
func (dm *DegradeManager) checkCondition(cond DegradeCondition) bool {
    dm.mu.RLock()
    defer dm.mu.RUnlock()

    value, exists := dm.metrics[cond.Metric]
    if !exists {
        return false
    }

    switch cond.Operator {
    case ">":
        return value > cond.Threshold
    case ">=":
        return value >= cond.Threshold
    case "<":
        return value < cond.Threshold
    case "<=":
        return value <= cond.Threshold
    case "==":
        return value == cond.Threshold
    default:
        return false
    }
}

// 更新监控指标
func (dm *DegradeManager) UpdateMetrics(metrics map[string]float64) {
    dm.mu.Lock()
    defer dm.mu.Unlock()

    for k, v := range metrics {
        dm.metrics[k] = v
    }

    // 检查是否需要触发自动降级
    dm.checkAutoDegrade()
}

// 检查自动降级
func (dm *DegradeManager) checkAutoDegrade() {
    for _, rule := range dm.rules {
        if !rule.Enabled || rule.Condition.Type == ConditionManual {
            continue
        }

        if dm.checkCondition(rule.Condition) {
            dm.SetDegrade(rule.Service, rule.Method,
                rule.Condition.Type.String(), rule.Strategy, rule.Duration)
        }
    }
}

func serviceKey(service, method string) string {
    return service + "." + method
}

func matchesRule(service, method string, rule DegradeRule) bool {
    if rule.Service != "*" && rule.Service != service {
        return false
    }
    if rule.Method != "*" && rule.Method != method {
        return false
    }
    return true
}
kitex降级中间件
package middleware

import (
    "context"
    "fmt"
    "time"

    "github.com/cloudwego/kitex/pkg/endpoint"
    "github.com/cloudwego/kitex/pkg/klog"
    "github.com/cloudwego/kitex/pkg/rpcinfo"

    "your_project/degrade"  // 导入降级包
)

// 创建服务端降级中间件
func CreateDegradeMiddleware(degradeManager *degrade.DegradeManager) endpoint.Middleware {
    return func(next endpoint.Endpoint) endpoint.Endpoint {
        return func(ctx context.Context, req, resp interface{}) (err error) {
            // 获取服务信息
            ri := rpcinfo.GetRPCInfo(ctx)
            if ri == nil {
                return next(ctx, req, resp)
            }

            service := ri.To().ServiceName()
            method := ri.To().Method()

            // 检查是否降级
            isDegraded, degradeSwitch := degradeManager.IsDegraded(service, method)
            if !isDegraded || degradeSwitch == nil {
                return next(ctx, req, resp)
            }

            klog.Warnf("服务降级中: %s.%s, 原因: %s",
                service, method, degradeSwitch.Reason)

            // 执行降级策略
            return executeDegradeStrategy(ctx, req, resp, degradeSwitch.Strategy)
        }
    }
}

// 执行降级策略
func executeDegradeStrategy(ctx context.Context, req, resp interface{},
    strategy degrade.DegradeStrategy) error {

    switch strategy.Type {
    case degrade.StrategyFastFail:
        return executeFastFail(ctx, req, resp, strategy.Config)

    case degrade.StrategySilent:
        return executeSilent(ctx, req, resp, strategy.Config)

    case degrade.StrategyFallback:
        return executeFallback(ctx, req, resp, strategy)

    case degrade.StrategyCache:
        return executeCache(ctx, req, resp, strategy.Config)

    case degrade.StrategyTimeout:
        return executeTimeout(ctx, req, resp, strategy.Config)

    case degrade.StrategyRetry:
        return executeRetry(ctx, req, resp, strategy.Config)

    default:
        return executeDefault(ctx, req, resp)
    }
}

// 快速失败策略
func executeFastFail(ctx context.Context, req, resp interface{},
    config map[string]interface{}) error {

    // 直接返回错误
    errorMsg := "服务暂时不可用,请稍后重试"
    if msg, ok := config["error_message"]; ok {
        errorMsg = msg.(string)
    }

    klog.Warnf("快速失败降级: %s", errorMsg)
    return fmt.Errorf(errorMsg)
}

// 静默处理策略
func executeSilent(ctx context.Context, req, resp interface{},
    config map[string]interface{}) error {

    // 返回默认值,不报错
    klog.Info("静默降级: 返回默认值")

    // 根据响应类型设置默认值
    // 这里需要根据具体的响应类型来设置
    // 例如:if r, ok := resp.(*YourResponse); ok { ... }

    return nil
}

// 备用方案策略
func executeFallback(ctx context.Context, req, resp interface{},
    strategy degrade.DegradeStrategy) error {

    if strategy.Fallback == nil {
        return fmt.Errorf("降级策略未定义备用方案")
    }

    klog.Info("执行备用方案降级")

    // 执行备用方案
    fallbackResp, err := strategy.Fallback(ctx, req)
    if err != nil {
        klog.Errorf("备用方案执行失败: %v", err)
        return err
    }

    // 复制响应
    // 这里需要根据具体的类型来复制
    // 例如:resp = fallbackResp

    return nil
}

// 缓存降级策略
func executeCache(ctx context.Context, req, resp interface{},
    config map[string]interface{}) error {

    cacheKey := generateCacheKey(req)
    ttl := 5 * time.Minute

    if ttlStr, ok := config["ttl"]; ok {
        if d, err := time.ParseDuration(ttlStr.(string)); err == nil {
            ttl = d
        }
    }

    klog.Infof("缓存降级: key=%s, ttl=%v", cacheKey, ttl)

    // 从缓存获取数据
    cachedData := getFromCache(cacheKey)
    if cachedData != nil {
        // 设置响应
        // resp = cachedData
        klog.Info("缓存降级: 返回缓存数据")
        return nil
    }

    // 缓存未命中,返回默认值
    klog.Warn("缓存降级: 缓存未命中,返回默认值")
    return nil
}

// 超时降级策略
func executeTimeout(ctx context.Context, req, resp interface{},
    config map[string]interface{}) error {

    timeout := 100 * time.Millisecond
    if timeoutStr, ok := config["timeout"]; ok {
        if d, err := time.ParseDuration(timeoutStr.(string)); err == nil {
            timeout = d
        }
    }

    klog.Infof("超时降级: timeout=%v", timeout)

    // 设置超时上下文
    ctx, cancel := context.WithTimeout(ctx, timeout)
    defer cancel()

    // 尝试快速处理
    done := make(chan error, 1)
    go func() {
        // 这里应该调用正常的处理逻辑
        // 但为了演示,我们直接返回
        done <- nil
    }()

    select {
    case <-ctx.Done():
        klog.Warn("超时降级: 请求超时,返回降级响应")
        return nil
    case err := <-done:
        return err
    }
}

// 重试降级策略
func executeRetry(ctx context.Context, req, resp interface{},
    config map[string]interface{}) error {

    maxRetries := 3
    if retries, ok := config["max_retries"]; ok {
        maxRetries = int(retries.(float64))
    }

    retryDelay := 100 * time.Millisecond
    if delay, ok := config["retry_delay"]; ok {
        if d, err := time.ParseDuration(delay.(string)); err == nil {
            retryDelay = d
        }
    }

    klog.Infof("重试降级: maxRetries=%d, delay=%v", maxRetries, retryDelay)

    var lastErr error
    for i := 0; i < maxRetries; i++ {
        if i > 0 {
            time.Sleep(retryDelay)
        }

        klog.Infof("重试降级: 第 %d 次重试", i+1)

        // 这里应该调用正常的处理逻辑
        // 但为了演示,我们直接返回成功
        if i == maxRetries-1 {
            // 最后一次重试
            klog.Warn("重试降级: 达到最大重试次数,返回降级响应")
            return nil
        }
    }

    return lastErr
}

// 默认降级策略
func executeDefault(ctx context.Context, req, resp interface{}) error {
    klog.Info("默认降级: 返回空响应")
    return nil
}

// 辅助函数
func generateCacheKey(req interface{}) string {
    // 根据请求生成缓存key
    return fmt.Sprintf("cache:%v", req)
}

func getFromCache(key string) interface{} {
    // 模拟从缓存获取数据
    return nil
}
客户端降级中间件
package client

import (
    "context"

    "github.com/cloudwego/kitex/client"
    "github.com/cloudwego/kitex/pkg/endpoint"
    "github.com/cloudwego/kitex/pkg/klog"
    "github.com/cloudwego/kitex/pkg/rpcinfo"
)

// 客户端降级中间件
func ClientDegradeMiddleware(degradeManager *degrade.DegradeManager) client.Middleware {
    return func(next endpoint.Endpoint) endpoint.Endpoint {
        return func(ctx context.Context, req, resp interface{}) error {
            // 获取调用的服务信息
            ri := rpcinfo.GetRPCInfo(ctx)
            if ri == nil {
                return next(ctx, req, resp)
            }

            service := ri.To().ServiceName()
            method := ri.To().Method()

            // 检查是否降级
            isDegraded, degradeSwitch := degradeManager.IsDegraded(service, method)
            if !isDegraded || degradeSwitch == nil {
                return next(ctx, req, resp)
            }

            klog.Warnf("客户端降级: 服务 %s.%s 已降级,原因: %s",
                service, method, degradeSwitch.Reason)

            // 执行客户端降级策略
            switch degradeSwitch.Strategy.Type {
            case degrade.StrategyFastFail:
                // 快速失败,不发起调用
                return fmt.Errorf("服务 %s 已降级,调用失败", service)

            case degrade.StrategyFallback:
                // 执行备用方案
                if degradeSwitch.Strategy.Fallback != nil {
                    fallbackResp, err := degradeSwitch.Strategy.Fallback(ctx, req)
                    if err == nil {
                        // 复制响应
                        // resp = fallbackResp
                        klog.Info("客户端降级: 执行备用方案成功")
                        return nil
                    }
                }
                return fmt.Errorf("服务 %s 已降级,且无备用方案", service)

            default:
                // 其他策略,尝试调用
                klog.Info("客户端降级: 尝试调用已降级服务")
                return next(ctx, req, resp)
            }
        }
    }
}
评论
留言与讨论 ↗欢迎留下想法或问题。这里承接旧站已有评论。
正在加载评论…