前置并发知识
并发
生产者&消费者 模型
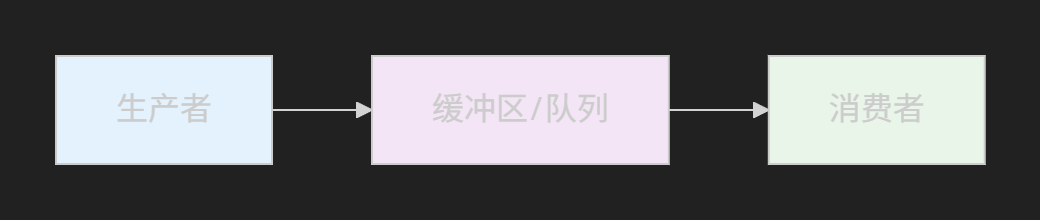
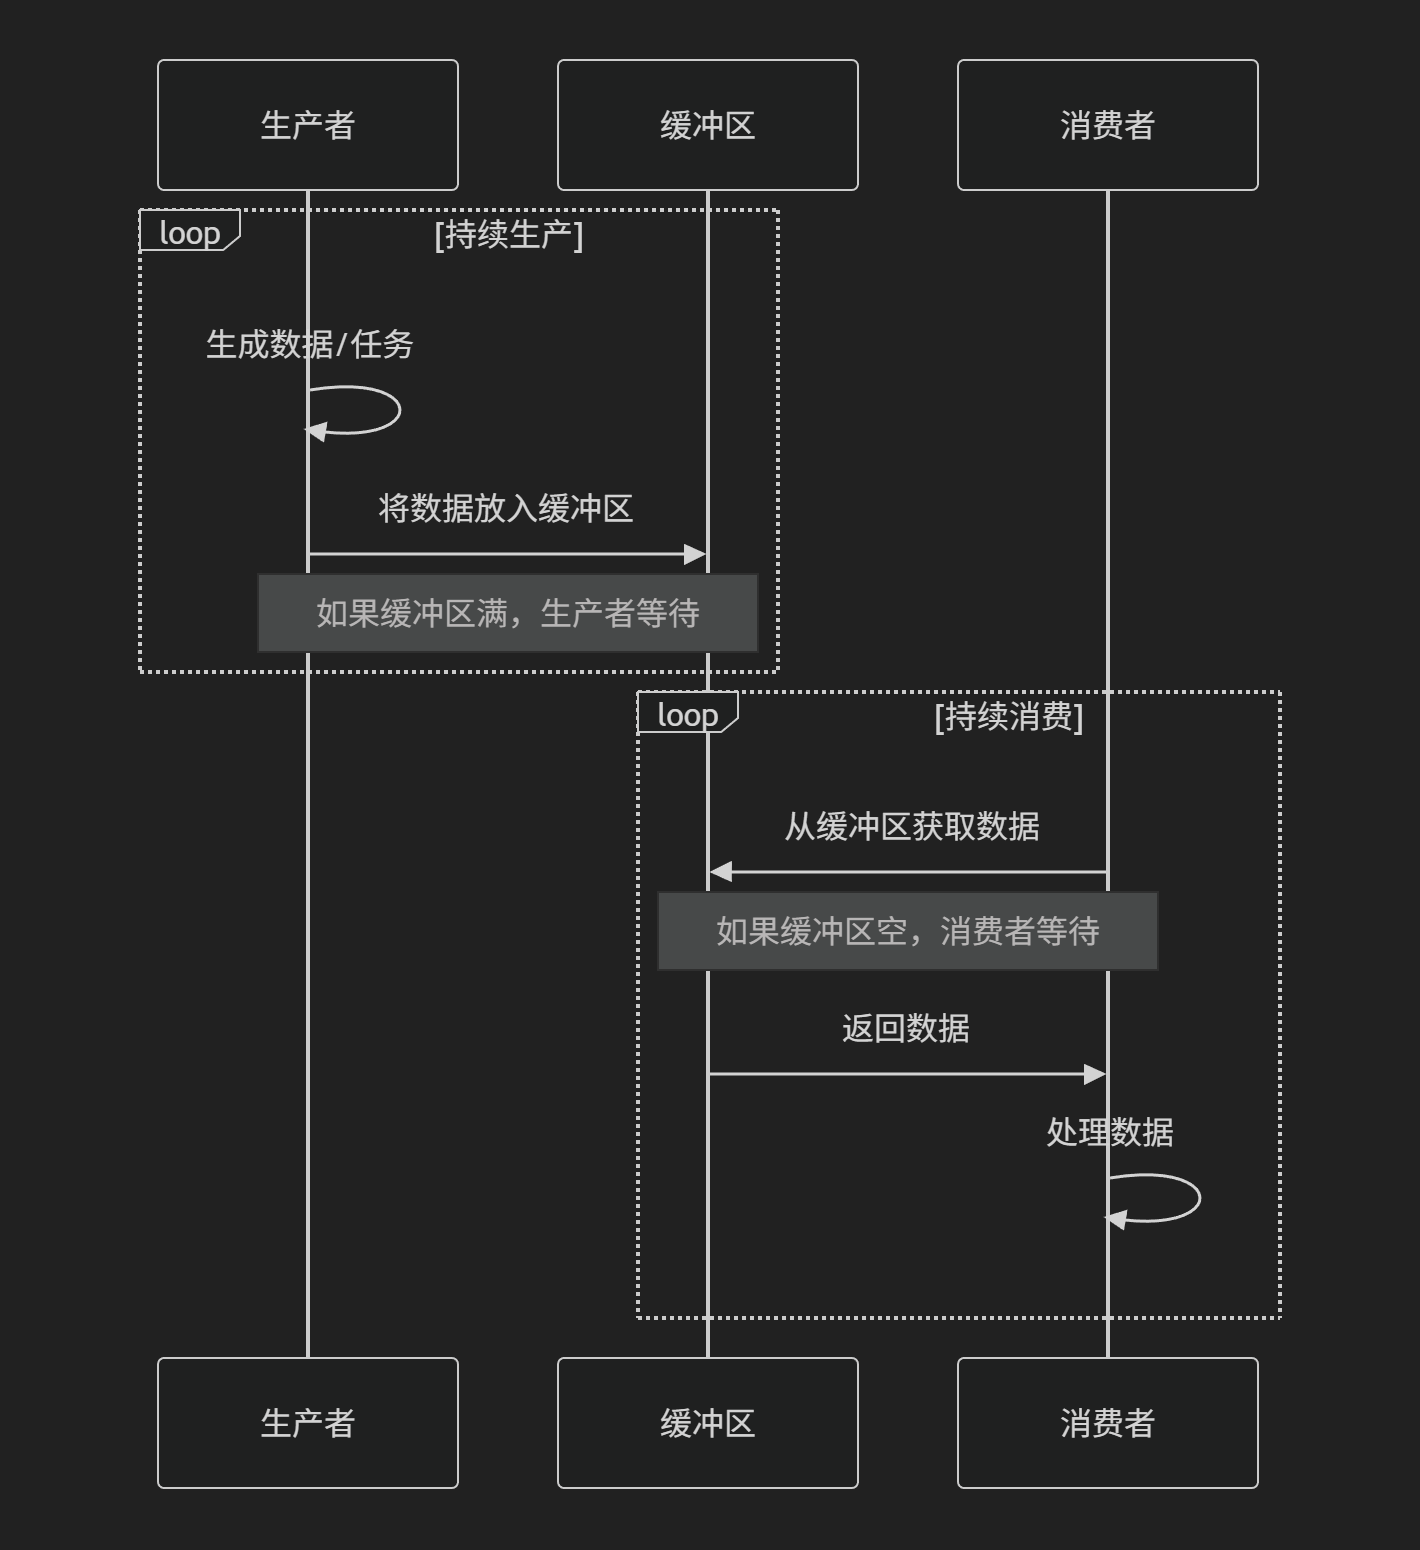
生产者-消费者模型是一种经典的并发编程模式,通过缓冲区解耦生产者和消费者,使它们可以独立、异步地工作。
核心组件
生产者(Producer)
数据的产生者
负责创建任务或数据
将数据放入缓冲区
消费者(Consumer)
数据的处理者
从缓冲区获取数据
执行具体的业务逻辑
缓冲区(Buffer/Queue)
生产者和消费者之间的桥梁
平衡生产速度和消费速度的差异
提供流量控制和数据暂存
任务分发的必要性
为什么需要任务分发?
直接创建Goroutine的问题:
// ❌ 不推荐:无限制创建goroutine
for i := 0; i < 10000; i++ {
    go processTask(i)  // 可能创建过多goroutine!
}问题分析:
- 资源耗尽 - 内存、CPU过载
- 调度开销 - 上下文切换成本高
- 难以管理 - 无法控制并发数量
`
协程池
梗概
什么是协程池?
协程池是一种复用Goroutine的技术,通过预先创建固定数量的工作协程,重复使用它们来处理任务,避免频繁创建和销毁的开销。
核心思想
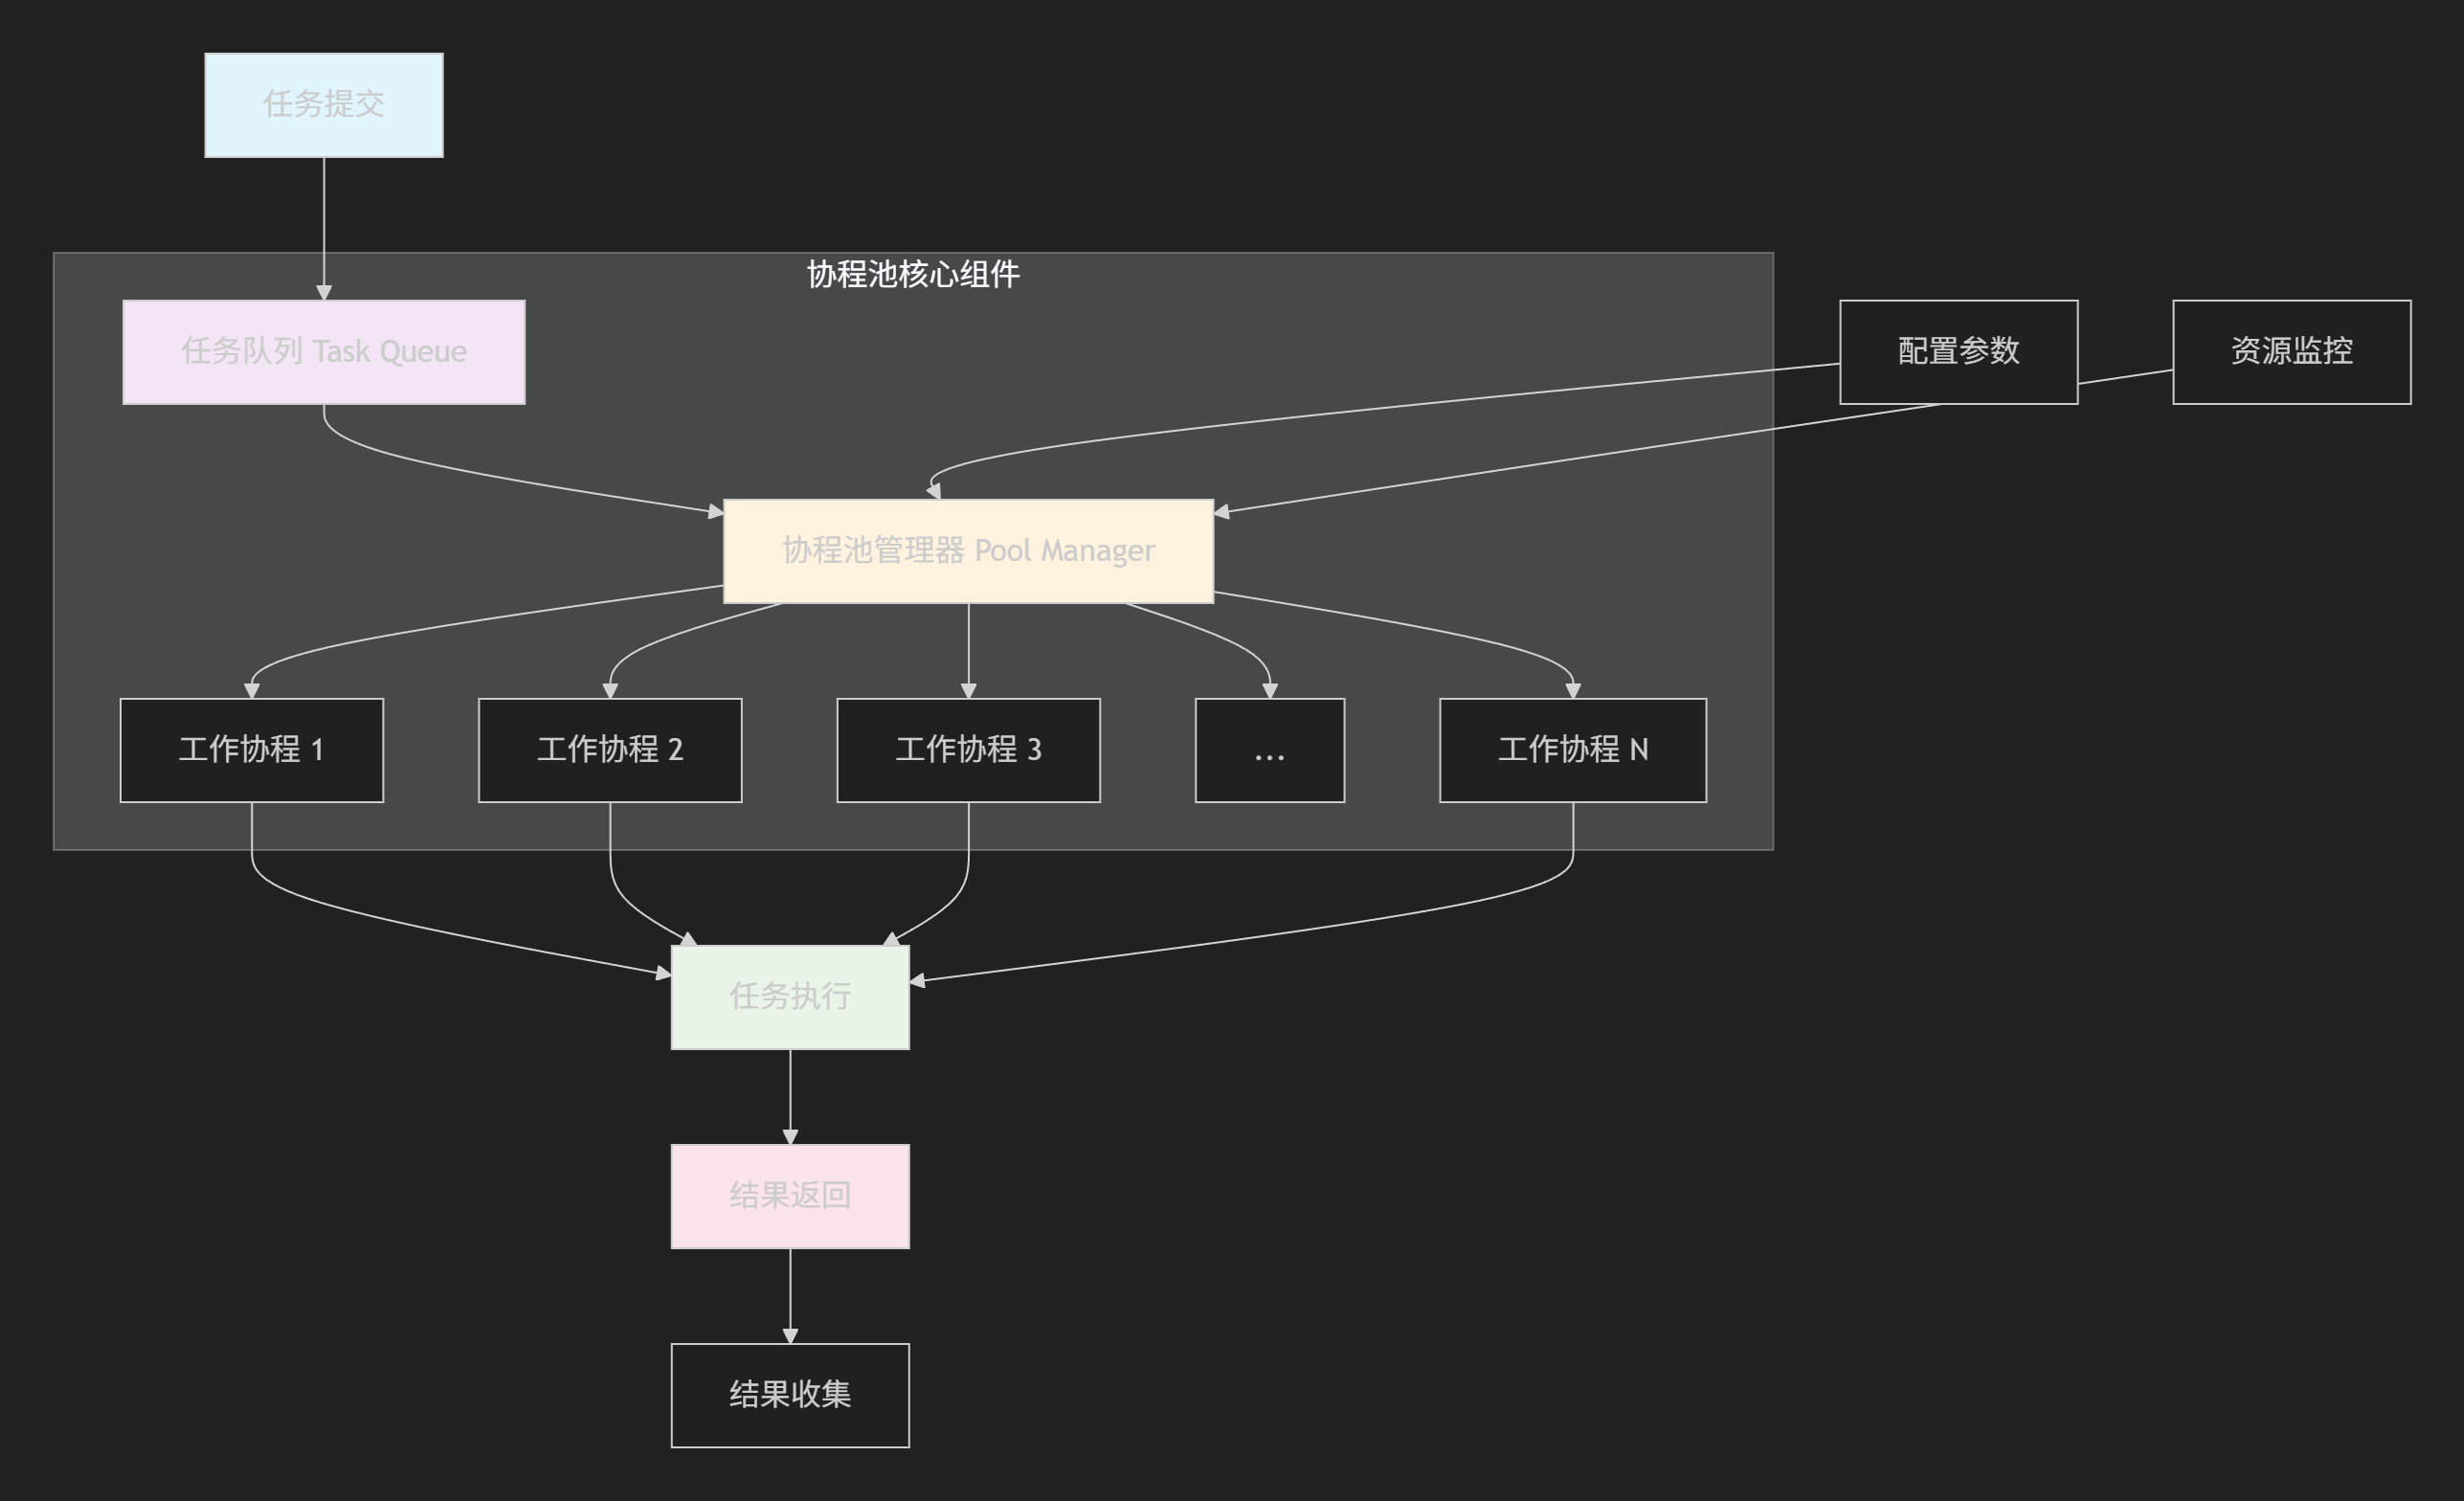
生产者-消费者模型的扩展:
- 生产者:提交任务到任务队列
- 消费者:工作协程从队列获取任务执行
- 缓冲区:任务队列平衡生产消费速度
实现思路
核心组件设计
type WorkerPool struct {
    taskChan    chan Task      // 任务通道(缓冲队列)
    resultChan  chan Result    // 结果通道
    stopChan    chan struct{}  // 停止信号
    wg          sync.WaitGroup // 等待组(协调goroutine)

    // 统计信息(原子操作保证线程安全)
    SubmitSum   int64  // 已提交任务数
    CompleteSum int64  // 已完成任务数
}
工作流程
- 初始化阶段:创建指定数量的worker
- 任务提交:生产者向taskChan发送任务
- 任务处理:worker从taskChan接收并执行
- 结果收集:处理结果发送到resultChan
- 优雅关闭:通过stopChan协调关闭
代码实现
核心结构定义
package workerPool

import (
    "errors"
    "runtime"
    "sync"
    "sync/atomic"
)

// TaskFunc 任务函数类型
type TaskFunc func() (interface{}, error)

// Task 任务结构
type Task struct {
    ID   int      // 任务ID(用于追踪)
    Func TaskFunc // 要执行的任务函数
}

// TaskResult 任务执行结果
type TaskResult struct {
    ID     int         // 对应任务ID
    Result interface{} // 执行结果
    Err    error       // 错误信息
}

// WorkerPool 协程池主体
type WorkerPool struct {
    taskChan    chan Task      // 任务通道(缓冲队列)
    resultChan  chan TaskResult // 结果通道
    stopChan    chan struct{}   // 停止信号通道
    wg          sync.WaitGroup  // 等待组(协调goroutine生命周期)
    // 原子操作统计(线程安全)
    SubmitSum   int64  // 已提交任务总数
    CompleteSum int64  // 已完成任务总数
}
初始化协程池
// NewWorkerPool 创建新的协程池

func NewWorkerPool(workerCount, queueSize int) *WorkerPool {
    // 参数校验和默认值设置
    if workerCount < 1 {
        workerCount = runtime.NumCPU() * 2  // 默认:CPU核心数×2
    }

    if queueSize < workerCount {
        queueSize = workerCount * 100  // 默认队列大小:worker数×100
    }

    // 初始化协程池实例
    pool := &WorkerPool{
        taskChan:   make(chan Task, queueSize),     // 带缓冲的任务通道
        resultChan: make(chan TaskResult, queueSize), // 带缓冲的结果通道
        stopChan:   make(chan struct{}),             // 无缓冲停止信号
    }

    // 创建worker协程
    for i := 0; i < workerCount; i++ {
        pool.wg.Add(1)
        go pool.worker()  // 启动worker goroutine
    }

    return pool
}
生产者:提交任务
// Produce 提交任务到协程池(生产者)

func (p *WorkerPool) Produce(taskFunc TaskFunc) error {
    // 封装任务
    task := Task{
        ID:   int(atomic.AddInt64(&p.SubmitSum, 1)), // 原子操作生成任务ID
        Func: taskFunc,
    }

    // 非阻塞发送任务
    select {
        case p.taskChan <- task:  // 正常提交
            return nil
        case <-p.stopChan:        // 协程池已关闭
            return errors.New("pool stopped")
    }
}
消费者:工作协程
// worker 工作协程(消费者)

func (p *WorkerPool) worker() {
    defer p.wg.Done()  // 确保goroutine结束时通知WaitGroup

    for {
        select {
            case task, ok := <-p.taskChan:
                if !ok {  // 通道已关闭且无剩余任务
					return
                }
				// 执行具体任务
                result, err := task.Func()
                // 发送处理结果
				p.resultChan <- TaskResult{
					ID:     task.ID,
					Result: result,
					Err:    err,
				}
				// 原子操作更新完成计数
				atomic.AddInt64(&p.CompleteSum, 1)
			case <-p.stopChan:  // 收到停止信号
                return
            }
    }
}
结果收集和管理
// GetResults 获取结果通道(只读)

func (p *WorkerPool) GetResults() <-chan TaskResult {
    return p.resultChan
}

// GetInfo 获取统计信息(线程安全)

func (p *WorkerPool) GetInfo() (int64, int64) {
    return atomic.LoadInt64(&p.SubmitSum), atomic.LoadInt64(&p.CompleteSum)
}

// Close 优雅关闭协程池

func (p *WorkerPool) Close() {
    close(p.taskChan)   // 关闭任务通道(停止接收新任务)
    p.wg.Wait()         // 等待所有worker完成任务
    close(p.resultChan) // 关闭结果通道
    close(p.stopChan)   // 关闭停止信号
}
🎯 实战案例:文件关键词搜索
业务逻辑层
package service

import (
    "bufio"
    "fmt"
    "os"
    "strings"
    "sync/atomic"
)

// Result 搜索结果结构

type Result struct {
    Path string      // 文件路径
    Info []LineInfo  // 匹配行信息
    Err  error       // 错误信息
}

// LineInfo 行信息结构

type LineInfo struct {
    Line    int    // 行号
    Content string // 行内容
}

// Task 搜索任务

type Task struct {
    Path    string // 文件路径
    Keyword string // 搜索关键词
}

// Search 文件搜索函数

func Search(task Task) (interface{}, error) {

    // 打开文件

    file, err := os.Open(task.Path)
    if err != nil {
        return Result{
        Path: task.Path,
        Err:  fmt.Errorf("无法打开文件: %v", err),
        }, err
    }
    defer file.Close()

    var info []LineInfo
    scanner := bufio.NewScanner(file)
    lineNum := 0

    // 逐行扫描
    for scanner.Scan() {
    lineNum++
    line := scanner.Text()
        if strings.Contains(line, task.Keyword) {
            info = append(info, LineInfo{
                Line:    lineNum,
                Content: strings.TrimSpace(line),
            })
        }
    }

    // 检查扫描错误
    if err := scanner.Err(); err != nil {
        return Result{
        Path: task.Path,
        Err:  fmt.Errorf("读取文件错误: %v", err),
        }, err
    }

    return Result{
    Path: task.Path,
    Info: info,
    }, nil
}

// 全局统计(原子操作保证线程安全)

var (
    totalFiles int64 // 总文件数
    foundFiles int64 // 包含关键词的文件数
    totalLines int64 // 总匹配行数
)

// SetTotal 设置总文件数

func SetTotal(num int64) {
    atomic.StoreInt64(&totalFiles, num)
}

// AddFound 增加找到的文件计数

func AddFound(num int64) {
    atomic.AddInt64(&foundFiles, num)
}

// AddLines 增加匹配行计数

func AddLines(num int64) {
    atomic.AddInt64(&totalLines, num)
}

// GetInfo 获取统计信息

func GetInfo() (int, int, int) {
    return int(atomic.LoadInt64(&totalFiles)),
    int(atomic.LoadInt64(&foundFiles)),
    int(atomic.LoadInt64(&totalLines))
}
主程序入口
package main

import (
    "Lesson_1/Lanshan-lesson5/service"
    "Lesson_1/Lanshan-lesson5/workerPool"
    "fmt"
    "io/fs"
    "os"
    "path/filepath"
    "runtime"
    "sort"
    "time"
)

    func main() {
    // 参数验证
    if len(os.Args) != 3 {
        fmt.Printf("使用方法: %s [目录路径] [搜索关键词]\n", os.Args[0])
        os.Exit(1)
    }
    dir := os.Args[1]
    keyword := os.Args[2]

    // 目录存在性检查
    if _, err := os.Stat(dir); os.IsNotExist(err) {
        fmt.Printf("目录 '%s' 不存在\n", dir)
        os.Exit(1)
    }

    // 初始化配置
    workerCount := runtime.NumCPU() * 2
    fmt.Printf("搜索目录: '%s', 关键词: '%s'\n", dir, keyword)

    startTime := time.Now()

    // 创建协程池
    pool := workerPool.NewWorkerPool(workerCount, workerCount*100)

    // 遍历目录获取文件列表
    paths, err := walkDirectory(dir)
    if err != nil {
        fmt.Printf("遍历目录错误: %v\n", err)
        os.Exit(1)
    }

    service.SetTotal(int64(len(paths)))
    fmt.Printf("发现文件数: %d\n", len(paths))

    // 结果收集通道
    results := make(chan workerPool.TaskResult, workerCount*100)
    done := make(chan bool, 1)

    // 启动结果收集器
    go collectResults(results, done, len(paths))

    // 提交搜索任务
    submittedTasks := 0
    for _, path := range paths {
        task := service.Task{Path: path, Keyword: keyword}

            err := pool.Produce(func() (interface{}, error) {
                return service.Search(task)
            })

            if err != nil {
                fmt.Printf("任务提交失败: %v\n", err)
            } else {
                submittedTasks++
            }
    }

    fmt.Printf("成功提交任务数: %d\n", submittedTasks)

    // 转发结果
    go forwardResults(pool.GetResults(), results)

    // 等待所有任务完成
    pool.Close()
    close(results)

    <-done // 等待结果收集完成

    // 输出统计信息
    total, found, lines := service.GetInfo()
    elapsed := time.Since(startTime)

    fmt.Printf("\n============= 搜索完成 =============\n")
    fmt.Printf("总文件数: %d\n", total)
    fmt.Printf("包含关键词的文件数: %d\n", found)
    fmt.Printf("总匹配行数: %d\n", lines)
    fmt.Printf("耗时: %v\n", elapsed)

    submitted, completed := pool.GetInfo()
    fmt.Printf("任务提交数: %d\n", submitted)
    fmt.Printf("任务完成数: %d\n", completed)
    }

// walkDirectory 遍历目录获取文件列表

func walkDirectory(dir string) ([]string, error) {
    var paths []string

    err := filepath.WalkDir(dir, func(path string, d fs.DirEntry, err error) error {
        if err != nil {
            fmt.Printf("访问错误 '%s': %v\n", path, err)
            return nil // 跳过错误文件
        }

        if !d.IsDir() {
            paths = append(paths, path)
        }

        return nil
    })

    if err != nil {
        return nil, err
    }

    return paths, nil
}

// forwardResults 结果转发
func forwardResults(source <-chan workerPool.TaskResult, dest chan<- workerPool.TaskResult) {
    for result := range source {
        dest <- result
    }
}

// collectResults 收集和处理结果
func collectResults(results <-chan workerPool.TaskResult, done chan<- bool, total int) {
    var finalResults []service.Result
    processed := 0

    // 处理每个结果
    for result := range results {
        processed++

        // 进度显示
        if processed%100 == 0 {
            progress := float64(processed) / float64(total) * 100
            fmt.Printf("处理进度: %d/%d (%.2f%%)\n", processed, total, progress)
        }

        // 类型断言获取搜索结果
        if searchResult, ok := result.Result.(service.Result); ok {
            finalResults = append(finalResults, searchResult)

            // 更新统计
            if len(searchResult.Info) > 0 {
                service.AddFound(1)
                service.AddLines(int64(len(searchResult.Info)))
            }
        }
    }
	// 输出最终结果
    fmt.Printf("\n================搜索结果================\n")
    printResults(finalResults)
    done <- true
}

// printResults 格式化输出结果
func printResults(results []service.Result) {
    // 按文件路径排序
    sort.Slice(results, func(i, j int) bool {
        return results[i].Path < results[j].Path
    })

    for _, result := range results {
        if result.Err != nil {
            fmt.Printf("\n错误: %s - %v\n", result.Path, result.Err)
            continue
        }
		if len(result.Info) > 0 {
			fmt.Printf("\n%s:\n", result.Path)
			for _, info := range result.Info {
				fmt.Printf("    %d: %s\n", info.Line, info.Content)
			}
		}
    }
}
评论
留言与讨论 ↗欢迎留下想法或问题。这里承接旧站已有评论。
正在加载评论…