前言
我去,怎么15号了?我这产出也太少了,悲。
多少梳理下最近学的东西吧,虽然感觉有点少
AI 扫盲
在接触Agent之前,这么着也得把核心技术AI搞明白吧?
各种基础概念
一来AI部分的各种基础概念和专有名词实在繁多,而挨个解释起来非常麻烦,推荐先看个扫盲视频,下面的解释就一句话带过
LLM
Large Language Model,也就是我们Agent的核心,不再赘述
底层原理
我们还是需要了解一下AI本身的原理到底是什么
无聊时可以简单看些基础科普视频:机器之心:人类放弃了掌控,AI凭什么自己觉醒?、AI焚诀:你赖以生存的AI,到底吃什么长大的?
简单来说,AI(特别是LLM)的底层原理就是基于海量数据的统计学概率预测。AI将prompt拆分成若干字符(token),再根据前面的所有字符,通过向量与高维空间等数学方式,预测下一个最可能出现的字符(Token)是什么
另一个重要的原理是Transformer架构,Transformer 是一种由 Google 团队在 2017 年论文《Attention Is All You Need》中首次提出的深度学习架构,我们之前说过,AI本质上实在根据数学概率做选择,而Transformer就是目前最高效的“概率计算架构”,通过Self-Attention 确定了计算概率时的参考范围、通过 Multi-Head 确定了计算概率时的观察维度、通过Parallelism确定了计算概率的工业效率等
另外的一些的重要参数,比如Temperature,可以决定AI更倾向于选高概率词汇或者倾向于在全部词汇中选择,低温时 AI 变得保守,只选概率最高的,回答稳定但机械,而高温时AI 会尝试选一些概率稍微低一点的词,这赋予了它所谓的“灵感”和“创造力”,但也增加了胡说八道(幻觉)的风险
而如果某次预测Token错误,损失函数(Loss Function) 就会计算这个错误有多大,梯度下降(Gradient Descent) 算法就会微调模型内部数的参数(Weights),让下一次预测其他Token的概率变大,预测这个错误Token的概率变小
模型介绍
我们介绍一下目前主流的模型:
Claude-opus-4.7 max
取代下面介绍的这一条
Claude-opus-4-6
Claude-opus-4-6是当下公认的性能(编程)最高的供公开使用的LLM(现Claude-opus-4.7 max),由A(Anthropic)公司研发,有着100万的上下文窗口,不过由于政策原因,该公司旗下的所有模型均不正式对国内开放,不过我们可以通过接号平台和Visa支付等方式创建非国内账号并购买Coding Plan(可以理解为模型使用的月卡)和Token
优点是性能顶尖,缺点是模型昂贵,API 价格为每百万输入 Token $5.00,输出 $25.00,且使用较麻烦
GLM-5.1
GLM-5.1是目前国内基本最好的LLM,由智谱 AI研发,有20万上下文窗口,特点是极高的性价比和开源属性,API 价格仅约为每百万输入 $1.00,输出 $3.20,且有40元左右的Coding Plan和特价资源包,但是目前国内的Coding Plan每日限量,比较难买
优点是以 1/10 的价格提供 6070% 的 Opus 性能,但缺点也是只有6070% 的 Opus 性能,用过opus再用GLM会有明显落差
其他模型
其他主流模型包括国外OpenAI的ChatGPT(chat)、codex(Coding)和谷歌的Gemini;以及国内的Kimi、Minimax、Deepseek等
不可否认的是国外的模型确实几乎碾压国内模型,因此也成为了模型标杆,GPT、gemini和Cluade系列有着三大模型巨头之称
怎么使用LLM?
要使用LLM,我们需要在想要使用的LLM官网获取该模型系列的API-Key和BaseURL,可以很轻松地获取到
另外,我们需要有对应模型使用额度(Token或调用次数),所以需要购买相对应的Token额度或者Coding Plan
获取这些内容后,我们就能在ChatBox或者集成AI的IDE工具中绑定模型并使用LLM了
中转站
我们之前提到过,由于政策原因,Claude系列模型不对国内开放,因此想使用顶尖的Opus-4-6就很困难,而使用其他的国外模型也比较繁琐,并且国外模型还普遍非常昂贵,这时候,我们就可以使用模型中转站
“中转站”(API 中转站)是一个非常通俗的说法,它的官方称呼通常是 “AI API 聚合服务商” 或 “第三方 API 转发平台”,简单来说,中转站就是一个“API贩子”。它把分散在世界各地的 AI 官方接口(如 Anthropic、OpenAI、Google、智谱 AI 等)整合在一起,再转卖给普通用户或开发者
使用中转站时,模型调用流程变成了你的请求 -> 发送给中转站,中转站 -> 转发给官方(Anthropic/OpenAI),官方 -> 返回结果给中转站,中转站 -> 返回结果给你
中转站的优点十分明显:原官方模型1/7甚至1/14的价格,可以方便地使用全平台的模型等
但与此同时,更需要警惕中转站的缺点:最主要的就是模型的掺水现象和中转站的不稳定性, 有些无良中转站会玩“挂羊头卖狗肉”。比如你调用的是昂贵的 Claude Opus 4.6,他后台偷偷给你换成便宜的 Claude Haiku 或 GPT-3.5,这种行为被称为 “掺水”,且中转站可能随时“跑路”或者因为被封号而导致服务中断
总的来说,中转站可以让我们低成本、低门槛地快速用上 Claude Opus 4.6 或 其他国内外模型,是目前最高效、最省事的方案。但尽量“小额多次充值”,且要注意甄别模型是否掺水
Vibe Coding
所谓Vibe Coding是指开发者不再逐行手写代码,而是通过自然语言向 AI 描述功能需求,由 AI 自动生成完整代码、设计界面并处理逻辑的工作方式。说人话就是用AI写代码
要Vibe Coding,我们不能只用ChatBox让AI生成代码,而是使用专门的工具
Trae
Cursor的国内版,Trae是字节跳动研发的AI 原生集成开发环境(AI IDE),基于 VS Code 构建,可以无缝迁移所有的 VS Code 插件、快捷键和主题配置。且作为国内的AI IDE,可以免费试用GLM等国内最新模型,只不过大多时候需要排队
缺点也是只能免费使用国内模型,总体来说性价比高
Claude Code
Claude Code 是 Anthropic 官方推出的一款AI 原生命令行界面(CLI)工具,它让你可以直接在终端中与 Claude AI 进行交互,完成编码、调试、重构等开发任务,也是目前最主流的Vibe Coding工具,我们可以在Claude Code使用A\本家模型或者使用CC-Switch接入其他模型
CC-Switch
CC-Switch 是一款专门为 Claude Code 以及其他 AI 命令行(CLI)编程工具设计的开源跨平台桌面配置管理工具
我们使用CC-Switch的原因主要是可以灵活管理各种模型和渠道的API-Key和BaseURL,并为ClaudeCode接入第三方模型(如中转站)和国产模型
Chery Studio
这个准确来说不算直接相关Vibe Coding,但是还是提一嘴
Chery Studio是一个公认好用的ChatBox,可以手动集成各家模型,比较方便
AI Agent
而所谓Agent,就是把LLM进行包装,为这个智慧核心添加工具、交互、逻辑等包装,就如同为大脑增加四肢、皮囊。普通的 AI 是“问答式”的,而 AI Agent 是“任务式”的
简单地说,如果你只是调用一个 API(应用程序接口,简单说就是让两个软件互相"对话"的通道)让模型吐字,那只是"用了个 LLM 服务";当你给它加上文件系统、浏览器、代码执行、记忆、任务编排、监控重试……这整套东西组合在一起,才叫一个真正能"干活"的 Agent
在学术界和工业界,目前公认的 AI Agent 公式是:
Agent = 大模型 (LLM) + 规划 (Planning) + 记忆 (Memory) + 工具使用 (Tool Use)
需要注意的是,AI 是一种技术,而 AI Agent 是一种产品形态
AI Agent的一些思想:
ReAct模式
ReAct 是 Reason(推理) + Act(行动) 的缩写。它是目前 AI Agent(智能体)最主流的一种工作模式
简单来说,ReAct 模式让大模型像人类一样思考:先思考(Thought),再行动(Action),然后根据观察到的结果(Observation)进行下一步思考
一个典型的 ReAct 过程示例:
假设你问 AI:“今天罗德岛所在地区的温度适合阿米娅穿外套吗?”
AI:
- Thought (思考):我需要知道罗德岛当前的位置,然后查询该地区的天气
- Action (行动):调用 get_current_location() 工具
- Observation (观察):返回“切尔诺伯格”。
- Thought (思考):现在我知道地点是切尔诺伯格了,我需要查询那里的实时气温
- Action (行动):调用 get_weather(city="Chernobog")
- Observation (观察):返回“气温 -10°C,大雪”
- Thought (思考):气温是 -10°C,非常寒冷。阿米娅必须穿上厚外套
- Final Answer (最终回答):博士,切尔诺伯格现在只有 -10°C,请务必提醒阿米娅穿上厚外套
而在 Go 代码的框架里,ReAct 循环通常表现为一个 for 循环:
for {
    // 将对话历史发给 AI
    resp := chatModel.Generate(messages)

    // AI 返回的内容包含 "Thought" 和 "Action"
    // 如果 AI 说任务完成了,就 break 循环
    if isTaskFinished(resp) {
        fmt.Println(resp.Content)
        break
    }

    // 解析 AI 想要调用的工具 (Action)
    toolResult := callTool(resp.ToolCall)

    // 将工具返回的结果 (Observation) 喂回给 AI
    messages = append(messages, schema.ObservationMessage(toolResult))

    // 进入下一次循环,让 AI 根据 Observation 进行下一次 Thought
}
任务拆解
任务拆解(Task Decomposition) 是指将一个复杂的、模糊的“宏观目标”分解为一系列更小的、可执行的“原子子任务”的过程
如果说 ReAct 是 Agent 的“思考方式”,那么任务拆解就是 Agent 的“规划能力”
多Agent协作
字面意思,一个复杂的任务可由多个Agent协作完成,各个Agent之间可能会呈现某种特殊关系,通常以主管模式(Supervisor Mode)为主
相比于使用单Agent,多Agent协作不仅可以避免Prompt或上下文过于臃肿,也因为模块解耦提升了可拓展性
主管模式
这是最主流的模式(LangGraph 、Eino)。它引入了一个“管理者”的角色。
角色分配:
- 主管 Agent (The Boss):不直接干活。它的工作是:拆解任务、分配任务、检查结果、决定是否结束
- 员工 Agents (The Workers):各个领域的专家(如搜索专家、代码专家、绘图专家)
协作方式:
- 用户发指令给 主管。
- 主管思考:“这个任务需要先搜资料,再写代码”
- 主管下令:“搜索Agent,去查资料。”
- 搜索Agent返回结果给 主管。
- 主管检查后说:“很好,代码Agent,根据这些资料写代码。”
- 代码Agent完成后交给 主管。
- 主管认为达标了,才最终回复用户。
特点:高度灵活。主管可以根据中间结果随时调整策略。如果员工干得不好,主管可以要求重写。
RAG
RAG (Retrieval-Augmented Generation),即检索增强生成
RAG 的核心思想是:让 LLM 在回答问题时,先从外部知识库中检索相关内容,再基于检索结果生成回答,而不是仅依赖模型训练时记住的知识
其工作流程分为三步:
索引(Indexing):将外部知识库(如PDF、数据库、网页)切分成小块,转换为向量并存入向量数据库
检索(Retrieval):当用户提问时,将问题也转换为向量,在向量库中搜索最相关的知识片段
生成(Generation):将检索到的知识片段与原始问题一起送入LLM,生成基于事实的答案
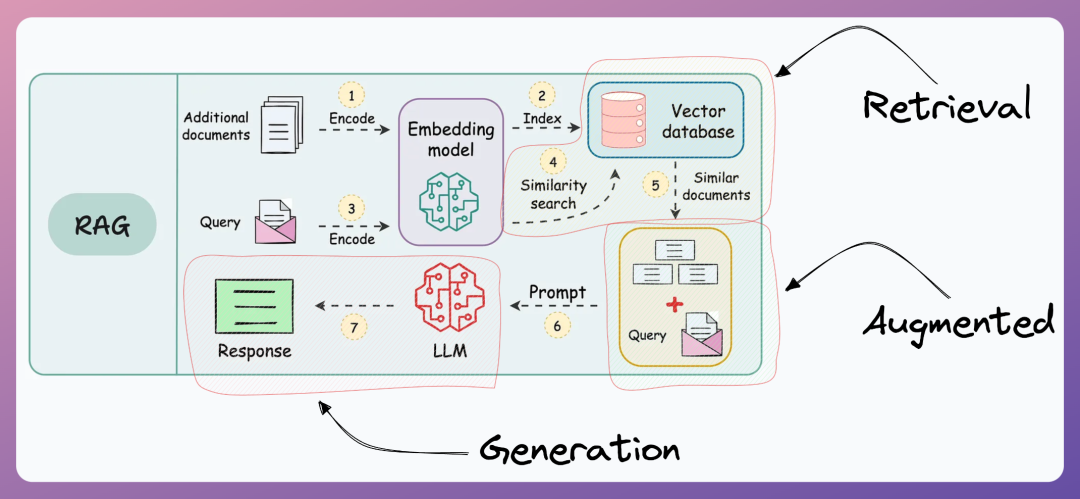
这解决了 LLM 的两个核心痛点:知识截止日期(模型不知道训练后发生的事)和幻觉问题(模型在不确定时会编造答案)
MCP
MCP (Model Context Protocol,模型上下文协议)定义了应用程序和 AI 模型之间交换上下文信息的方式。这使得开发者能够以一致的方式将各种数据源、工具和功能连接到 AI 模型(一个中间协议层),就像 USB-C 让不同设备能够通过相同的接口连接一样。MCP 的目标是创建一个通用标准,使 AI 应用程序的开发和集成变得更加简单和统一
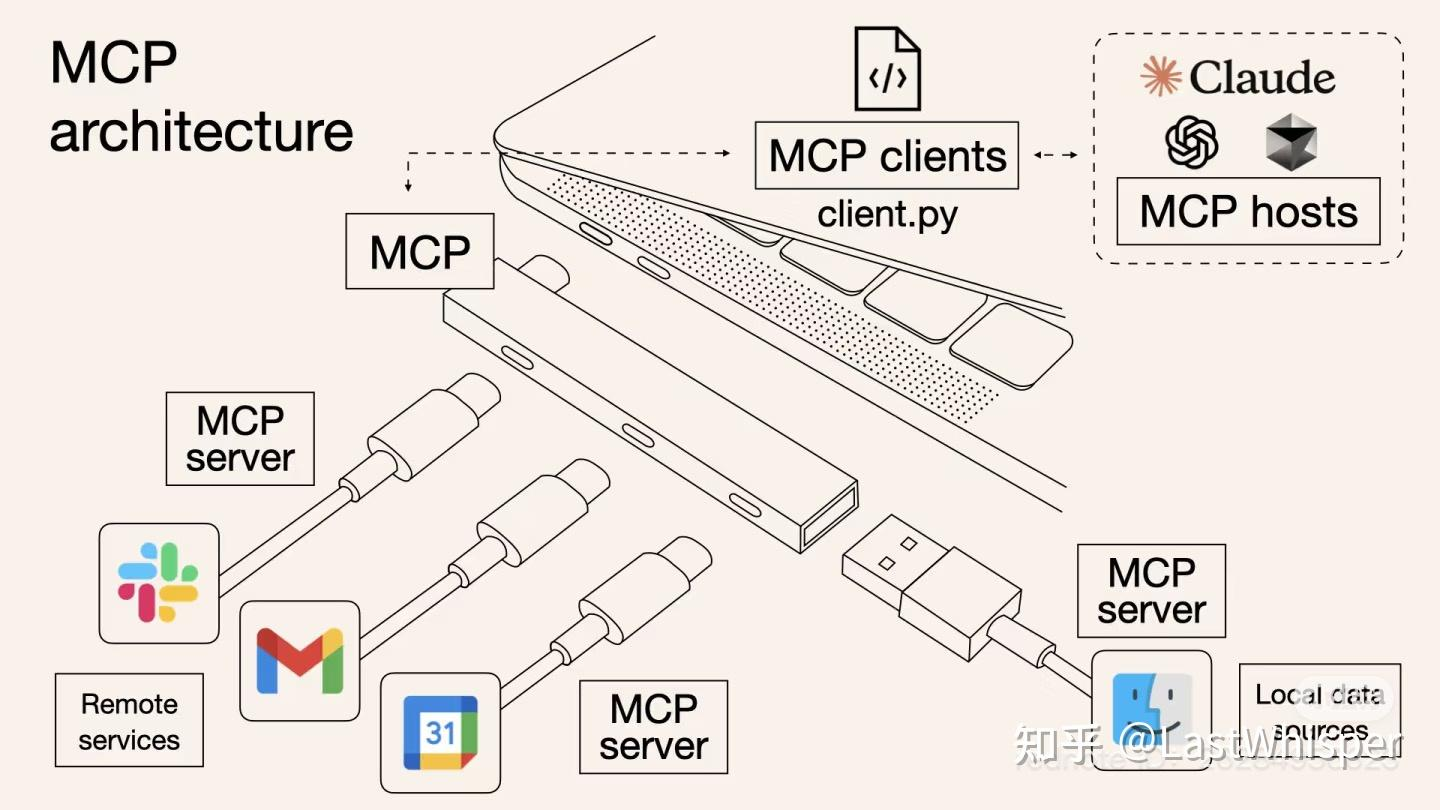
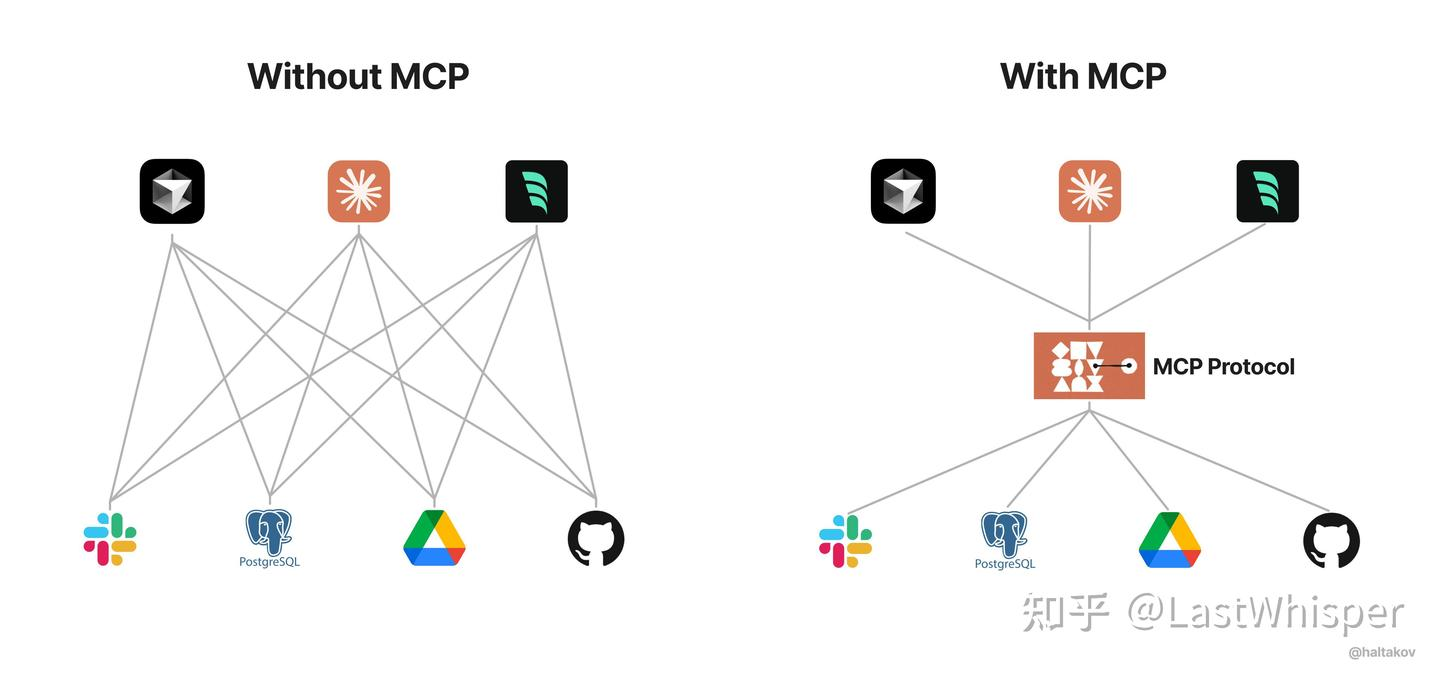
更详细的讲解可以学习这篇文章:MCP (Model Context Protocol),一篇就够了
以及MCP官方介绍:Model Context Protocol
Harness
我们之前说过这样一个定义:
在学术界和工业界,目前公认的 AI Agent 公式是:
Agent = 大模型 (LLM) + 规划 (Planning) + 记忆 (Memory) + 工具使用 (Tool Use)
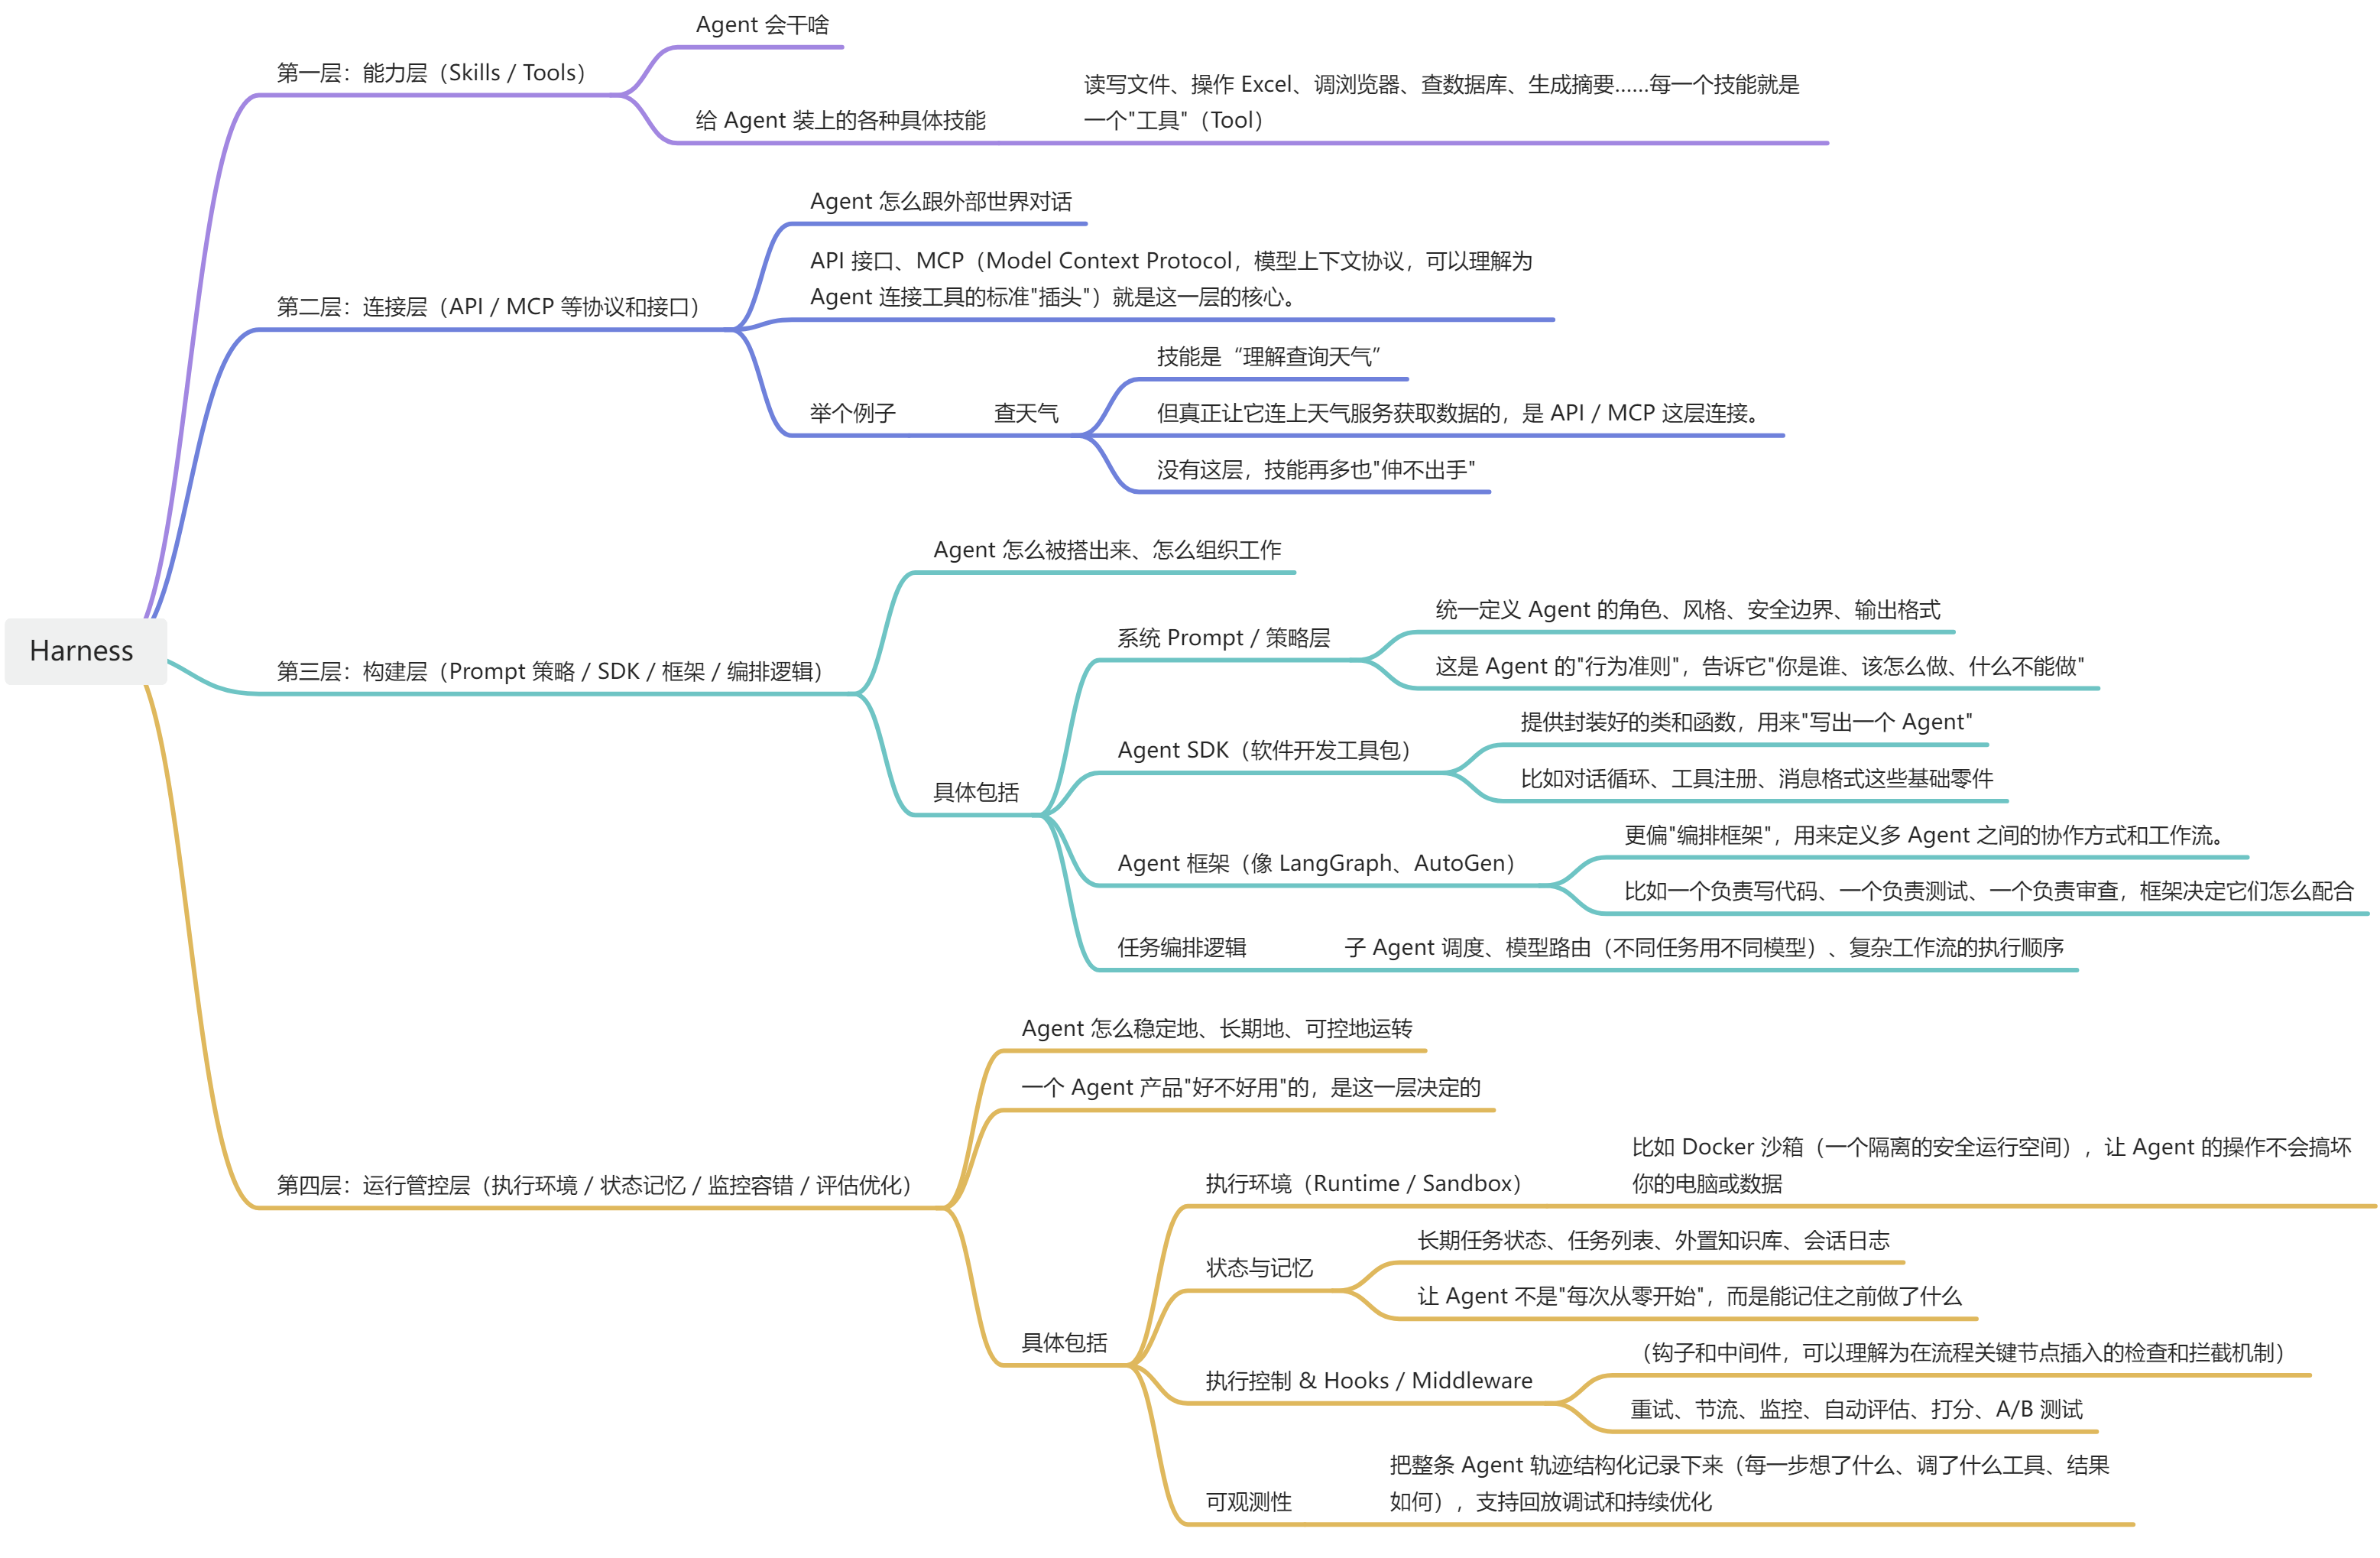
而"Agent Harness" 指的是:包在大模型外面、让它真正能"干活"的那一整套系统。不是模型本身,而是模型以外的一切
所以我们也可以说,Agent = 模型(Model)+ Harness,Harness就是围绕模型这个大脑搭的一切——工具、连接、环境、流程、管控
Skill
简单来说,Skill就是“完成特定任务的标准化、可复用流程”,核心关键词是“明确输入、固定步骤、可预期输出”。它不是单一的“能力”,而是一套“能直接用、能重复用、还能不断优化的具体方法”
你只需要写一份SKILL.md文档并对相应内容做出约束,AI就会根据文档内的要求和约束产生预期的输出,从本质上来说,Skill的核心就是**“拆解+标准化”**
例如,我们写一个「每日站会助手」的Skill:
---
name: daily-standup
description: 每日站会助手。自动总结昨日完成、今日计划、阻塞问题。
---

# 每日站会助手

## 触发条件
当用户提到"站会"、"standup"、"日报"、"周报"时触发。

## 工作流程

### 1. 收集信息
扫描以下内容:
- Git提交记录(昨日至今)
- 项目看板状态变更
- 用户手动补充的阻塞问题

### 2. 生成报告
按以下格式输出:

**昨日完成:**
- [完成的任务1]
- [完成的任务2]

**今日计划:**
- [计划任务1]
- [计划任务2]

**阻塞/风险:**
- [阻塞问题](如无则显示"无")

### 3. 风格适配
- 默认:简洁专业
- 如果用户多次使用,学习其表达风格

## 约束
- 每个条目不超过20字
- 不编造未确认的信息
- 阻塞问题必须标注来源(Git/看板/手动)
随后,我们将skill安装到我们对agent里(Claude Code):cp -r daily-standup-skill .claude/skills/,AI会自动识别到这个Skill,按我们定义的流程执行
这就是Skill的核心设计理念:把经验用文本写下来,让AI按规则执行
由此:
Eino
Eino 是字节跳动研发的一个优秀 LLM 应用开发框架,提供了一个强调简洁性、可扩展性、可靠性与有效性,且更符合 Go 语言编程惯例的 LLM 应用开发框架
我们需要先学习Eino的组件思想和架构使用实例,建议阅读官方文档CloudWeGo | Eino - 概述
以及官方文档“快速开始”部分:CloudWeGo | Eino - 快速开始
搭配官方仓库示例代码:Eino示例代码
需要特别注意的是,我们不仅要看怎么“快速开始”,也要知道Eino大概是怎么封装各种Agent的,理解ReAct循环、任务拆解等关键思想
关于各种Agent设计思想,可以参考这个视频:Agent 的概念、原理与构建模式 —— 从零打造一个简化版的 Claude Code
此处我们便不过多讲解Eino本身的API和ADK了
用Eino搭建Agent
创建智能体
model, _ := openai.NewChatModel(ctx, &openai.ChatModelConfig{
    Model: "GLM-5.1",
    BaseURL: "https://open.bigmodel.cn/api/paas/v4",
    APIKey: "your-apikey",
})

// 创建 Agent
agent, _ := adk.NewChatModelAgent(ctx, &adk.ChatModelAgentConfig{
    Name:        AgentName,
    Instruction: AmiyaInstruction, // Eino会将Instruction注入为SystemPrompt
    Model:       model,
})
值得一提的是,Agent内部不仅封装了ChatModel,也封装了ReAct循环,因此在工具使用部分我们不会再代码中显式看到类似 for { ... call tool ... } 的 ReAct 循环代码
会话和持久化记忆
我们将每次聊天的循环称为一次会话(Session),那么持久化记忆本质上就是将每次会话内容序列化并存储到本地磁盘或者数据库上,我们可以写一个memory.go进行实现,将会话内容存储为SessionMeta和Session,再用Store存储不同的Session信息,并在单个Session信息头部加上特定标识,即可轻松实现这个功能
package memory

import (
	"bufio"
	"encoding/json"
	"fmt"
	"log"
	"os"
	"path/filepath"
	"strings"
	"sync"
	"time"

	"github.com/cloudwego/eino/schema"
)

// 会话元数据
type SessionMeta struct {
	ID        string    `json:"id"`
	Title     string    `json:"title"`
	CreatedAt time.Time `json:"created_at"`
}

type Session struct {
	ID 	  string
	CreatedAt time.Time

	filePath string					 // 会话记忆路径
	mu       sync.Mutex
	messages []*schema.Message       // 消息列表
}

// Append 添加消息到内存并持久化到磁盘
func (s *Session) Append(msg *schema.Message) error {
	s.mu.Lock()
	defer s.mu.Unlock()

	// 合并消息到内存
	s.messages = append(s.messages, msg)

	// 将消息持久化到磁盘
	data, err := json.Marshal(msg)
	if err != nil {
		return err
	}

	file, err := os.OpenFile(s.filePath, os.O_APPEND|os.O_CREATE|os.O_WRONLY, 0o644)
	if err != nil {
		return err
	}
	defer file.Close()

	_, err = file.Write(append(data, '\n'))
	if err != nil {
		return err
	}

	return nil
}

// GetMessages 返回磁盘中存储的消息
func (s *Session) GetMessages() []*schema.Message {
	s.mu.Lock()
	defer s.mu.Unlock()

	msg := make([]*schema.Message, len(s.messages))
	copy(msg, s.messages)
	return msg
}

// GetTitle 从用户消息派生标题
func (s *Session) GetTitle() string {
	s.mu.Lock()
	defer s.mu.Unlock()

	for _, msg := range s.messages {
		if msg.Role == schema.User && msg.Content != "" {
			title := msg.Content
			if len([]rune(title)) > 60 {
				title = string([]rune(title)[:60]) + "..."
			}
			return title
		}
	}

	return "新会话"
}

// 会话管理器
type Store struct {
	sessions map[string]*Session // 会话缓存
	mu       sync.Mutex
	dir 	 string
}

// NewStore 创建新的会话存储
func NewStore(dir string) (*Store, error) {
	if err := os.MkdirAll(dir, 0o755); err != nil {
		return nil, err
	}
	return &Store{
		sessions: make(map[string]*Session),
		dir:      dir,
	}, nil
}

// sessionHeader 每个会话的第一行 JSONL 数据
type SessionHeader struct {
	Type      string    `json:"type"`
	ID        string    `json:"id"`
	CreatedAt time.Time `json:"created_at"`
}

// GetSession 获取或创建会话
func (s *Store) GetSession(id string) (*Session, error) {
	s.mu.Lock()
	defer s.mu.Unlock()

	// 命中缓存
	if session, exists := s.sessions[id]; exists {
		return session, nil
	}

	filepath := filepath.Join(s.dir, id+".jsonl")

	var session *Session
	if _, exists := os.Stat(filepath);os.IsNotExist(exists){ // 如果文件不存在,创建新会话
		log.Printf("会话文件不存在,创建新会话: %s\n", filepath)
		header := SessionHeader{
			Type:      "session",
			ID:        id,
			CreatedAt: time.Now(),
		}
		data, err := json.Marshal(header)
		if err != nil {
			return nil, err
		}

		// 写入文件
		if err := os.WriteFile(filepath, append(data, '\n'), 0o644); err != nil {
			return nil, err
		}
		session = &Session{
			ID:        id,
			CreatedAt: header.CreatedAt,
			filePath:  filepath,
			messages:  make([]*schema.Message, 0),
		}
	}else { // 从磁盘加载会话
		log.Printf("会话文件存在,加载会话: %s\n", filepath)
		file, err := os.Open(filepath)
		if err != nil {
			return nil, err
		}
		defer file.Close()

		scanner := bufio.NewScanner(file)

		// 读取sessionHeader
		if !scanner.Scan() {
			return nil, fmt.Errorf("会话内容为空: %s", filepath)
		}
		var header SessionHeader
		if err := json.Unmarshal(scanner.Bytes(), &header); err != nil {
			return nil, fmt.Errorf("解析会话头部失败: %w", err)
		}

		// 保存SessionHeader
		session = &Session{
			ID:        header.ID,
			CreatedAt: header.CreatedAt,
			filePath:  filepath,
			messages:  make([]*schema.Message, 0),
		}

		// 读取消息
		for scanner.Scan() {
			line := strings.TrimSpace(scanner.Text())
			if line == "" {
				log.Printf("跳过空行\n")
				continue
			}
			var msg schema.Message
			if err := json.Unmarshal([]byte(line), &msg); err != nil {
				log.Printf("解析消息失败,跳过该消息: %s, error: %v\n", line, err)
				continue
			}
			session.messages = append(session.messages, &msg)

			// debug日志,显示加载的消息内容(如果消息过长,则截断显示)
			contentRune := []rune(msg.Content)
			displayContent := string(contentRune)
			if len(contentRune) > 50 {
				displayContent = string(contentRune[:50]) + "..."
			}

			displayContent = strings.ReplaceAll(displayContent, "\n", " ")

			log.Printf("加载历史消息成功: role=%s, content=[%s]\n", msg.Role, displayContent)
		}
	}

	// 将会话加入缓存
	s.sessions[id] = session

	return session, nil
}

// ListSessions 列出所有会话元数据
func (s *Store) ListSessions() ([]SessionMeta, error) {
	s.mu.Lock()
	defer s.mu.Unlock()

	files, err := os.ReadDir(s.dir)
	if err != nil {
		return nil, err
	}

	var sessionMetas []SessionMeta
	for _, file := range files {
		if file.IsDir() || !strings.HasSuffix(file.Name(), ".jsonl") { // 只处理 .jsonl 文件
			continue
		}
		id := strings.TrimSuffix(file.Name(), ".jsonl")

		// 命中缓存
		if session, exists := s.sessions[id]; exists {
			sessionMetas = append(sessionMetas, SessionMeta{
				ID:        session.ID,
				Title:     session.GetTitle(),
				CreatedAt: session.CreatedAt,
			})
			continue
		}

		// 从磁盘加载会话(如果加载失败,则跳过该会话)
		filepath := filepath.Join(s.dir, file.Name())
		localFile, err := os.Open(filepath)
		if err != nil {
			continue
		}
		defer localFile.Close()

		scanner := bufio.NewScanner(localFile)

		// 读取sessionHeader
		if !scanner.Scan() {
			continue
		}
		var header SessionHeader
		if err := json.Unmarshal(scanner.Bytes(), &header); err != nil {
			continue
		}

		// 保存SessionHeader
		session := &Session{
			ID:        header.ID,
			CreatedAt: header.CreatedAt,
			filePath:  filepath,
			messages:  make([]*schema.Message, 0),
		}

		// 读取消息
		for scanner.Scan() {
			line := strings.TrimSpace(scanner.Text())
			if line == "" {
				continue
			}
			var msg schema.Message
			if err := json.Unmarshal([]byte(line), &msg); err != nil {
				continue
			}
			session.messages = append(session.messages, &msg)
		}

		// 添加加载的元数据
		sessionMetas = append(sessionMetas, SessionMeta{
			ID:        session.ID,
			Title:     session.GetTitle(),
			CreatedAt: session.CreatedAt,
		})
	}

	return sessionMetas, nil
}

// DeleteSession 删除会话
func (s *Store) DeleteSession(id string) error {
	s.mu.Lock()
	defer s.mu.Unlock()

	// 从缓存中删除
	delete(s.sessions, id)

	// 从磁盘删除
	filepath := filepath.Join(s.dir, id+".jsonl")
	if err := os.Remove(filepath); err != nil && !os.IsNotExist(err) {
		return err
	}

	return nil
}
工具
通过有关Eino的学习,我们知道Tool有InferTool、NewTool和InvokableTool三种创建方式,分别对应不同繁易程度和颗粒度粗细的Tool创建,我们这里使用DeepAgent自动注册文件管理工具,并用InferTool注册一些简单的方舟工具
另外,如果Model在AgentEvents中调用了工具,那么本次Event中的MessageOutput中Role变量就会被标记为Schema.Tool
首先我们写Tool逻辑
// AmiyAgent/internal/logic/tools.go
package logic

import (
	"context"
	"fmt"
	"strings"
)

type OperatorQueryToolParams struct {
	Name string `json:"name" jsonschema:"description=干员名称,如'能天使'、'银灰'等"`
}

// 查询干员信息伪逻辑
func QueryOperator(ctx context.Context, input *OperatorQueryToolParams) (string, error) {
	operators := map[string]string{
		"能天使":  "【能天使】★★★★★★ | 职业:狙击 | 特长:对空攻击,高射速 | 天赋:攻击速度提升",
		"银灰":   "【银灰】★★★★★★ | 职业:近卫 | 特长:远程斩击 | 天赋:再部署时间缩短",
		"陈":    "【陈】★★★★★★ | 职业:近卫 | 特长:多段爆发攻击 | 天赋:技力恢复速度提升",
		"艾雅法拉": "【艾雅法拉】★★★★★★ | 职业:术师 | 特长:群体法术伤害 | 天赋:法术伤害提升",
		"阿米娅":  "【阿米娅】★★★★★★ | 职业:术师/近卫 | 特长:真实伤害 | 天赋:每次攻击回复技力",
		"德克萨斯": "【德克萨斯】★★★★★ | 职业:先锋 | 特长:产生费用,群体眩晕 | 天赋:初始Cost+1",
		"蓝毒":   "【蓝毒】★★★★★ | 职业:狙击 | 特长:多目标攻击,法术dot伤害 | 天赋:攻击附带法术伤害",
	}

	info, ofk := operators[input.Name]
	if !ofk {
		return fmt.Sprintf("未找到名为'%s'的干员记录", input.Name), nil
	}

	return info, nil
}

type ResourceQueryToolParams struct {
	ResourceType string `json:"resource_type" jsonschema:"description=资源类型,可选值:龙门币、合成玉、理智、源石、全部"`
}

// 查询资源状况伪逻辑
func QueryResources(ctx context.Context, input *ResourceQueryToolParams) (string, error) {
	resources := map[string]string{
		"龙门币": "龙门币: 1,234,567",
		"合成玉": "合成玉: 8,900",
		"理智":  "理智: 130/135(将在 2 小时后回满)",
		"源石":  "源石: 42 个",
	}

	if input.ResourceType == "全部" || input.ResourceType == "" {
		var result strings.Builder
		result.WriteString("=== 罗德岛资源报告 ===\n")
		for _, v := range resources {
			result.WriteString("  " + v + "\n")
		}
		result.WriteString("报告时间:刚刚更新")
		return result.String(), nil
	}

	info, ok := resources[input.ResourceType]
	if !ok {
		return fmt.Sprintf("未知的资源类型: '%s'。支持查询:龙门币、合成玉、理智、源石、全部", input.ResourceType), nil
	}

	return info, nil
}

type BattlePlanToolParams struct {
	StageName  string `json:"stage_name" jsonschema:"description=关卡名称,如'1-7'、'CE-5'、'SK-5'等"`
	Difficulty string `json:"difficulty" jsonschema:"description=难度偏好,可选值:标准、挑战"`
}

// 制定作战计划伪逻辑
func MakeBattlePlan(ctx context.Context, input *BattlePlanToolParams) (string, error) {
	plan := fmt.Sprintf(`=== 作战计划:%s(%s模式)===
推荐编队:
  先锋位:德克萨斯 — 快速获取部署费用
  狙击位:能天使 — 对空防御 + 高DPS
  近卫位:银灰 — 核心输出,关键时刻真银斩
  术师位:艾雅法拉 — 群体法术清场
  医疗位:闪灵 — 全队治疗保障
  重装位:星熊 — 前排抗压

作战要点:
  1. 开局立即部署德克萨斯获取初始费用
  2. 优先在高台部署能天使控制空中威胁
  3. 银灰部署在关键路口,技能 3 留到敌方精英出现时使用
  4. 艾雅法拉在敌方密集时释放火山,最大化群伤

预估理智消耗:%d
预估通关概率:%s`, input.StageName, input.Difficulty, 30, "95%")

	return plan, nil
}然后我们根据逻辑创建[]tool.BaseTool
// AmiyaAgent/Internal/agent/tools.go
package agent

import (
	"AmiyaAgent/internal/logic"
	"log"

	"github.com/cloudwego/eino/components/tool"
	"github.com/cloudwego/eino/components/tool/utils"
)

func InitTools() []tool.BaseTool {
	var tools []tool.BaseTool

	OperatorQueryTool, err := utils.InferTool(
		"operator_query",
		"根据干员名称查询其职业、特长和天赋等基本信息",
		logic.QueryOperator,
	)
	if err != nil {
		log.Print("初始化工具失败:", err)
	}
	log.Println("工具 operator_query 初始化成功")
	tools = append(tools, OperatorQueryTool)

	ResourceQueryTool, err := utils.InferTool(
		"resource_query",
		"查询当前的资源状况,包括龙门币、合成玉、理智、源石等",
		logic.QueryResources,
	)
	if err != nil {
		log.Print("初始化工具失败:", err)
	}
	log.Println("工具 resource_query 初始化成功")
	tools = append(tools, ResourceQueryTool)

	BattlePlanTool, err := utils.InferTool(
		"battle_plan",
		"根据关卡名称和难度偏好制定作战计划,推荐编队和作战要点",
		logic.MakeBattlePlan,
	)
	if err != nil {
		log.Print("初始化工具失败:", err)
	}
	log.Println("工具 battle_plan 初始化成功")
	tools = append(tools, BattlePlanTool)

	return tools
}
在注册工具前记得对工具内必要参数进行说明
// AmiyaAgent/internal/agent/prompt.go
func FileSystemInstruction(agentRoot string) string {
	extInstruction := fmt.Sprintf(`## 文件管理操作说明
	- 重要提示:在使用文件系统工具(如 ls、read_file、glob、grep 等)时,你必须使用绝对路径。
	- 项目根目录为:%s
	- 当博士要求列出“当前目录”中的文件时,请使用路径:%s
	- 当博士要求使用相对路径读取文件时,请通过在前置加上 %s 将其转换为绝对路径。
	- 示例:如果博士说“读取 main.go”,你应该调用 read_file 工具,并将 file_path 参数设为:"%s/main.go")`, agentRoot, agentRoot, agentRoot, agentRoot)

	return extInstruction
}
之后在创建Agent时注册工具,这里使用的是DeepAgent
// AmiyaAgent/internal/agent/agent.go
package agent

import (
	"context"

	"github.com/cloudwego/eino-ext/adk/backend/local"
	"github.com/cloudwego/eino-ext/components/model/openai"
	"github.com/cloudwego/eino/adk"
	"github.com/cloudwego/eino/adk/prebuilt/deep"
	"github.com/cloudwego/eino/compose"
)

func NewDeepAgent(ctx context.Context, model *openai.ChatModel, agentRoot string) (adk.Agent, error) {
	// 创建LocalBackend Tools 后端工具实例
	backend, err := local.NewBackend(ctx, &local.Config{})
	if err != nil {
		return nil, err
	}

	// 创建自定义工具集
	tools := InitTools()
	toolsConfig := adk.ToolsConfig{
		ToolsNodeConfig: compose.ToolsNodeConfig{
			Tools: tools,
		},
	}

	// 获取文件系统操作说明
	extInstruction := FileSystemInstruction(agentRoot)

	// 创建ChatModelAgent类型的Agent实例
	// agentConfig := &adk.ChatModelAgentConfig{
	// 	Name: agent.AmiyaName,
	// 	Description: agent.AmiyaDescription,
	// 	Instruction: agent.AmiyaInstruction,
	// 	Model: chatModel,
	// }
	// agent,err := adk.NewChatModelAgent(ctx,agentConfig)
	// if err != nil {
	// 	log.Fatal("创建 ChatModelAgent 实例失败:", err)
	// }
	// log.Println("ChatModelAgent 实例创建成功")

	// 创建DeepAgent类型的Agent实例
	agentConfig := &deep.Config{
		Name:           AmiyaName,
		Description:    AmiyaDescription,
		Instruction:    AmiyaInstruction + "\n\n" + extInstruction, // 将文件操作说明添加到系统提示词中
		ChatModel:      model,
		ToolsConfig:    toolsConfig,
		Backend:        backend, // 注入LocalBackend工具集
		StreamingShell: backend, // 支持流式 Shell 输出
		MaxIteration:   50,      // 最大思考/工具调用循环次数
	}
	agent, err := deep.New(ctx, agentConfig)
	if err != nil {
		return nil, err
	}

	return agent, nil
}
最后在主程序中定制流式输出工具日志
// AmiyaAgent/cmd/main.go
package main

import (
	"AmiyaAgent/internal/agent"
	"AmiyaAgent/internal/component"
	"bufio"
	"bytes"
	"context"
	"encoding/json"
	"errors"
	"fmt"
	"io"
	"log"
	"os"
	"path/filepath"
	"strings"

	"github.com/cloudwego/eino/adk"
	"github.com/cloudwego/eino/schema"
	"github.com/google/uuid"
	"github.com/joho/godotenv"
)


func main() {
	// 初始化上下文
	ctx := context.Background()

	// 获取apiKey等环境变量并封装为config
	err := godotenv.Load()
	if err != nil {
		log.Println("未找到 .env 文件,使用系统环境变量")
	}
	apiKey, baseURL, modelName, sessionDir,agentRoot := os.Getenv("OPENAI_API_KEY"), os.Getenv("OPENAI_BASE_URL"), os.Getenv("OPENAI_MODEL_NAME"), os.Getenv("SESSION_DIR"), os.Getenv("AGENT_ROOT")
	if apiKey == "" || baseURL == "" || modelName == "" || sessionDir == "" || agentRoot == "" {
		log.Fatal("请设置环境变量")
	}

	// 创建 ChatModel 实例
	chatModel, err := component.NewChatModel(ctx, apiKey, baseURL, modelName)
	if err != nil {
		log.Fatal("创建 ChatModel 实例失败:", err)
	}
	log.Println("ChatModel 实例创建成功")

	// 获取Agent绝对路径
	if abs, err := filepath.Abs(agentRoot); err == nil {
		agentRoot = abs
	}

	// 创建 DeepAgent 实例
	agent, err := agent.NewDeepAgent(ctx, chatModel, agentRoot)
	if err != nil {
		log.Fatal("创建 DeepAgent 实例失败:", err)
	}
	log.Println("DeepAgent 实例创建成功")

	// 创建agentRunner实例
	runner := adk.NewRunner(ctx, adk.RunnerConfig{
		Agent:           agent,
		EnableStreaming: true,
	})
	log.Println("AgentRunner 实例创建成功")

	// 创建会话存储
	store, err := component.NewStore(sessionDir)
	if err != nil {
		log.Fatal("创建会话存储失败:", err)
	}
	log.Println("会话存储创建成功")

	var sessionID string
	fmt.Print("请输入会话ID(留空则创建新会话): ")
	fmt.Scanln(&sessionID)

	// 处理会话 ID
	if sessionID == "" { // 如果为空,生成新 UUID
		sessionID = uuid.New().String()
		fmt.Printf("创建新会话: %s\n", sessionID)
	} else {
		fmt.Printf("恢复会话: %s\n", sessionID)
	}

	// 获取或创建会话
	session, err := store.GetSession(sessionID)
	if err != nil {
		log.Fatal("获取或创建会话失败:", err)
	}
	log.Println("会话获取或创建成功")

	// 启动对话
	fmt.Println()
	fmt.Println("===============================================开始对话(当前会话标题:" + session.GetTitle() + ")=======================================================")
	fmt.Println()
	fmt.Println("阿米娅: 博士,您好!我是阿米娅,有什么需要我帮忙的吗?")
	fmt.Println()

	//log.Println("")

	scanner := bufio.NewScanner(os.Stdin)
	for {
		fmt.Print("博士:")
		if !scanner.Scan() {
			break
		}

		fmt.Println()

		input := strings.TrimSpace(scanner.Text())
		if input == "" {
			continue
		}

		// 封装用户消息
		userMsg := schema.UserMessage(input)
		if err := session.Append(userMsg); err != nil { // 将消息保存到会话
			log.Println("保存用户消息失败:", err)
			continue
		}

		// 获取当前会话的消息历史
		messages := session.GetMessages()

		// 调用 AgentRunner 生成回复
		fmt.Print("阿米娅:")
		events := runner.Run(ctx, messages)
		content, err := getAssistantMsg(events)
		if err != nil {
			log.Println("生成回复失败:", err)
			// 回滚消息历史
			messages = messages[:len(messages)-1]
			continue
		}

		// 将模型回复加入对话历史
		err = session.Append(schema.AssistantMessage(content, nil))
		if err != nil {
			log.Println("保存助手消息失败:", err)
			continue
		}

		fmt.Println()
	}
	if err := scanner.Err(); err != nil {
		_, _ = fmt.Fprintln(os.Stderr, err)
		os.Exit(1)
	}

	fmt.Printf("\n\n会话已保存,会话ID:%s\n", sessionID)
}

func getAssistantMsg(events *adk.AsyncIterator[*adk.AgentEvent]) (string, error) {
	// 创建一个字符串构建器,用于累积所有回复内容
	var builder strings.Builder

	// 循环遍历事件迭代器中的所有事件
	for {
		// 从迭代器中获取下一个事件
		event, ok := events.Next()
		if !ok {
			break
		}

		// 检查事件中是否包含错误
		if event.Err != nil {
			return "", event.Err
		}

		// 检查事件的输出是否为空或消息输出为空
		if event.Output == nil || event.Output.MessageOutput == nil {
			continue
		}

		// 获取消息输出对象,简化后续代码
		msg := event.Output.MessageOutput

		// 若本次消息为工具调用结果,则提取工具输出内容并打印(不累积到最终回复中)
		if msg.Role == schema.Tool {
			content := getToolMsg(msg)
			fmt.Printf("[调用工具结果] %s\n", truncate(content, 200))
			continue
		}

		// 只处理Assistant消息
		if msg.Role != schema.Assistant {
			continue
		}

		// 检查消息是否为流式传输
		if msg.IsStreaming {
			// 设置消息流为自动关闭模式
			msg.MessageStream.SetAutomaticClose()

			// 初始化工具收集器
			var toolCalls []schema.ToolCall

			// 循环接收流中的每一帧数据
			for {
				// 从流中接收一帧数据
				frame, err := msg.MessageStream.Recv()

				// 表示流已完全接收,正常退出循环
				if errors.Is(err, io.EOF) {
					break
				}

				// 返回错误
				if err != nil {
					return "", err
				}

				// 检查帧数据是否有效
				if frame != nil {
					// AI正在生成的文字内容
					if frame.Content != "" {
						// 将帧内容添加到字符串构建器中
						builder.WriteString(frame.Content)
						// 同时将内容实时打印到标准输出(不换行)
						_, _ = fmt.Fprint(os.Stdout, frame.Content)
					}
					// 收集AI想要调用的工具
					if len(frame.ToolCalls) > 0 {
						toolCalls = append(toolCalls, frame.ToolCalls...)
					}
				}
			}
			// 打印工具调用信息
			for _, toolCall := range toolCalls {
				if toolCall.Function.Name != "" && toolCall.Function.Arguments != "" {
					fmt.Printf("\n[调用工具] %s(%s)\n", toolCall.Function.Name, toolCall.Function.Arguments)
				}
			}
			// 流处理完毕后,打印一个换行符
			_, _ = fmt.Fprintln(os.Stdout)
			continue
		}

		// 处理非流式消息(一次性返回的完整消息)
		if msg.Message != nil {
			// 将消息内容添加到字符串构建器中
			builder.WriteString(msg.Message.Content)
			// 将消息内容打印到标准输出(带换行符)
			_, _ = fmt.Fprintln(os.Stdout, msg.Message.Content)
		} else {
			// 如果消息为空,仅打印一个空行
			_, _ = fmt.Fprintln(os.Stdout)
		}
	}

	// 返回累积的所有助手回复内容
	return builder.String(), nil
}

// getToolMsg 从流式消息变量中提取完整的工具结果字符串
func getToolMsg(msg *adk.MessageVariant) string {
	if msg.IsStreaming && msg.MessageStream != nil {
		var builder strings.Builder
		for {
			chunk, err := msg.MessageStream.Recv()
			if errors.Is(err, io.EOF) {
				break
			}
			if err != nil {
				break
			}
			if chunk != nil && chunk.Content != "" {
				builder.WriteString(chunk.Content)
			}
		}
		return builder.String()
	}
	if msg.Message != nil {
		return msg.Message.Content
	}
	return ""
}

// truncate 辅助函数:截断超长字符串,用于控制台预览
func truncate(s string, maxLen int) string {
	if len(s) <= maxLen {
		return s
	}
	// 尝试压缩 JSON 格式后再截断
	var result bytes.Buffer
	if err := json.Compact(&result, []byte(s)); err == nil {
		s = result.String()
	}
	if len(s) <= maxLen {
		return s
	}
	return s[:maxLen] + "..."
}
Middleware
MiddleWare可以在Agent运行前后入自定义逻辑,由此我们可以实现拦截错误为错误字符串,遇错重试等策略
我们先新建Middleware.go:
// AmiyaAgent/internal/component/middleware.go
package component

import (
	"context"
	"errors"
	"fmt"
	"io"

	"github.com/cloudwego/eino/adk"
	"github.com/cloudwego/eino/components/tool"
	"github.com/cloudwego/eino/compose"
	"github.com/cloudwego/eino/schema"
)

// safeToolMiddleware 是一个自定义中间件,用于安全地处理工具调用错误
// 它将工具执行错误转换为可读的错误消息,而不是中断整个流程
type SafeToolMiddleware struct {
	*adk.BaseChatModelAgentMiddleware
}

// WrapInvokableToolCall 包装同步工具调用,捕获错误并返回格式化的错误消息
func (m *SafeToolMiddleware) WrapInvokableToolCall(
	_ context.Context,
	endpoint adk.InvokableToolCallEndpoint,
	_ *adk.ToolContext,
) (adk.InvokableToolCallEndpoint, error) {
	// 中间件函数逻辑
	return func(ctx context.Context, args string, opts ...tool.Option) (string, error) {
		// 调用原始工具执行函数,并捕获任何错误
		result, err := endpoint(ctx, args, opts...)
		if err != nil {
			// 如果是中断重新运行错误,直接返回以允许 Agent 重试
			if _, ok := compose.IsInterruptRerunError(err);ok {
				return "", err
			}
			// 否则,返回一个格式化的错误消息
			return fmt.Sprintf("[tool error] %v", err), nil
		}
		return result, nil
	}, nil
}

// WrapStreamableToolCall 包装流式工具调用,安全地处理流中的错误
func (m *SafeToolMiddleware) WrapStreamableToolCall(
	_ context.Context,
	endpoint adk.StreamableToolCallEndpoint,
	_ *adk.ToolContext,
) (adk.StreamableToolCallEndpoint, error) {
	// 中间件函数逻辑
	return func(ctx context.Context, args string, opts ...tool.Option) (*schema.StreamReader[string], error) {
		// 调用原始流式工具执行函数,并捕获任何错误
		stream, err := endpoint(ctx, args, opts...)
		if err != nil {
			// 如果是中断重新运行错误,直接返回以允许 Agent 重试
			if _, ok := compose.IsInterruptRerunError(err); ok {
				return nil, err
			}
			// 返回包含错误消息的单块读取器
			return singleChunkReader(fmt.Sprintf("[tool error] %v", err)), nil
		}
		// 包装原始读取器以处理流中的错误
		return safeWrapReader(stream), nil

	}, nil
}

// singleChunkReader 创建一个只包含单个消息的流读取器
func singleChunkReader(msg string) *schema.StreamReader[string] {
	r, w := schema.Pipe[string](1)
	_ = w.Send(msg, nil)
	w.Close()
	return r
}

// safeWrapReader 包装流读取器,捕获流中的错误并转换为错误消息
func safeWrapReader(sr *schema.StreamReader[string]) *schema.StreamReader[string] {
	r, w := schema.Pipe[string](64)
	go func() {
		defer w.Close()
		for {
			chunk, err := sr.Recv()
			// 正常结束流
			if errors.Is(err, io.EOF) {
				return
			}
			// 流中发生错误,发送错误消息
			if err != nil {
				_ = w.Send(fmt.Sprintf("\n[tool error] %v", err), nil)
				return
			}
			// 转发正常的数据块
			_ = w.Send(chunk, nil)
		}
	}()
	return r
}
然后在agent.go中装载Middleware、
注意:Handlers 字段(在配置中)和 “Middleware”(在文档中讨论的概念)是同一回事——Handlers 是配置字段名,而 ChatModelAgentMiddleware 是接口名
// 创建DeepAgent类型的Agent实例
	agentConfig := &deep.Config{
		Name:           AmiyaName,
		Description:    AmiyaDescription,
		Instruction:    AmiyaInstruction + "\n\n" + extInstruction, // 将文件操作说明添加到系统提示词中
		ChatModel:      model,
		ToolsConfig:    toolsConfig,
		Backend:        backend, // 注入LocalBackend工具集
		StreamingShell: backend, // 支持流式 Shell 输出
		MaxIteration:   50,      // 最大思考/工具调用循环次数
		// 注册安全工具中间件,用于捕获和处理工具调用错误
		Handlers: []adk.ChatModelAgentMiddleware{
			&component.SafeToolMiddleware{},
		},
		// 配置模型重试策略,处理速率限制错误
		ModelRetryConfig: &adk.ModelRetryConfig{
			MaxRetries: 5,
			IsRetryAble: func (_ context.Context,err error) bool{
				return strings.Contains(err.Error(), "429") ||
					strings.Contains(err.Error(), "Too Many Requests") ||
					strings.Contains(err.Error(), "qpm limit")
			},
		},
	}
可观测性
Eino中的Callback可以在组件开始处理前、组件成功返回后、组件返回错误时、组件接收流式输入时和组件返回流式输出时打印日志
Callback需要实现以下接口:
type Handler interface {
    // 非流式输入(组件开始处理前)
    OnStart(ctx context.Context, info *RunInfo, input CallbackInput) context.Context

    // 非流式输出(组件成功返回后)
    OnEnd(ctx context.Context, info *RunInfo, output CallbackOutput) context.Context

    // 错误(组件返回错误时)
    OnError(ctx context.Context, info *RunInfo, err error) context.Context

    // 流式输入(组件接收流式输入时)
    OnStartWithStreamInput(ctx context.Context, info *RunInfo,
        input *schema.StreamReader[CallbackInput]) context.Context

    // 流式输出(组件返回流式输出时)
    OnEndWithStreamOutput(ctx context.Context, info *RunInfo,
        output *schema.StreamReader[CallbackOutput]) context.Context
}
我们使用 callbacks.NewHandlerBuilder()创建callback handler:
// AmiyaAgent/internal/agent/agent.go
handler := callbacks.NewHandlerBuilder().
	OnStartFn(func(ctx context.Context, info *callbacks.RunInfo, input callbacks.CallbackInput) context.Context {
		log.Printf("[trace] %s/%s start", info.Component, info.Name)
		 return ctx
	}).
		OnEndFn(func(ctx context.Context, info *callbacks.RunInfo, output callbacks.CallbackOutput) context.Context {
			log.Printf("[trace] %s/%s end", info.Component, info.Name)
			return ctx
	}).
		OnErrorFn(func(ctx context.Context, info *callbacks.RunInfo, err error) context.Context {
			log.Printf("[trace] %s/%s error: %v", info.Component, info.Name, err)
			return ctx
	}).Build()

	callbacks.AppendGlobalHandlers(handler)
CozeLoop(扣子罗盘)
CozeLoop 是字节跳动开源的 AI 应用可观测性平台,类似Jaeger,CozeLoop是专门为 AI Agent 和 LLM 应用设计的可视化链路追踪(Tracing)与调试平台
我们在cozeloop官网重获取了APIToken和WorkspaceID后便在agent里集成cozeloop:
// AmiyaAgent/internal/agent/agent.go
// 配制 CozeLoop 追踪
	if cozeloopApiToken != "" && cozeloopWorkspaceID != "" {
		client, err := cozeloop.NewClient(
			cozeloop.WithAPIToken(cozeloopApiToken),
			cozeloop.WithWorkspaceID(cozeloopWorkspaceID),
		)
		if err != nil {
			return nil, fmt.Errorf("初始化CozeLoop客户端失败: %v", err)
		}
		defer func() {
			time.Sleep(5 * time.Second)
			client.Close(ctx)
		}()
		callbacks.AppendGlobalHandlers(clc.NewLoopHandler(client))
		log.Println("CozeLoop追踪已启用")
	} else {
		log.Println("CozeLoop追踪未启用,缺少API Token或Workspace ID")
	}
中断和恢复(Interrupt & resume)
可以达成在调用指定工具前向用户审批的效果
这样便可以实现一个可中断和恢复的 Agent 执行流程:
- Agent 执行过程中遇到需要人工审批的操作时,会触发 Interrupt(中断)
- 用户在命令行确认或拒绝后,通过 Resume(恢复)继续执行
- 所有状态通过 CheckPoint 保存,支持会话恢复
首先我们需要实现中断/恢复中间件:
// AmiyaAgent/internal/component/middleware.go
// approvalMiddleware 处理工具调用中的用户审批流程
type ApprovalMiddleware struct {
	*adk.BaseChatModelAgentMiddleware
}

// WrapInvokableToolCall 包装同步工具调用,实现中断-恢复流程
func (m *ApprovalMiddleware) WrapInvokableToolCall(
	_ context.Context,
	endpoint adk.InvokableToolCallEndpoint,
	tCtx *adk.ToolContext,
) (adk.InvokableToolCallEndpoint, error) {
	// 只对 "execute" 工具进行审批拦截,其他工具直接通过
	// if tCtx.Name != "execute" {
	// 	return endpoint, nil
	// }

	return func(ctx context.Context, args string, opts ...tool.Option) (string, error) {
		// ====================================================================
		// 第一次执行:检查是否已被中断过
		// ====================================================================
		// GetInterruptState 检查当前执行是否是从中断状态恢复的
		// 返回值:
		//   - wasInterrupted: 是否曾被中断过
		//   - _: 中断时的上下文信息
		//   - storedArgs: 中断时保存的工具参数
		wasInterrupted, _, storedArgs := tool.GetInterruptState[string](ctx)

		if !wasInterrupted {
			// 首次执行,还未被中断过
			// 触发 StatefulInterrupt:
			//   1. 保存当前工具参数 (args) 用于后续恢复
			//   2. 返回 ApprovalInfo 给用户展示审批信息
			//   3. 暂停执行,等待用户输入
			return "", tool.StatefulInterrupt(ctx, &commontool.ApprovalInfo{
				ToolName:        tCtx.Name,
				ArgumentsInJSON: args,
			}, args)
		}

		// ====================================================================
		// 恢复执行:用户已做出审批决定
		// ====================================================================
		// GetResumeContext 获取恢复时用户提供的审批结果
		// 返回值:
		//   - isTarget: 这个中断点是否是恢复的目标
		//   - hasData: 是否有恢复数据
		//   - data: 用户的审批结果 (ApprovalResult)
		isTarget, hasData, data := tool.GetResumeContext[*commontool.ApprovalResult](ctx)

		if isTarget && hasData {
			if data.Approved {
				// 用户批准,继续执行工具
				return endpoint(ctx, storedArgs, opts...)
			}
			// 用户拒绝,返回拒绝消息
			if data.DisapproveReason != nil {
				return fmt.Sprintf("工具 '%s' 审批被拒绝: %s", tCtx.Name, *data.DisapproveReason), nil
			}
			return fmt.Sprintf("工具 '%s' 审批被拒绝", tCtx.Name), nil
		}

		// ====================================================================
		// 多个中断点的情况:检查是否还有其他未处理的中断
		// ====================================================================
		// 如果 isTarget 为 false,说明还有其他中断点需要处理
		// 继续中断,等待用户处理其他中断点
		isTarget, _, _ = tool.GetResumeContext[any](ctx)
		if isTarget {
			// 还有其他中断点未处理
			return "", tool.StatefulInterrupt(ctx, &commontool.ApprovalInfo{
				ToolName:        tCtx.Name,
				ArgumentsInJSON: args,
			}, args)
		}

		// 所有中断点都已处理,执行工具
		return endpoint(ctx, storedArgs, opts...)
	}, nil
}

// WrapStreamableToolCall 包装流式工具调用,实现中断-恢复流程
func (m *ApprovalMiddleware) WrapStreamableToolCall(
	_ context.Context,
	endpoint adk.StreamableToolCallEndpoint,
	tCtx *adk.ToolContext,
) (adk.StreamableToolCallEndpoint, error) {
	// 只对 "execute" 工具进行审批拦截,其他工具直接通过
	// if tCtx.Name != "execute" {
	// 	return endpoint, nil
	// }

	return func(ctx context.Context, args string, opts ...tool.Option) (*schema.StreamReader[string], error) {
		// 第一次执行:检查是否已被中断过
		wasInterrupted, _, storedArgs := tool.GetInterruptState[string](ctx)
		if !wasInterrupted {
			// 首次执行,触发 StatefulInterrupt: 保存args,返回审批信息,暂停执行
			return nil, tool.StatefulInterrupt(ctx, &commontool.ApprovalInfo{
				ToolName:        tCtx.Name,
				ArgumentsInJSON: args,
			}, args)
		}

		// 恢复执行:获取用户的审批结果
		isTarget, hasData, data := tool.GetResumeContext[*commontool.ApprovalResult](ctx)
		if isTarget && hasData {
			if data.Approved {
				// 用户批准,继续执行工具
				return endpoint(ctx, storedArgs, opts...)
			}
			// 用户拒绝,返回包含拒绝消息的单块读取器
			if data.DisapproveReason != nil {
				return singleChunkReader(fmt.Sprintf("工具 '%s' 审批被拒绝: %s", tCtx.Name, *data.DisapproveReason)), nil
			}
			return singleChunkReader(fmt.Sprintf("工具 '%s' 审批被拒绝", tCtx.Name)), nil
		}

		// 检查是否还有其他中断点未处理
		isTarget, _, _ = tool.GetResumeContext[any](ctx)
		if isTarget {
			// 还有其他中断点未处理,继续中断当前点
			return nil, tool.StatefulInterrupt(ctx, &commontool.ApprovalInfo{
				ToolName:        tCtx.Name,
				ArgumentsInJSON: args,
			}, args)
		}

		// 所有中断点都已处理,执行工具
		return endpoint(ctx, storedArgs, opts...)
	}, nil
}
然后我们在创建agent时使用该中间件:
// AmiyaAgent/agent/agent.go
// 创建DeepAgent类型的Agent实例
	agentConfig := &deep.Config{
		Name:           AmiyaName,
		Description:    AmiyaDescription,
		Instruction:    AmiyaInstruction + "\n\n" + extInstruction, // 将文件操作说明添加到系统提示词中
		ChatModel:      model,
		ToolsConfig:    toolsConfig,
		Backend:        backend, // 注入LocalBackend工具集
		StreamingShell: backend, // 支持流式 Shell 输出
		MaxIteration:   50,      // 最大思考/工具调用循环次数
		// 注册安全工具中间件,用于捕获和处理工具调用错误
		Handlers: []adk.ChatModelAgentMiddleware{
			&component.ApprovalMiddleware{}, // 处理工具调用中的用户审批流程
			&component.SafeToolMiddleware{}, // 捕获工具调用错误
		},
		// 配置模型重试策略,处理速率限制错误
		ModelRetryConfig: &adk.ModelRetryConfig{
			MaxRetries: 5,
			IsRetryAble: func (_ context.Context,err error) bool{
				return strings.Contains(err.Error(), "429") ||
					strings.Contains(err.Error(), "Too Many Requests") ||
					strings.Contains(err.Error(), "qpm limit")
			},
		},
	}
	agent, err := deep.New(ctx, agentConfig)
	if err != nil {
		return nil, err
}并在创建AgentRunner时使用CheckPoint,CheckPoint可以使agent在中断时保存状态(Tool 参数、执行位置等)并在恢复时加载状态(从中断点继续执行)
// AmiyaAgent/cmd/main.go
// 创建agentRunner实例
	runner := adk.NewRunner(ctx, adk.RunnerConfig{
		Agent:           agent,
		EnableStreaming: true,
		CheckPointStore: store.NewInMemoryStore(),
	})
log.Println("AgentRunner 实例创建成功")随后我们在流程主循环里集成CheckPoint和Interrupt:
// AmiyaAgent/cmd/main.go
checkPointID := sessionID
	reader := bufio.NewReader(os.Stdin)
	for {
		fmt.Print("博士:")
		line, err := reader.ReadString('\n')
		if errors.Is(err, io.EOF) {
			break
		}
		if err != nil {
			log.Println("读取用户输入失败:", err)
			continue
		}
		line = strings.TrimSpace(line)
		if line == "" {
			continue
		}

		// 封装用户消息
		userMsg := schema.UserMessage(line)
		if err := session.Append(userMsg); err != nil { // 将消息保存到会话
			log.Println("保存用户消息失败:", err)
			continue
		}

		// 获取当前会话的消息历史
		messages := session.GetMessages()

		// 调用 AgentRunner 生成回复
		fmt.Print("阿米娅:")
		events := runner.Run(ctx, messages, adk.WithCheckPointID(checkPointID))
		content,interruptInfo, err := getAssistantMsg(events)
		if err != nil {
			log.Println("生成回复失败:", err)
			// 回滚消息历史
			messages = messages[:len(messages)-1]
			continue
		}

		// 如果 Agent 执行过程中触发了中断,处理中断
		if interruptInfo != nil {
			content, err = handleInterrupt(ctx, runner, checkPointID, interruptInfo, reader)
			if err != nil {
				_, _ = fmt.Fprintln(os.Stderr, err)
				os.Exit(1)
			}
		}

		// 将模型回复加入对话历史
		err = session.Append(schema.AssistantMessage(content, nil))
		if err != nil {
			log.Println("保存助手消息失败:", err)
			continue
		}

		fmt.Println()
	}

	fmt.Printf("\n\n会话已保存,会话ID:%s\n", sessionID)
}

func getAssistantMsg(events *adk.AsyncIterator[*adk.AgentEvent]) (string,*adk.InterruptInfo, error) {
	// 创建一个字符串构建器,用于累积所有回复内容
	var builder strings.Builder
	var interruptInfo *adk.InterruptInfo

	// 循环遍历事件迭代器中的所有事件
	for {
		// 从迭代器中获取下一个事件
		event, ok := events.Next()
		if !ok {
			break
		}

		// 检查事件中是否包含错误
		if event.Err != nil {
			return "", nil, event.Err
		}

		// 检测中断事件
		if event.Action != nil && event.Action.Interrupted != nil {
			interruptInfo = event.Action.Interrupted
			// 保存中断信息,继续处理其他事件
			continue
		}

		// 检查事件的输出是否为空或消息输出为空
		if event.Output == nil || event.Output.MessageOutput == nil {
			continue
		}

		// 获取消息输出对象,简化后续代码
		msg := event.Output.MessageOutput

		// 若本次消息为工具调用结果,则提取工具输出内容并打印(不累积到最终回复中)
		if msg.Role == schema.Tool {
			content := getToolMsg(msg)
			fmt.Printf("[调用工具结果] %s\n", truncate(content, 200))
			continue
		}

		// 只处理Assistant消息
		if msg.Role != schema.Assistant {
			continue
		}

		// 检查消息是否为流式传输
		if msg.IsStreaming {
			// 设置消息流为自动关闭模式
			msg.MessageStream.SetAutomaticClose()

			// 初始化工具收集器
			var toolCalls []schema.ToolCall

			// 循环接收流中的每一帧数据
			for {
				// 从流中接收一帧数据
				frame, err := msg.MessageStream.Recv()

				// 表示流已完全接收,正常退出循环
				if errors.Is(err, io.EOF) {
					break
				}

				// 返回错误
				if err != nil {
					return "", nil, err
				}

				// 检查帧数据是否有效
				if frame != nil {
					// AI正在生成的文字内容
					if frame.Content != "" {
						// 将帧内容添加到字符串构建器中
						builder.WriteString(frame.Content)
						// 同时将内容实时打印到标准输出(不换行)
						_, _ = fmt.Fprint(os.Stdout, frame.Content)
					}
					// 收集AI想要调用的工具
					if len(frame.ToolCalls) > 0 {
						toolCalls = append(toolCalls, frame.ToolCalls...)
					}
				}
			}
			// 打印工具调用信息
			for _, toolCall := range toolCalls {
				if toolCall.Function.Name != "" && toolCall.Function.Arguments != "" {
					fmt.Printf("\n[调用工具] %s(%s)\n", toolCall.Function.Name, toolCall.Function.Arguments)
				}
			}
			// 流处理完毕后,打印一个换行符
			_, _ = fmt.Fprintln(os.Stdout)
			continue
		}

		// 处理非流式消息(一次性返回的完整消息)
		if msg.Message != nil {
			// 将消息内容添加到字符串构建器中
			builder.WriteString(msg.Message.Content)
			// 将消息内容打印到标准输出(带换行符)
			_, _ = fmt.Fprintln(os.Stdout, msg.Message.Content)
		} else {
			// 如果消息为空,仅打印一个空行
			_, _ = fmt.Fprintln(os.Stdout)
		}
	}

	// 返回累积的所有助手回复内容
	return builder.String(), interruptInfo, nil
}

// handleInterrupt 处理中断并恢复执行
func handleInterrupt(ctx context.Context, runner *adk.Runner, checkPointID string, interruptInfo *adk.InterruptInfo, reader *bufio.Reader) (string, error) {
	// 遍历所有中断上下文,找到根本原因的中断
	for _, ic := range interruptInfo.InterruptContexts {
		// IsRootCause 标记这是否是触发中断的根本原因
		// 在多层嵌套的中断中,只有根本原因的中断需要用户处理
		if !ic.IsRootCause {
			continue
		}

		// 尝试将中断信息转换为 ApprovalInfo
		info, ok := ic.Info.(*commontool.ApprovalInfo)
		if !ok {
			continue
		}

		// 向用户展示需要审批的信息
		fmt.Printf("\n⚠️  需要用户审批 ⚠️\n")
		fmt.Printf("工具: %s\n", info.ToolName)
		fmt.Printf("参数: %s\n", info.ArgumentsInJSON)
		fmt.Print("\n是否批准? (y/n): ")

		// 读取用户输入
		response, err := reader.ReadString('\n')
		if err != nil {
			return "", fmt.Errorf("读取用户输入失败: %w", err)
		}
		response = strings.TrimSpace(strings.ToLower(response))

		// 根据用户输入构建恢复数据
		var resumeData *commontool.ApprovalResult
		if response == "y" || response == "yes" {
			resumeData = &commontool.ApprovalResult{Approved: true}
			fmt.Println("✓ 已批准,正在执行...")
		} else {
			resumeData = &commontool.ApprovalResult{Approved: false}
			fmt.Println("✗ 已拒绝")
		}

		// 使用用户的审批决定继续 Agent 执行
		events, err := runner.ResumeWithParams(ctx, checkPointID, &adk.ResumeParams{
			Targets: map[string]any{
				ic.ID: resumeData,  // ic.ID 是中断点的唯一标识
			},
		})
		if err != nil {
			return "", fmt.Errorf("恢复执行失败: %w", err)
		}

		// 收集恢复后的输出
		content, newInterruptInfo, err := getAssistantMsg(events)
		if err != nil {
			return "", err
		}

		// 递归处理新的中断
		if newInterruptInfo != nil {
			return handleInterrupt(ctx, runner, checkPointID, newInterruptInfo, reader)
		}

		return content, nil
	}

	return "", fmt.Errorf("未找到需要处理的根本原因中断")
}
Graph Tool & RAG
compose.Workflow 是 Eino 中构建工作流的核心组件
我们以该工具为例为Agent创建一个rag系统:
// AmiyaAgent/graphTool.rag.go
package graphTool

import (
	"context"
	"encoding/json"
	"fmt"
	"os"
	"sort"
	"strings"

	"github.com/cloudwego/eino/components/model"
	"github.com/cloudwego/eino/components/tool"
	"github.com/cloudwego/eino/compose"
	"github.com/cloudwego/eino/schema"

	"github.com/cloudwego/eino-examples/adk/common/tool/graphtool"
	"github.com/cloudwego/eino-examples/compose/batch/batch"
)

// Input 是工具调用的参数结构体
// 其 JSON 标签被 utils.InferTool 用于自动生成工具的参数 Schema
type Input struct {
	FilePath string `json:"file_path" jsonschema:"description=已上传文档文件的绝对路径"`
	Question string `json:"question"  jsonschema:"description=需要根据文档回答的问题"`
}

// Output 是工具返回的结构化结果。
type Output struct {
	Answer  string   `json:"answer"`
	Sources []string `json:"sources"` // 用于生成答案的关键摘录来源
}

// scoreTask 是喂给内部 BatchNode 工作流的单个分块输入
type scoreTask struct {
	Text     string
	Question string
}

// scoredChunk 是内部 BatchNode 工作流生成的单个分块结果
type scoredChunk struct {
	Text    string
	Score   int    // 0–10 分,表示与问题的相关性
	Excerpt string // 该分块中最相关的句子或短语
}

// scoreIn 是外部 "score" Lambda 节点的输入。
// 它通过字段映射从两个来源汇集而成:
//   - Chunks: "chunk" 节点的完整输出 ([]*schema.Document)
//   - Question: START 节点的 Question 字段 (来自 Input)
type scoreIn struct {
	Chunks   []*schema.Document
	Question string
}

// synthIn 是 "synthesize" Lambda 节点的输入
// 它通过字段映射从两个来源汇集而成:
//   - TopK: "filter" 节点的完整输出 ([]scoredChunk)
//   - Question: START 节点的 Question 字段 (来自 Input)
type synthIn struct {
	TopK     []scoredChunk
	Question string
}

// BuildTool 构建由 RAG 工作流支持的 answer_from_document 工具
// 它使用了 graphtool.NewInvokableGraphTool,该工具在每次调用时编译工作流 并支持通过内置的检查点存储(checkpoint store)进行中断/恢复
func BuildTool(ctx context.Context, cm model.BaseChatModel) (tool.BaseTool, error) {
	wf := buildWorkflow(cm)
	return graphtool.NewInvokableGraphTool[Input, Output](
		wf,
		"answer_from_document",
		"在大型上传文档中搜索与问题相关的内容,并从最相关的段落中合成带有引用的答案。"+
			"当文档太大无法放入上下文窗口时,请使用此工具代替 read_file。",
	)
}

// buildWorkflow 构建 RAG compose.Workflow(未编译状态)
// graphtool.NewInvokableGraphTool 会在每次调用时对其进行编译
func buildWorkflow(cm model.BaseChatModel) *compose.Workflow[Input, Output] {
	scoreWF := newScoreWorkflow(cm)
	scorer := batch.NewBatchNode(&batch.NodeConfig[scoreTask, scoredChunk]{
		Name:           "ChunkScorer",
		InnerTask:      scoreWF,
		MaxConcurrency: 5,
	})

	wf := compose.NewWorkflow[Input, Output]()

	// load: 从磁盘读取文件,输出单个 Document
	wf.AddLambdaNode("load", compose.InvokableLambda(
		func(ctx context.Context, in Input) ([]*schema.Document, error) {
			data, err := os.ReadFile(in.FilePath)
			if err != nil {
				return nil, fmt.Errorf("read %q: %w", in.FilePath, err)
			}
			return []*schema.Document{{Content: string(data)}}, nil
		},
	)).AddInput(compose.START)

	// chunk: 将每个 Document 拆分成约 800 字符的片段
	wf.AddLambdaNode("chunk", compose.InvokableLambda(
		func(ctx context.Context, docs []*schema.Document) ([]*schema.Document, error) {
			var out []*schema.Document
			for _, d := range docs {
				out = append(out, splitIntoChunks(d.Content, 800)...)
			}
			return out, nil
		},
	)).AddInput("load")

	// score: 通过 BatchNode 并行针对问题对每个分块进行评分
	// Chunks 来自 "chunk" 节点;Question 直接来自 START 节点
	// 两者都使用 WithNoDirectDependency,因为执行顺序已经由
	// START→load→chunk→score 的直接边缘建立
	wf.AddLambdaNode("score", compose.InvokableLambda(
		func(ctx context.Context, in map[string]any) ([]scoredChunk, error) {
        // 从 map 中手动提取字段,并进行类型断言
        // 注意:这里的 key 必须和下面 AddInputWithOptions 里的字段名完全一致
        chunks, ok1 := in["Chunks"].([]*schema.Document)
        question, ok2 := in["Question"].(string)

        if !ok1 || !ok2 {
            return nil, fmt.Errorf("score节点输入类型错误: Chunks 类型断言成功=%v, Question 类型断言成功=%v", ok1, ok2)
        }
        tasks := make([]scoreTask, len(chunks))
        for i, c := range chunks {
            tasks[i] = scoreTask{Text: c.Content, Question: question}
        }
        return scorer.Invoke(ctx, tasks)
    },
	)).
		AddInputWithOptions("chunk",
			[]*compose.FieldMapping{compose.ToField("Chunks")},
			compose.WithNoDirectDependency()).
		AddInputWithOptions(compose.START,
			[]*compose.FieldMapping{compose.MapFields("Question", "Question")},
			compose.WithNoDirectDependency())

	// filter: 按分数降序排列,保留最多 3 个分数 ≥ 3 的分块
	wf.AddLambdaNode("filter", compose.InvokableLambda(
		func(ctx context.Context, scored []scoredChunk) ([]scoredChunk, error) {
			sort.Slice(scored, func(i, j int) bool {
				return scored[i].Score > scored[j].Score
			})
			const maxK = 3
			var top []scoredChunk
			for _, c := range scored {
				if c.Score < 3 {
					break
				}
				top = append(top, c)
				if len(top) == maxK {
					break
				}
			}
			return top, nil
		},
	)).AddInput("score")

	// answer: 从前 K 个分块中合成回答,如果为空则返回未找到消息
	// TopK 来自 "filter" 节点;Question 直接来自 START 节点
	// 两者都使用 WithNoDirectDependency:"filter" 节点通过其直接边缘控制执行顺序
	wf.AddLambdaNode("answer", compose.InvokableLambda(
		func(ctx context.Context, in map[string]any) (Output, error) {
        topK, ok1 := in["TopK"].([]scoredChunk)
        question, ok2 := in["Question"].(string)
        if !ok1 || !ok2 {
            return Output{}, fmt.Errorf("answer node input error: topK or question missing")
        }
        if len(topK) == 0 {
            return Output{
                Answer: fmt.Sprintf("在文档中未找到与 %q 相关的内容", question),
            }, nil
        }

        // 构造临时结构体传给 synthesize 函数,或者直接修改 synthesize 接收 map
        return synthesize(ctx, cm, synthIn{TopK: topK, Question: question})
    },
	)).
		AddInputWithOptions("filter",
			[]*compose.FieldMapping{compose.ToField("TopK")},
			compose.WithNoDirectDependency()).
		AddInputWithOptions(compose.START,
			[]*compose.FieldMapping{compose.MapFields("Question", "Question")},
			compose.WithNoDirectDependency())

	// END 节点接收来自 answer 的输出
	wf.End().
		AddInput("answer")

	return wf
}

// newScoreWorkflow 构建用于每个 BatchNode 任务的单节点内部工作流
func newScoreWorkflow(cm model.BaseChatModel) *compose.Workflow[scoreTask, scoredChunk] {
	wf := compose.NewWorkflow[scoreTask, scoredChunk]()
	wf.AddLambdaNode("score_chunk", compose.InvokableLambda(
		func(ctx context.Context, t scoreTask) (scoredChunk, error) {
			return scoreOneChunk(ctx, cm, t)
		},
	)).AddInput(compose.START)
	wf.End().AddInput("score_chunk")
	return wf
}

// scoreOneChunk 要求模型对单个分块的相关性进行评分(0–10)并提取最相关的摘录
// 解析错误会被视为 0 分,因此错误的 JSON 响应永远不会导致整个流水线中止
func scoreOneChunk(ctx context.Context, cm model.BaseChatModel, t scoreTask) (scoredChunk, error) {
	prompt := fmt.Sprintf(`请评分以下文本分块与问题的相关性。

问题: %s

文本分块:
%s

仅回复 JSON — 不要解释,不要 Markdown 代码块:
{"score": <0-10>, "excerpt": "<最相关的句子或短语,如果分数位 0 则为空字符串>"}

评分指南: 0=完全无关, 3=略微相关, 7=清晰相关, 10=直接回答了问题。`,
		t.Question, t.Text)

	resp, err := cm.Generate(ctx, []*schema.Message{schema.UserMessage(prompt)})
	if err != nil {
		// 将模型错误视为不相关,而不是中止整个批处理
		return scoredChunk{Text: t.Text, Score: 0}, nil
	}

	content := strings.TrimSpace(resp.Content)
	// 去除可选的 markdown 代码块包装
	content = strings.TrimPrefix(content, "```json")
	content = strings.TrimPrefix(content, "```")
	content = strings.TrimSuffix(content, "```")
	content = strings.TrimSpace(content)

	var sr struct {
		Score   int    `json:"score"`
		Excerpt string `json:"excerpt"`
	}
	if err := json.Unmarshal([]byte(content), &sr); err != nil {
		return scoredChunk{Text: t.Text, Score: 0}, nil
	}
	return scoredChunk{Text: t.Text, Score: sr.Score, Excerpt: sr.Excerpt}, nil
}

// synthesize 根据前 K 个分块构建提示词并生成带有引用的回答。
func synthesize(ctx context.Context, cm model.BaseChatModel, in synthIn) (Output, error) {
	var sb strings.Builder
	sb.WriteString("仅使用提供的文档摘录回答以下问题。\n\n")
	sb.WriteString("问题: ")
	sb.WriteString(in.Question)
	sb.WriteString("\n\n文档摘录:\n")

	sources := make([]string, len(in.TopK))
	for i, c := range in.TopK {
		excerpt := c.Excerpt
		if excerpt == "" {
			excerpt = c.Text
		}
		sources[i] = excerpt
		fmt.Fprintf(&sb, "[%d] %s\n\n", i+1, excerpt)
	}
	sb.WriteString("提供简洁清晰的回答。在引用来源时,请注明摘录编号,如 [1]。")

	resp, err := cm.Generate(ctx, []*schema.Message{schema.UserMessage(sb.String())})
	if err != nil {
		return Output{}, fmt.Errorf("synthesize: %w", err)
	}
	return Output{Answer: resp.Content, Sources: sources}, nil
}

// splitIntoChunks 将文本切分为最大 chunkSize 字符的分块,
// 尽可能在段落边界 (\n\n) 处断开,其次是换行符。
func splitIntoChunks(text string, chunkSize int) []*schema.Document {
	var chunks []*schema.Document
	var buf strings.Builder

	flush := func() {
		s := strings.TrimSpace(buf.String())
		if s != "" {
			chunks = append(chunks, &schema.Document{Content: s})
		}
		buf.Reset()
	}

	for _, para := range strings.Split(text, "\n\n") {
		para = strings.TrimSpace(para)
		if para == "" {
			continue
		}
		if buf.Len()+len(para)+2 > chunkSize && buf.Len() > 0 {
			flush()
		}
		// 如果段落本身超过了 chunkSize:按行拆分
		if len(para) > chunkSize {
			for _, line := range strings.Split(para, "\n") {
				line = strings.TrimSpace(line)
				if line == "" {
					continue
				}
				if buf.Len()+len(line)+1 > chunkSize && buf.Len() > 0 {
					flush()
				}
				if buf.Len() > 0 {
					buf.WriteByte('\n')
				}
				buf.WriteString(line)
			}
		} else {
			if buf.Len() > 0 {
				buf.WriteString("\n\n")
			}
			buf.WriteString(para)
		}
	}
	flush()
	return chunks
}

// 该包提供了一个由 compose.Workflow 支持的 answer_from_document(根据文档回答问题)工具。
//
// 该工作流使用字段映射(field mapping)在非相邻节点(score, answer)之间共享用户的提问,
// 而无需将提问参数穿透传递给每一个中间节点的输出类型:
//
//	开始节点 START{文件路径 FilePath, 提问 Question}
//	   │ (通过 WithNoDirectDependency 传递数据)─────────────────────────────────────┐
//	  ▼                                                                            │ 提问 Question
//	[load 节点]  os.ReadFile → []*schema.Document (读取文档)                       │
//	  ▼                                                                            │
//	[chunk 节点] 段落拆分器 → []*schema.Document (分块)                            │
//	  ▼  分块 Chunks ──────────────────────────────────────────────────────────► [score 节点]
//	                                                                                │ []scoredChunk (已评分分块)
//	                                                                               ▼
//	                                                                            [filter 节点] 获取 Top-K
//	                                                                                │ TopK (可能为空)
//	                                                                               ▼
//	                                                                            [answer 节点] ◄─ 提问 (来自 START)
//	                                                                     (在线合成答案或返回未找到)
//	                                                                                │
//	                                                                              结束 END
//
// [score] 节点包装了一个 BatchNode,其内部工作流通过并行调用 ChatModel 对每个分块进行评分(最大并发数为 5)。
随后调用BuildTool会返回一个被包装为Tool.BaseTool的工具,可以供我们正常注册
WebSearch
同样的我们可以使用Graph Tool实现联网搜索(Websearch)的功能
值得一提,DuckDuck是一个方便的社区开源搜索API:DuckDuckGo API使用指南
Skill
为agent添加skill.NewMiddleware就可以实现Skill的读取,同时要为其配置Backend和baseURL
同时,我们可以设置为如果没有Skill文件就不加载相关中间件,避免报错
// AmiyaAgent/internal/agent/agent.go
// 加载中间件,如果没有Skill文件就不加载相关中间件
	var handlers []adk.ChatModelAgentMiddleware
	skillsDir, found := resolveSkillsDir(skillDir)
	if found {
		skillBackend, sbErr := skill.NewBackendFromFilesystem(ctx, &skill.BackendFromFilesystemConfig{
			Backend: backend,
			BaseDir: skillsDir,
		})
		if sbErr != nil {
			_, _ = fmt.Fprintln(os.Stderr, sbErr)
			os.Exit(1)
		}
		skillMiddleware, smErr := skill.NewMiddleware(ctx, &skill.Config{
			Backend: skillBackend,
		})
		if smErr != nil {
			_, _ = fmt.Fprintln(os.Stderr, smErr)
			os.Exit(1)
		}
		handlers = append(handlers, skillMiddleware)
	}
	// 注册审批中间件和安全工具调用中间件
	handlers = append(handlers, &component.ApprovalMiddleware{}, &component.SafeToolMiddleware{})
// AmiyaAgent/internal/agent/agent.go
// 查找本地Skills文件夹
func resolveSkillsDir(skillsDir string) (string, bool) {
if skillsDir == "" {
return "", false
}
if absSkillsDir, absErr := filepath.Abs(skillsDir); absErr == nil {
skillsDir = absSkillsDir
}
fi, err := os.Stat(skillsDir)
if err != nil || !fi.IsDir() {
return "", false
}
return skillsDir, true
}A2UI(Agent to UI)
A2UI 并不属于 Eino 框架本身的范畴,它是一个业务层的 UI 协议/渲染方案。本章把 A2UI 集成进前面章节逐步构建出来的 Agent,是为了提供一个端到端、可落地的完整示例:从模型调用、工具调用、工作流编排,到最终把结果以更友好的 UI 方式呈现出来
QQBot
这个算是顺带一提的,我们可以用自己搭的Agent套个OneBot协议框架(如NapCat、LLOneBot)手搓一个高定制化的Bot,也可以用现成的Bot框架(如AstrBot)直接部署Bot,自由度由框架生态决定(插件等)
具体搭建方法网上有很多,也可以去看AstrBot官方文档:AstrBotDevs | AstrBot,这里不在过多赘述
搭建好了后顺便买个小服务器部署一下再测试几天,顺带算是把DevOps这块也简单了解一下,搞出来还是挺好玩的
后记
清明节这几天比较摆,基本没什么产出,一直在搞AstrBot、服务器、中转站、体验Vibe Coding啥的,最近才沉下来搞点产出,不过充其量也就是个用Eino搭的Agent而已,大神们玩烂的东西罢了,甚至汪神早就自己搓了一个LLM应用框架,瑰夏了。
之后想写个分布式项目先,同时复习下算法啥的,感觉图论啥的都忘了,也没怎么用Go写过算法
写完项目5月中左右?再看底层?哎呀反正很恼火捏
评论
留言与讨论 ↗欢迎留下想法或问题。这里承接旧站已有评论。
正在加载评论…