网盘业务
不久前写了一个网盘后端项目,花了两个月时间(我是f5😭😭😭),故写篇博客总结一下用到的新鲜(对我而言)的技术
我得项目分为四个模块:
- 用户管理模块
- 文件管理模块
- 分享模块
- 后台管理模块
服务器保存文件
网盘就离不开服务器保存文件这一块,个人写了两种保存方法:本地磁盘直接保存和MinIO存储(T神的点拨,T-God Orz),实际上应该还有OSS云存储这一块,但是因为是托管式云存储所以要收费
有一些简单但是很方便的技术比如:
- 秒传文件:直接检测文件哈希值查找是否含有相同文件,如果有的话就直接创建文件记录(引用一下找到的文件)就行
- 限定用户资源:在表中新增些值,
Storage或者IsVIP啥的,再在服务层进行相应检测即可 - 文件收藏:
file表新增IsStarred再新增相应路由和服务即可 - 回收站:同上,
IsDeleted即可 - 文件搜索:
Gorm&SQL里的LIKE关键字
本地磁盘直接保存
这一块比较简单,用的直接就是Os包,io包,bufio之类的,在捕获到上传文件后,简单鉴权验证之类的后创建用户文件夹,生成fileHash和唯一标识符,再用标识符作文件名确保保存文件这块不会有问题,
之后就是创建文件夹、Copy文件内容就行,总的来说还是比较简单
具体的部分代码如下:
func (s *FileService) Upload(ctx context.Context, userID int, file multipart.File, fileHeader *multipart.FileHeader) (*model.File, error) {
	isVIP, err := s.UserRepo.GetVIP(userID)
	if err != nil {
		return nil, fmt.Errorf("获取用户信息失败")
	}

	// 验证单个文件大小
	if fileHeader.Size > s.MaxFileSize {
		return nil, fmt.Errorf("单个文件大小不能超过 %.2fGB", float64(s.MaxFileSize)/(1024*1024*1024))
	}

	// 验证用户是否拥有足够存储空间
	userStorage, err := s.UserRepo.GetStorage(userID)
	if err != nil {
		return nil, fmt.Errorf("获取用户信息失败")
	}
	if !isVIP && fileHeader.Size+userStorage > s.NormalUserMaxStorage {
		return nil, fmt.Errorf("非VIP用户总存储空间已超额!")
	}

	// 计算Hash
	hash, err := s.FileHash(file)
	if err != nil {
		return nil, fmt.Errorf("计算文件哈希失败: %v", err)
	}

	// 检测秒传
	existingFile, err := s.FileRepo.FindByHash(ctx, hash)
	if err == nil && existingFile != nil {
		// 检测用户是否有此文件
		userFiles, _, _ := s.FileRepo.FindByUserID(ctx, existingFile.UserID)
		for _, userFile := range userFiles {
			if userFile.Filename == fileHeader.Filename {
				return nil, fmt.Errorf("您已拥有该文件")
			}
		}
		// 创建文件记录(秒传)
		ext := filepath.Ext(fileHeader.Filename)
		ext = ext[1:]
		newFile := &model.File{
			UserID:   uint(userID),
			Name:     fileHeader.Filename,
			Filename: existingFile.Filename,
			Path:     existingFile.Path,
			Size:     fileHeader.Size,
			Hash:     hash,
			MimeType: fileHeader.Header.Get("Content-Type"),
			Ext:      ext,
		}

		//数据层
		if err := s.FileRepo.Create(ctx, newFile); err != nil {
			return nil, fmt.Errorf("秒传失败: %v", err)
		}

		//更新用户存储空间
		s.UpdateUserStorage(ctx, uint(userID), fileHeader.Size)

		return newFile, nil
	}

	// 生成filename
	fileName := s.CreateName(fileHeader.Filename, uint(userID))
	filePath := filepath.Join(s.uploadDir, fmt.Sprintf("user_%d", uint(userID)), fileName)

	// 保存文件
	if err := s.Save(file, filePath); err != nil {
		return nil, fmt.Errorf("保存文件失败: %v", err)
	}

	// 创建文件记录
	ext := filepath.Ext(fileHeader.Filename)
	ext = ext[1:]
	newFile := &model.File{
		UserID:   uint(userID),
		Name:     fileHeader.Filename,
		Filename: fileName,
		Path:     filePath,
		Size:     fileHeader.Size,
		Hash:     hash,
		MimeType: fileHeader.Header.Get("Content-Type"),
		Ext:      ext,
	}
	if err := s.FileRepo.Create(ctx, newFile); err != nil {
		// 回滚
		os.Remove(filePath)
		return nil, fmt.Errorf("创建文件记录失败: %v", err)
	}

	//更新用户存储空间
	s.UpdateUserStorage(ctx, uint(userID), fileHeader.Size)

	return newFile, nil
}

func (s *FileService) Save(file multipart.File, filePath string) error {
	//创建目录
	dir := filepath.Dir(filePath)
	//0755 : 0-无特殊权限  7-rwx  5-rx  5-rx
	if err := os.MkdirAll(dir, 0755); err != nil {
		return err
	}

	//创建文件
	dst, err := os.Create(filePath)
	if err != nil {
		return err
	}
	defer dst.Close()

	//复制文件内容
	_, err = io.Copy(dst, file)
	return err
}要注意的问题就是filepath.join后文件路径可能会出问题,比如多一个反斜杠之类的:user_1//Hsu7Husd98s//file_1.jpg
集成minIO
这一块是在我写完本地磁盘直接保存后直接集成到,只需要修改保存部分的代码即可,具体技术见连接文章
详见:MinIO
但是依旧还是踩了坑,比如桶名bucket_name和键名object_name命名规范之类的,当时还找了好久的错误www
邮箱验证码 - email包
敏感内容检测 - flashtext
这一块有点难绷,因为想做敏感内容检测就学了一下flashtext,也很简单,但是这个库在我的项目里基本只能识别文件名或文本文件之类的,感觉比较鸡肋就没加上去,
进阶的对文件内容,比如检测视频或图像是否含有敏感内容之类的到时有其他库,不过是因为要花钱还是啥的就没弄。
但是现在回想起来发现其实说不定也能调用AI来对文件进行检测,不过感觉有点奢侈了()
下载限流 - ticker
限流这一块主要就是通过设定limitedSpeed和Ticker,让数据在每Ticker流过限制的量,具体实现如下代码:
//限速
	bufferSize := int64(64 * 1024) // 64KB缓冲区
	if limitedSpeed < bufferSize {
		bufferSize = limitedSpeed
	}

	buf := make([]byte, bufferSize)
	ticker := time.NewTicker(time.Second)
	defer ticker.Stop()

	for {
		select {
		case <-ticker.C:
			// 每秒最多读取limitedSpeed字节
			bytesRead := int64(0)
			for bytesRead < limitedSpeed {
				remaining := limitedSpeed - bytesRead
				readSize := remaining
				if readSize > bufferSize {
					readSize = bufferSize
				}

				// 读取文件
				n, err := stream.Read(buf[:readSize])
				if n > 0 {
					// 写入HTTP响应
					_, writeErr := c.Writer.Write(buf[:n])
					if writeErr != nil {
						return
					}
					c.Writer.Flush()      // 立即发送给客户端
					bytesRead += int64(n) // 累计已读取字节
				}

				if err != nil {
					if err == io.EOF {
						zap.L().Info("下载请求结束",
							zap.String("url", c.Request.RequestURI),
							zap.String("method", c.Request.Method),
							zap.String("client_ip", c.ClientIP()))
						return // 文件读取完成
					}
					return
				}
			}
		case <-ctx.Done():
			zap.L().Info("下载请求超时",
				zap.String("url", c.Request.RequestURI),
				zap.String("method", c.Request.Method),
				zap.String("client_ip", c.ClientIP()))
			return // 上下文取消
		}
	}
分片上传
在做分片上传的前期我是一头雾水,主要还是因为分片上传实际上是前后端协作的一个功能,前端将文件切成一定数量的分片,再将分片依次传给后端,同时每次传输给后端几个参数:
chunk_index,chunk_total,fileHash之类的,用来给后端标记当前上传的是哪个文件的第几号分片
而后端在接受这些分片时,对于第一个分片要初始化分片上传服务,创建临时文件夹保存分片文件,之后依次接受并保存相应分片,当接受最后一个分片时,将临时文件夹内的所有分片文件
进行合并,再将合并后的文件进行常规的保存和数据库记录操作
详细代码如下:
func (h *FileHandler) ChunkUpload(c *gin.Context) {
	zap.L().Info("上传分片请求开始",
		zap.String("url", c.Request.RequestURI),
		zap.String("method", c.Request.Method),
		zap.String("client_ip", c.ClientIP()))
	//捕获数据
	userID := c.GetInt("user_id")
	//获取分片文件
	file, err := c.FormFile("chunk")
	if err != nil {
		zap.S().Errorf("无分片文件: %v", err)
		util.Error(c, 400, "无分片文件")
		return
	}
	//获取分片状态数据
	chunkIndexStr := c.PostForm("chunk_index") // Str
	chunkTotalStr := c.PostForm("chunk_total") // Str
	fileHash := c.PostForm("file_hash")
	fileName := c.PostForm("file_name")
	fileMimeType := c.PostForm("file_mime_type") // mimetype
	if chunkIndexStr == "" || chunkTotalStr == "" || fileHash == "" || fileName == "" {
		zap.S().Errorf("无分片元数据: %v", err)
		util.Error(c, 400, "请上传元数据")
		return
	}
	//string -> int
	chunkIndex, err := strconv.Atoi(chunkIndexStr)
	if err != nil {
		zap.S().Errorf("不正确的chunkIndex格式: %v", err)
		util.Error(c, 400, "chunkIndex应当是数字")
		return
	}
	chunkTotal, err := strconv.Atoi(chunkTotalStr)
	if err != nil {
		zap.S().Errorf("不正确的chunkTotal格式: %v", err)
		util.Error(c, 400, "chunkTotal应当是数字")
		return
	}

	if chunkIndex < 0 || chunkTotal < 1 {
		zap.S().Errorf("不正确的chunkIndex或chunkTotal: %v", err)
		util.Error(c, 400, "chunkIndex或chunkTotal错误")
	}

	fileReader, err := file.Open()
	if err != nil {
		zap.S().Errorf("打开分片文件: %v", err)
		util.Error(c, 500, "打开分片文件失败")
		return
	}
	defer fileReader.Close()

	chunkData := make([]byte, file.Size)
	_, err = fileReader.Read(chunkData)
	if err != nil {
		zap.S().Errorf("读取分片文件失败: %v", err)
		util.Error(c, 500, "读取分片文件失败")
		return
	}

	//服务层
	//如果是第一个分片 -> 初始化分片上传
	if chunkIndex == 0 {
		err := h.fileService.InitChunkUpload(userID, fileName, fileHash, chunkTotal) // 初始化上传,创建临时文件夹
		if err != nil {
			zap.S().Errorf("初始化上传失败: %v", err)
			util.Error(c, 500, "初始化上传失败")
			return
		}
	}

	//保存分片文件
	err = h.fileService.SaveChunk(fileHash, userID, chunkIndex, chunkData)
	if err != nil {
		zap.S().Errorf("保存分片文件失败: %v", err)
		util.Error(c, 500, err.Error())
		return
	}

	//如果是最后一个分片 -> 合并所有分片文件 & 返回上传成功响应
	if chunkIndex == chunkTotal-1 {
		file, err := h.fileService.MergeAllChunks(userID, fileHash, fileName, fileMimeType)
		if err != nil {
			zap.S().Errorf("合并分片失败: %v", err)
			util.Error(c, 500, "合并分片失败")
			return
		}

		zap.L().Info("上传分片请求结束",
			zap.String("url", c.Request.RequestURI),
			zap.String("method", c.Request.Method),
			zap.String("client_ip", c.ClientIP()))

		util.Success(c, gin.H{
			"id":         file.ID,
			"name":       file.Name,
			"size":       file.Size,
			"mime_type":  file.MimeType,
			"created_at": file.CreatedAt,
		}, "文件上传成功")
		return
	}

	zap.L().Info("上传分片请求结束",
		zap.String("url", c.Request.RequestURI),
		zap.String("method", c.Request.Method),
		zap.String("client_ip", c.ClientIP()))

	//返回响应
	util.Success(c, gin.H{
		"chunk_index": chunkIndex,
		"chunk_total": chunkTotal,
		"status":      "uncompleted",
	}, "分片上传成功")
}

func (s *FileService) InitChunkUpload(userID int, fileName string, fileHash string, chunkTotal int) error {
	//检查文件是否已存在
	_, err := s.FileRepo.FindByHash(context.Background(), fileHash)
	if err == nil {
		return fmt.Errorf("文件已存在")
	}

	//初始化redis -> 开始记录当前分片上传状态
	err = s.FileRepo.InitChunkUploadSession(fileHash, chunkTotal)
	if err != nil {
		return fmt.Errorf("初始化缓存失败: %v", err)
	}

	//创建临时分片文件夹
	tmpPath := filepath.Join(".", s.uploadDir, fmt.Sprintf("user_%d", uint(userID)), "tmp_uploads/", fileHash) // ./user_:id/tmp_uploads/fileHash/
	err = os.MkdirAll(tmpPath, 0755)
	if err != nil {
		//回滚
		s.FileRepo.CleanChunkUploadSession(fileHash)
		return fmt.Errorf("创建临时目录失败: %v", err)
	}

	return nil
}

func (s *FileService) SaveChunk(fileHash string, userID int, chunkIndex int, chunkData []byte) error {
	//验证:判定redis数据是否过期 -> 结束会话
	err := s.FileRepo.CheckChunkUploadSession(fileHash)
	if err != nil {
		if err.Error() == "redis: nil" {
			return errors.New("上传会话已过期,请重新上传")
		}
		return fmt.Errorf("访问缓存失败: %v", err)
	}

	//将分片保存在临时文件夹内
	tmpPath := filepath.Join(s.uploadDir, fmt.Sprintf("user_%d", uint(userID)), "tmp_uploads/", fileHash) // ./user_:id/tmp_uploads/fileHash/
	chunkPath := filepath.Join("."+tmpPath, fmt.Sprintf("chunk_%d", chunkIndex))

	zap.S().Info(chunkPath)
	err = os.WriteFile(chunkPath, chunkData, 0644)
	if err != nil {
		return fmt.Errorf("保存分片失败: %v", err)
	}

	//更新redis信息
	err = s.FileRepo.UpdateChunkUploadSession(fileHash, chunkIndex)
	if err != nil {
		os.Remove(chunkPath)
		return fmt.Errorf("更新分片状态失败: %v", err)
	}

	return nil
}

func (s *FileService) MergeAllChunks(userID int, fileHash string, fileName string, mimetype string) (*model.File, error) {
	//在临时文件夹内合并所有分片
	//分片信息是否完整
	finished, err := s.FileRepo.IsChunkUploadFinished(fileHash)
	if err != nil {
		return &model.File{}, fmt.Errorf("检查上传状态失败: %v", err)
	}
	if !finished {
		return &model.File{}, fmt.Errorf("已上传的分片不完整")
	}

	//获取分片列表
	chunks, err := s.FileRepo.GetChunks(fileHash)
	if err != nil {
		return &model.File{}, fmt.Errorf("获取分片列表失败: %v", err)
	}

	//排序
	sort.Ints(chunks)

	//合并分片
	filePath, fileSize, _, err := s.MergeChunks(userID, fileHash, fileName, chunks)
	if err != nil {
		return &model.File{}, fmt.Errorf("合并分片失败: %v", err)
	}

	//删除redis数据
	s.FileRepo.CleanChunkUploadSession(fileHash)

	//将分片整合为file
	ext := filepath.Ext(fileName)
	//zap.S().Info(filePath, ext, mimetype, fileName)
	ext = ext[1:]
	file := model.File{
		UserID:   uint(userID),
		Name:     fileName,
		Filename: s.CreateName(fileName, uint(userID)),
		Path:     filePath,
		Size:     fileSize,
		Hash:     fileHash,
		MimeType: mimetype,
		Ext:      ext,
	}

	//将file信息存储在mysql中
	err = s.FileRepo.Create(context.Background(), &file)
	if err != nil {
		return &model.File{}, fmt.Errorf("上传文件失败: %v", err)
	}

	//更新file
	//finalFile, _ := s.FileRepo.FindByHash(context.Background(), fileHash)

	return &file, nil
}

func (s *FileService) MergeChunks(userID int, fileHash string, filename string, chunks []int) (string, int64, string, error) {
	fileName := s.CreateName(filename, uint(userID))
	filePath := filepath.Join(s.uploadDir, fmt.Sprintf("user_%d", uint(userID)), fileName)
	ext := filepath.Ext(filePath)
	//创建目录
	dir := filepath.Dir(filePath)
	//0755 : 0-无特殊权限  7-rwx  5-rx  5-rx
	if err := os.MkdirAll(dir, 0755); err != nil {
		return "", -1, "", err
	}
	finalFile, err := os.Create(filePath)
	if err != nil {
		return "", -1, "", errors.New("创建最终文件失败: %v" + err.Error())
	}
	defer finalFile.Close()

	//合并分片
	var totalSize int64
	tmpPath := filepath.Join(".", s.uploadDir, fmt.Sprintf("user_%d", uint(userID)), "tmp_uploads/", fileHash) // ./user_:id/tmp_uploads/fileHash/
	for _, chunkIndex := range chunks {
		//寻找当前chunk路径
		chunkPath := filepath.Join(tmpPath, fmt.Sprintf("chunk_%d", chunkIndex))

		//打开当前chunk
		chunkFile, err := os.Open(chunkPath)
		if err != nil {
			return "", -1, "", errors.New("打开分片失败: %v" + err.Error())
		}

		//将chunk内容合并到file
		writer, err := io.Copy(finalFile, chunkFile)
		chunkFile.Close()
		if err != nil {
			return "", -1, "", errors.New("合并分片失败: %v" + err.Error())
		}

		totalSize += writer

		//删除当前临时chunk
		os.Remove(chunkPath)
	}

	//合并后把file存入minIO
	//删除临时文件夹
	//获取字节数据
	finalFileData, err := io.ReadAll(finalFile)
	if err != nil {
		return "", -1, "", errors.New("读取合并文件失败")
	}

	//保存到minIO
	if err := s.minioClient.Save(context.Background(), filePath, finalFileData, ext); err != nil {
		return "", -1, "", err
	}

	//删除本地文件
	//os.Remove(filePath)
	os.Remove(tmpPath)

	return filePath, totalSize, ext, nil
}
断点传续
断点传续的功能需要建立在分片上传之上,因为断点传续本质上是在分片传输时,前端用来获取分片上传服务状态的接口,这个接口可以为前端提供还差哪些分片的信息,让前端可以
弥补性地上传剩余的分片或者接着上传上次没有传递完的切片,故名断点传续
代码如下:
func (h *FileHandler) GetChunkStatus(c *gin.Context) {
	zap.L().Info("获取分片状态请求开始",
		zap.String("url", c.Request.RequestURI),
		zap.String("method", c.Request.Method),
		zap.String("client_ip", c.ClientIP()))
	//捕获数据
	fileHash := c.PostForm("file_hash")
	if fileHash == "" {
		zap.S().Errorf("缺少filehash参数")
		util.Error(c, 500, "缺少fileHash参数")
		return
	}

	//服务层
	uploadedChunks, err := h.fileService.GetUploadedChunks(fileHash)
	if err != nil {
		zap.S().Errorf("获取分片状态失败: %v", err)
		util.Error(c, 500, err.Error())
		return
	}

	zap.L().Info("获取分片状态请求结束",
		zap.String("url", c.Request.RequestURI),
		zap.String("method", c.Request.Method),
		zap.String("client_ip", c.ClientIP()))

	//成功响应
	util.Success(c, gin.H{
		"file_hash":       fileHash,
		"uploaded_chunks": uploadedChunks,
		"uploaded_count":  len(uploadedChunks),
	}, "获取上传状态成功")
}

//因为服务层是对数据层的直接调用,所以此处跳过服务层

func (repo *mysqlFileRepo) GetUploadedChunks(fileHash string) ([]int, error) {
	chunkKey := fmt.Sprintf("chunkupload:chunk:%s", fileHash)
	chunksStr, err := repo.cache.SMembers(chunkKey)
	if err != nil {
		return nil, err
	}
	var chunks []int
	for _, chunkStr := range chunksStr {
		chunk, err := strconv.Atoi(chunkStr)
		if err != nil {
			return nil, err
		}
		chunks = append(chunks, chunk)
	}

	return chunks, nil
}
文件预览
文件预览可以说简单也可以说复杂,本质上是对请求预览的文件进行mime类型判断,再根据不同的mime类型执行不同的预览方法,比如是文本文件就直接返回内容,是不可预览的文件就
返回不可预览的信息或者返回直接文件内容
func (h *FileHandler) Preview(c *gin.Context) {
	zap.L().Info("预览文件请求开始",
		zap.String("url", c.Request.RequestURI),
		zap.String("method", c.Request.Method),
		zap.String("client_ip", c.ClientIP()))
	//捕获数据
	userID := c.GetInt("user_id")
	fileID, err := strconv.ParseInt(c.Param("id"), 10, 64)
	if err != nil {
		zap.S().Errorf("无效的文件ID: %v", err)
		util.Error(c, 400, "无效的文件ID")
		return
	}

	//服务层获取文件信息
	ctx := c.Request.Context()
	file, err := h.fileService.GetFileInfo(ctx, userID, fileID)
	if err != nil {
		zap.S().Errorf("文件不存在或无权限访问: %v", err)
		util.Error(c, 404, "文件不存在或无权访问: "+err.Error())
		return
	}

	exist, err := h.minioClient.Exists(c, file.Path)
	if err != nil {
		zap.S().Errorf("检查文件失败: %v", err)
		util.Error(c, 500, "检查文件失败"+err.Error())
		return
	}
	if !exist {
		zap.S().Errorf("文件已丢失")
		util.Error(c, 404, "文件已丢失")
		return
	}
	//=============================================================================================================
	//是否存在
	//if _, err := os.Stat(file.Path); os.IsNotExist(err) {
	//	util.Error(c, 404, "文件已丢失")
	//	return
	//}
	//=============================================================================================================

	//服务层获取文件类型
	fileType, err := h.fileService.GetMimeType(ctx, file)
	if err != nil {
		zap.S().Errorf("获取文件类型失败: %v", err)
		util.Error(c, 500, "获取文件类型失败: "+err.Error())
		return
	}
	switch fileType {
	case "image":
		h.PreImage(c, file)
	case "video":
		h.PreVideo(c, file)
	case "audio":
		h.PreAudio(c, file)
	case "document":
		h.PreDoc(c, file)
	case "text":
		h.PreText(c, file)
	case "other":
		h.PreText(c, file) // // 其他类型尝试作为文本预览
	default:
		zap.S().Errorf("未解析的文件类型: %s", fileType)
		util.Error(c, 500, "未解析的文件类型")
		return
	}
	zap.L().Info("预览文件请求结束",
		zap.String("url", c.Request.RequestURI),
		zap.String("method", c.Request.Method),
		zap.String("client_ip", c.ClientIP()))
}

func (h *FileHandler) PreImage(c *gin.Context, file *model.File) {
	//设置响应头
	ext := file.Ext
	if ext == "svg" {
		ext = "svg+xml"
	}
	MineType := "image/" + ext
	c.Header("Content-Type", MineType)
	c.Header("Cache-Control", "public, max-age=31536000") // 缓存1年

	//从minIO获取文件流
	stream, err := h.minioClient.GetStream(c, file.Path)
	if err != nil {
		zap.S().Errorf("从minIO获取文件失败: %v", err)
		util.Error(c, 500, "从minIO获取文件失败"+err.Error())
		return
	}
	defer stream.Close()

	io.Copy(c.Writer, stream)
}

func (h *FileHandler) PreVideo(c *gin.Context, file *model.File) {
	//设置响应头
	ext := file.Ext
	if ext == "mov" {
		ext = "quicktime"
	}
	if ext == "avi" {
		ext = "x-msvideo"
	}
	if ext == "mkv" {
		ext = "x-matroska"
	}
	MineType := "video/" + ext
	c.Header("Content-Type", MineType)
	c.Header("Accept-Ranges", "bytes")

	//从minIO获取文件流
	stream, err := h.minioClient.GetStream(c.Request.Context(), file.Path)
	if err != nil {
		zap.S().Errorf("从minIO获取文件失败: %v", err)
		util.Error(c, 500, "从minIO获取文件失败"+err.Error())
		return
	}
	defer stream.Close()

	http.ServeContent(c.Writer, c.Request, file.Name, time.Now(), stream.(io.ReadSeeker))

	//神器
	//http.ServeFile(c.Writer, c.Request, file.Path)
}

func (h *FileHandler) PreAudio(c *gin.Context, file *model.File) {
	//设置响应头
	ext := file.Ext
	if ext == "mp3" {
		ext = "mpeg"
	}
	MineType := "audio/" + ext
	c.Header("Content-Type", MineType)
	c.Header("Accept-Ranges", "bytes")

	//从minIO获取文件流
	stream, err := h.minioClient.GetStream(c.Request.Context(), file.Path)
	if err != nil {
		zap.S().Errorf("从minIO获取文件失败: %v", err)
		util.Error(c, 500, "从minIO获取文件失败"+err.Error())
		return
	}
	defer stream.Close()

	http.ServeContent(c.Writer, c.Request, file.Name, time.Now(), stream.(io.ReadSeeker))

	//神器
	//http.ServeFile(c.Writer, c.Request, file.Path)
}

func (h *FileHandler) PreDoc(c *gin.Context, file *model.File) {
	ext := file.Ext

	switch ext {
	case "pdf":
		// PDF文件可以直接预览
		c.Header("Content-Type", "application/pdf")
		c.Header("Content-Disposition", fmt.Sprintf("inline; filename=\"%s\"", file.Name))
	case "txt", "md", "js", "css", "html", "json", "xml", "yaml", "yml":
		// 文本类文件
		h.PreText(c, file)
	default:
		// 其他文档类型,返回下载
		c.Header("Content-Type", "application/octet-stream")
		c.Header("Content-Disposition", fmt.Sprintf("attachment; filename=\"%s\"", file.Name))
	}

	//从minIO获取文件流
	stream, err := h.minioClient.GetStream(c, file.Path)
	if err != nil {
		zap.S().Errorf("从minIO获取文件失败: %v", err)
		util.Error(c, 500, "从minIO获取文件失败"+err.Error())
		return
	}
	defer stream.Close()

	io.Copy(c.Writer, stream)
}

func (h *FileHandler) PreText(c *gin.Context, file *model.File) {
	c.Header("Content-Type", "text/plain; charset=utf-8")
	c.Header("Content-Disposition", fmt.Sprintf("inline; filename=\"%s\"", file.Name))

	//从minIO获取文件流
	stream, err := h.minioClient.GetStream(c, file.Path)
	if err != nil {
		zap.S().Errorf("从minIO获取文件失败: %v", err)
		util.Error(c, 500, "从minIO获取文件失败"+err.Error())
		return
	}
	defer stream.Close()

	io.Copy(c.Writer, stream)
	//=============================================================================================================
	// 打开文件
	//fileContent, err := os.Open(file.Path)
	//if err != nil {
	//	util.Error(c, 500, "打开文件失败: "+err.Error())
	//	return
	//}
	//defer fileContent.Close()
	//
	//// 发送文件内容
	//io.Copy(c.Writer, fileContent)
	//=============================================================================================================

}
需要注意的是,应该还需要有一个接口为前端返回预览信息:
func (h *FileHandler) GetPreInfo(c *gin.Context) {
	zap.L().Info("获取文件预览信息请求开始",
		zap.String("url", c.Request.RequestURI),
		zap.String("method", c.Request.Method),
		zap.String("client_ip", c.ClientIP()))
	// 捕获数据
	userID := c.GetInt("user_id")
	fileID, err := strconv.ParseInt(c.Param("id"), 10, 64)
	if err != nil {
		zap.S().Errorf("无效的文件ID: %v", err)
		util.Error(c, 400, "无效的文件ID")
		return
	}

	// 调用服务层获取文件信息
	ctx := c.Request.Context()
	file, err := h.fileService.GetFileInfo(ctx, userID, fileID)
	if err != nil {
		zap.S().Errorf("文件不存在或无权限访问: %v", err)
		util.Error(c, 404, "文件不存在或无权访问: "+err.Error())
		return
	}

	//服务层获取文件类型
	fileType, err := h.fileService.GetMimeType(ctx, file)
	if err != nil {
		zap.S().Errorf("获取文件类型失败: %v", err)
		util.Error(c, 500, "获取文件类型失败: "+err.Error())
		return
	}
	if fileType == "document" {
		fileType = "application"
	}
	//修改响应头
	ext := file.Ext
	if ext == "svg" {
		ext = "svg+xml"
	}
	if ext == "mov" {
		ext = "quicktime"
	}
	if ext == "avi" {
		ext = "x-msvideo"
	}
	if ext == "mkv" {
		ext = "x-matroska"
	}
	if ext == "mp3" {
		ext = "mpeg"
	}
	if ext == "docx" {
		ext = "vnd.openxmlformats-officedocument.wordprocessingml.document"
	}
	if ext == "doc" {
		ext = "msword"
	}
	if ext == "xls" {
		ext = "vnd.ms-excel"
	}
	if ext == "xlsx" {
		ext = "vnd.openxmlformats-officedocument.spreadsheetml.sheet"
	}
	if ext == "ppt" {
		ext = "vnd.ms-powerpoint"
	}
	if ext == "pptx" {
		ext = "vnd.openxmlformats-officedocument.presentationml.presentation"
	}
	if ext == "txt" {
		ext = "plain"
	}
	if ext == "js" {
		ext = "javascript"
	}
	if ext == "md" {
		ext = "markdown"
	}
	MimeType := fileType + "/" + ext

	canPreview := true
	if fileType == "other" {
		canPreview = false
	}
	// 返回预览信息
	previewInfo := gin.H{
		"id":           file.ID,
		"name":         file.Name,
		"size":         file.Size,
		"mime_type":    MimeType,
		"category":     fileType,
		"can_preview":  canPreview,
		"extension":    file.Ext,
		"preview_url":  fmt.Sprintf("/api/files/%d/preview", file.ID),
		"content_url":  fmt.Sprintf("/api/files/%d/content", file.ID),
		"download_url": fmt.Sprintf("/api/files/%d/download", file.ID),
		"created_at":   file.CreatedAt,
	}

	zap.L().Info("获取文件预览信息请求结束",
		zap.String("url", c.Request.RequestURI),
		zap.String("method", c.Request.Method),
		zap.String("client_ip", c.ClientIP()))

	util.Success(c, gin.H{
		"file": previewInfo,
	}, "获取预览信息成功")
}
配置管理和日志管理
经典地使用Zap和Viper进行配置管理
详见 Zap&Viper
在使用viper前我还是自己写的配置管理包去访问.env,所以集成Viper很顺利就完成了,不过我为了展示viper的功能再加了一层yaml封装www
安全相关
这一块我只了解了一些最基础的安全问题,比如XSS,CSRF之类的
在我的项目规划里有一定的说明:
- 安全问题
- XSS:上传或预览文本文件时可能触发,但是本项目将文本文件的上传一律设置为了
text/plain,并且使用io.Copy流式传输,且启用了"X-XSS-Protection"XSS过滤,基本没有XSS风险 - SQL注入:gorm内部会自动进行参数化处理,并且项目内基本使用了参数化查询,基本没有风险
- CSRF:正常来说应使用CSRF中间件并进行CSRF Token认证,但是本项目认证方式为通过请求头传递的jwt,不会被CSRF攻击
- 其他: 添加RateLimited中间件和Security中间件
- XSS:上传或预览文本文件时可能触发,但是本项目将文本文件的上传一律设置为了
总结
写这个项目的缘由还是因为很久之前蓝山有个学长的仓库里有一个网盘项目,当时觉得很好奇就了解学习了一下,再加上后端考核有一个选择就是网盘,就写了网盘相关的项目ww
学长的项目↓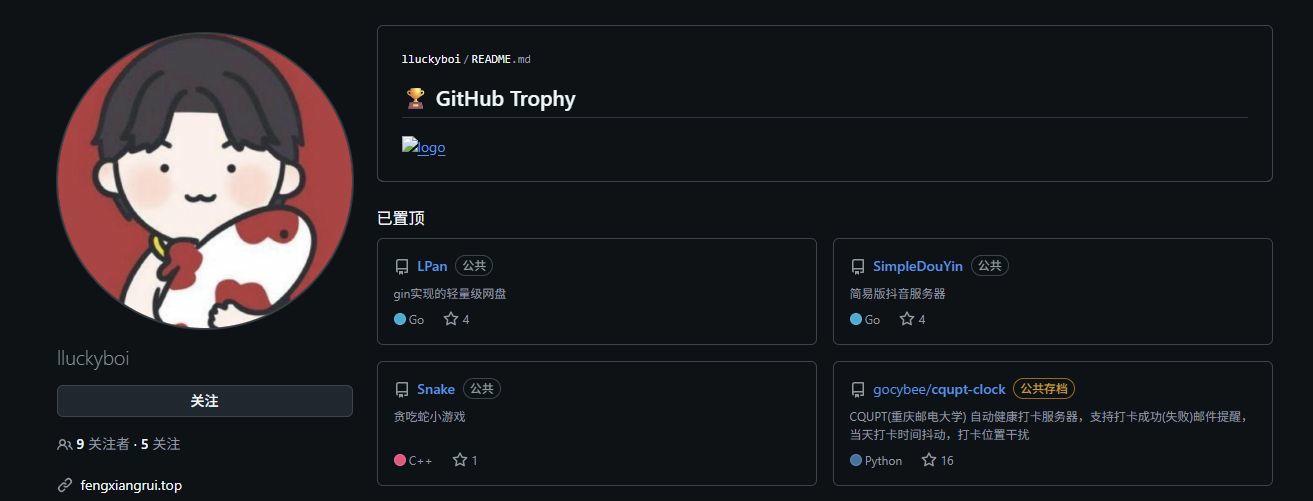
这次写项目还是带给了我一定的经验的新知识,不过我花了两个月可能还是有点磨蹭了,之后再接再厉吧!
评论
留言与讨论 ↗欢迎留下想法或问题。这里承接旧站已有评论。
正在加载评论…