前言
暑假开始了,我学习底层的路也开头了。第一部分就是计算机组成原理,也是算是三部曲里最简单的一部分,主要还是啃COD——《计算机组成与设计:硬件/软件接口》这本书,然后没事看看B站上的《计算机科学速成课》扫盲,且学新东西必然的与AI斗智斗勇
底层还是太有意思了,越学越能感觉到计算机的奇妙,fantastic !
计组
计算机基础
有些内容作为计算机基础,例如ASCII、计算机组成部件、二进制集成等,不再记录
二进制与算术运算
补码
一切计算机底层的基础——二进制,作为最实际,也是历史演化而来的一条路,0或1,true or false,不再赘述
我们知道,一个标准的int类型变量占4个字节(32位),能记录的数值是 2³¹ - 1 到 -2³¹。为什么呢?这是因为补码的特殊计数方式
在说补码之前,我们先来讲原码:我们知道二进制本身就能表示含语义的十进制数字,例如1101就是13。但是由于晶体管只含有0/1两种语义,那么二进制该怎么保存负数呢?原码是这样解决的:例如对于一个八位二进制,我们把它的最高位定为表示正负的位次,也就是说,该位次的二进制在第八位表示正负,剩下的七位表示数值的绝对值。于是0000 0101就表示5,而1000 0101则表示-5。这样一来,这个八位原码能表示的数值就是[1111 1111-127,0111 1111127]
但是原码这样的表示方式也带来了很多问题:0000 0000和1000 0000分别表示了同语义的+0和-0,且在做二进制加减法时我们不能直接将两个二进制值相加,也就不能使用通用的加法器解决加减问题,需要做特殊处理,这也会让计算机底层组件成本更高,性能更低
因此,我们通常使用另一种方式来表示有符号整数——补码。补码的定义是:对于非负数,二进制最高位为0,剩下n-1位为数值;对于负数:表示为2^n-x,即对二进制取反码再+1。这样一来,我们提到的0的语义问题解决了,甚至加减法能用同一套加法器
为什么呢?我们实际来模拟一下:
对于5-3,我们视为5+(-3):
转化为二进制有 0101 + 1101:

 0101
+1101
-----
10010 -> 我们把溢出位舍弃,得 0010 = 2,即5-3=2

同时我们又能发现:-3 = 1101 ,语义上可以理解为最高位-8加上剩余位101 = 5,即-8+5=-3
端倪初现:补码就是让符号位MSB和其他bit一起进Carry运算,本质上是模运算的硬件实现
所以我们能解释int的取值了:最大值为01111111 11111111 11111111 11111111 = 2^31 - 1,最小值为10000000 00000000 00000000 00000000 = -2^31,无符号整型最大值为11111111 11111111 11111111 11111111 = 2^32 - 1
算术运算
搞清了补码,我们也就弄清了算术运算
对于加减法,我们直接将二进制相加即可
对于乘法,通常使用位运算与加法的组合。我们知道位运算中左移一位表示乘二,所以乘法器通常可以通过判断乘数的每一位是否为 1,决定是否把被乘数左移后加到结果中,例如5 * 3 = = 5 * (2 + 1) = = (5 << 1) + 5 ,看作 0000 0101 = 5 左移一位变为 0000 1010 = 10。但是这样做时间过于复杂,我们可以使用加法树并行来优化,这里先按下不表
对于除法,类似于乘法,我们在位运算中右移 + 减法即可
硬件:自底到顶层层抽象
我们先回到计算机世界最底层的二进制表示,再一层层向上封装抽象,理解 ALU、RAM 和 CPU 的基本组成
ALU
ALU,即算术逻辑单元,负责完成 CPU 中最基础的算术运算和逻辑运算。现在看看我们怎么从底层一步步封装到ALU的
物理底层:晶体管
你只需要知道晶体管这个东西能在物理上实现通过电流表示固定的两种状态,进而实现表示0/1就行了
逻辑门
既然说道0/1,就不得不说到布尔代数,这也是所有二进制算法的起点
布尔代数有三个基本操作:NOT,AND,OR,XOR,它们各自代表的含义我相信不难理解
我们可以把这些基础操作结合晶体管实现几个基本单元,叫做布尔逻辑,我们不关心具体实现,把这些结构的基础结构进行封装,就有了逻辑门: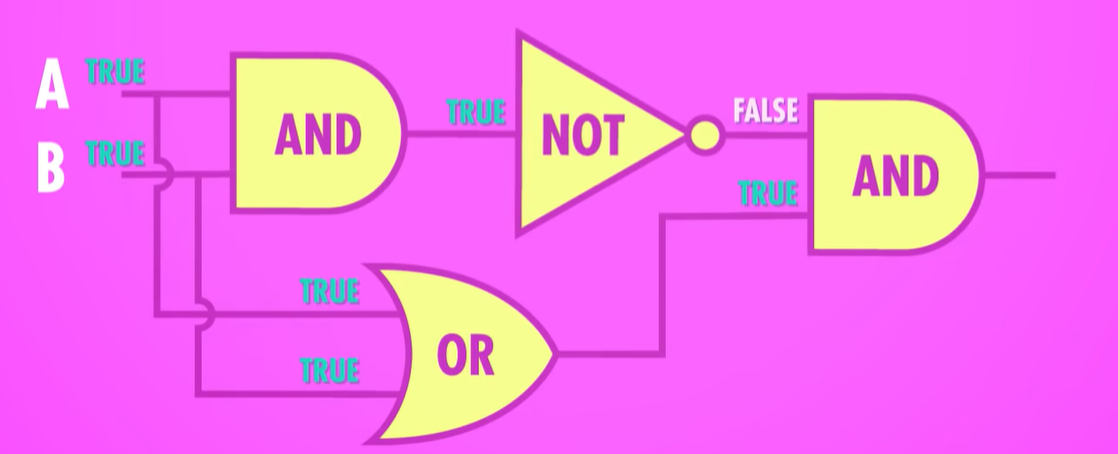
半加器和全加器
接下来,我们可以使用逻辑门来构造一个能够执行二进制加法的装置
最基础的是半加器
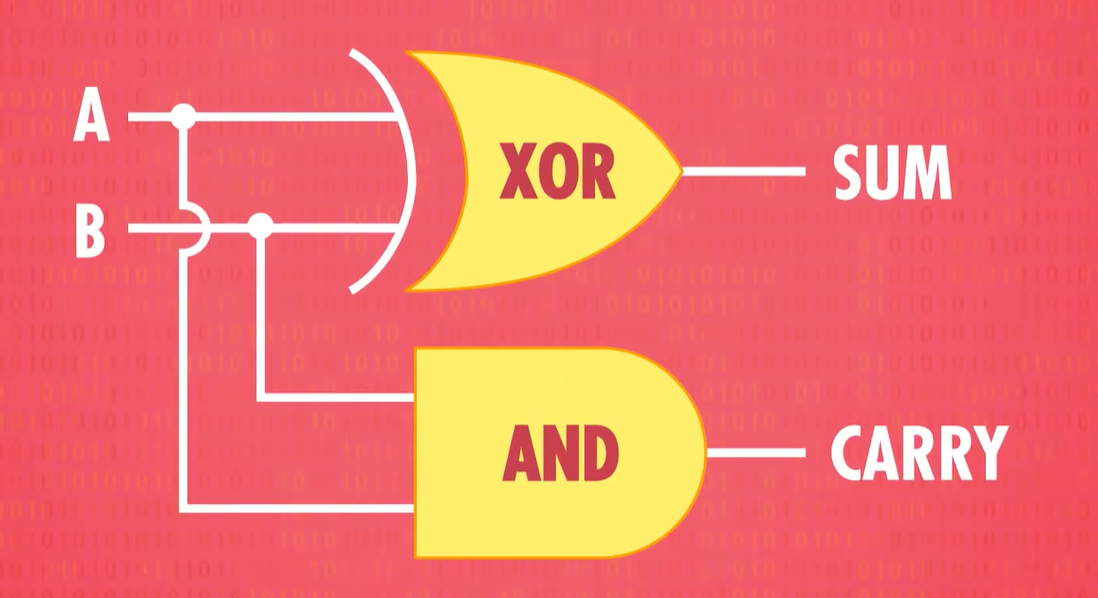
半加器能够处理两个单位二进制相加的运算,并返回一个单位结果和进位标志
但是半加器只能将两个单位二进制数加在一起,并不能处理前面有进位的情况,这种情况我们就需要一个全加器,用来计算3个单位二进制数相加的情况: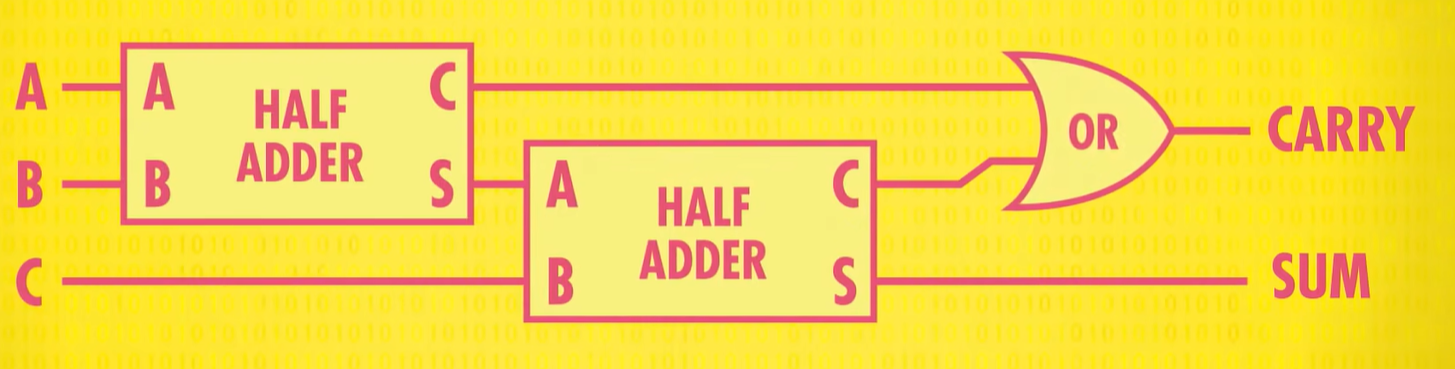
全加器能够处理三个单位二进制相加的运算,并返回一个单位结果和进位标志
现在,我们就能处理两位以及三位二进制单位相加的情况了。但是很显然,半加器和全加器都只能够处理单位数的二进制运算,那我们怎么处理多位二进制的运算呢?
我们把全加器和半加器再进行抽象包装,然后用七个全加器和一个半加器做成一个8位行波数位加法器,简称加法器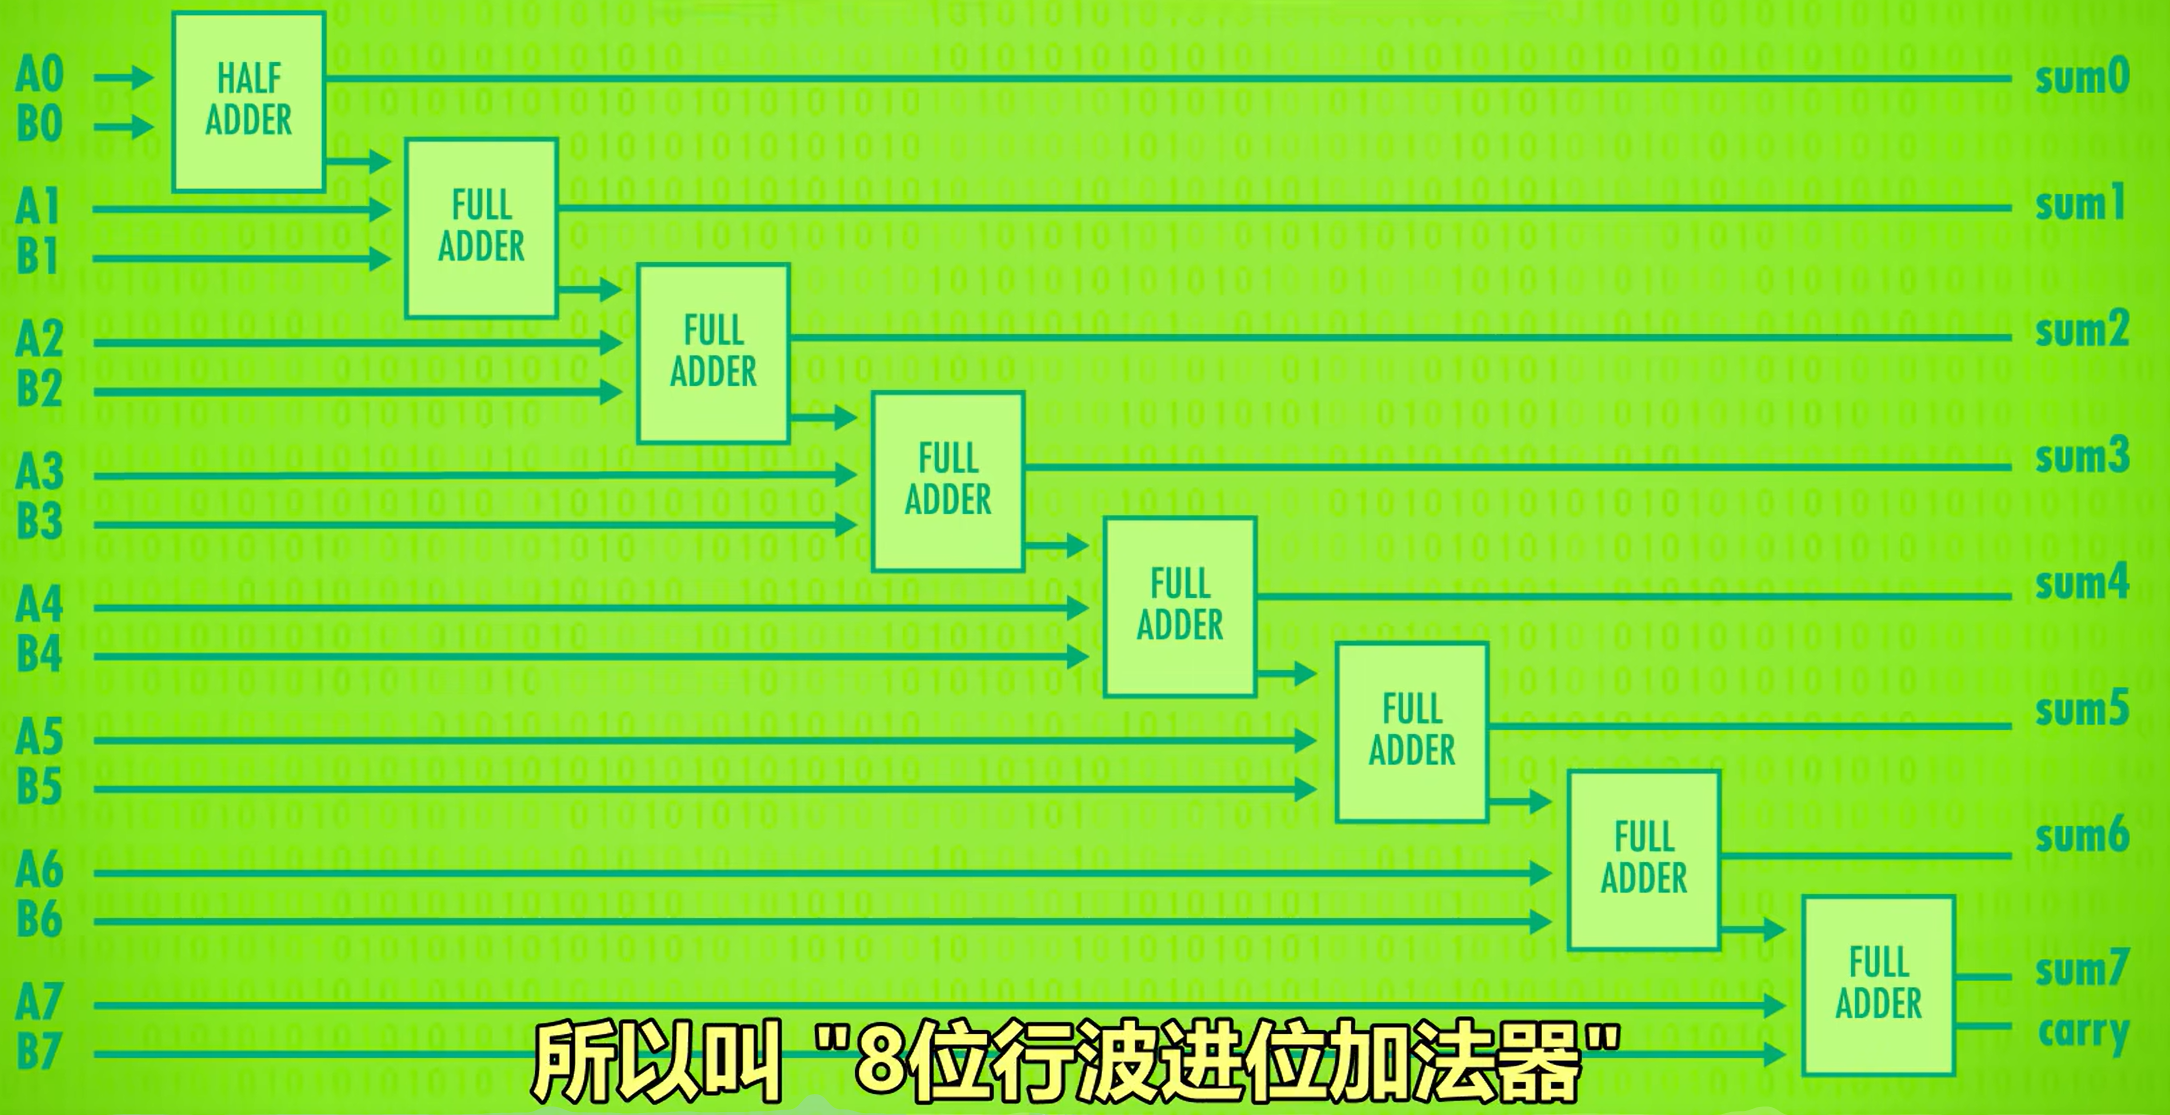
这样的一个算术单元已经能处理两个基本数的运算了
需要注意的是,如果结果超过8位,会产生overflow(溢出),会导致单元甚至系统出错,我们可以使用更多位的算术单元解决这个问题
逻辑单元
除了加法,CPU 还需要执行各种逻辑判断,例如:
- 与运算
- 或运算
- 异或运算
- 取反运算
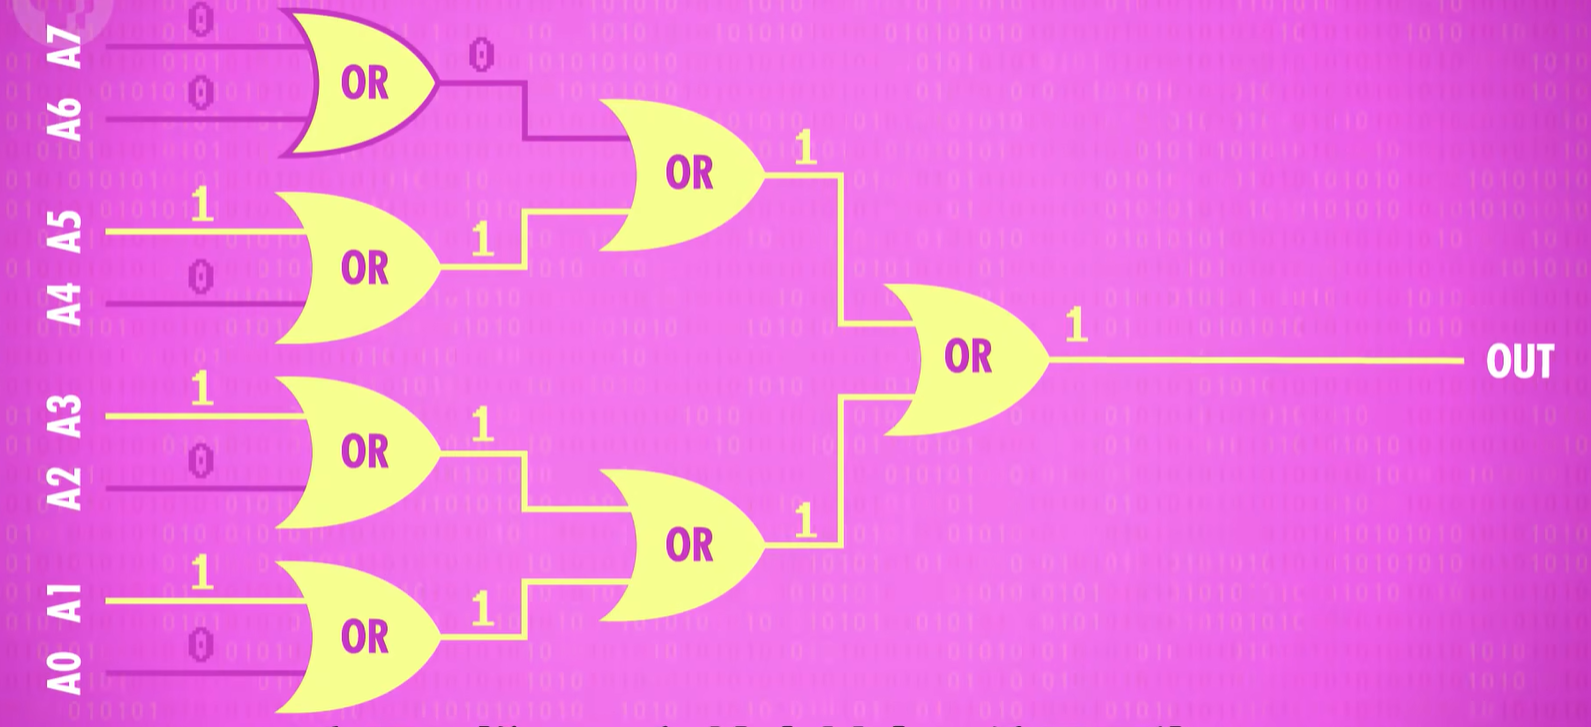
- 判断结果是否为 0
这些功能可以由逻辑门组合成逻辑单元
ALU
我们做把加法器、逻辑单元等单元组合到一起,就能得到一个ALU,即算术逻辑单元
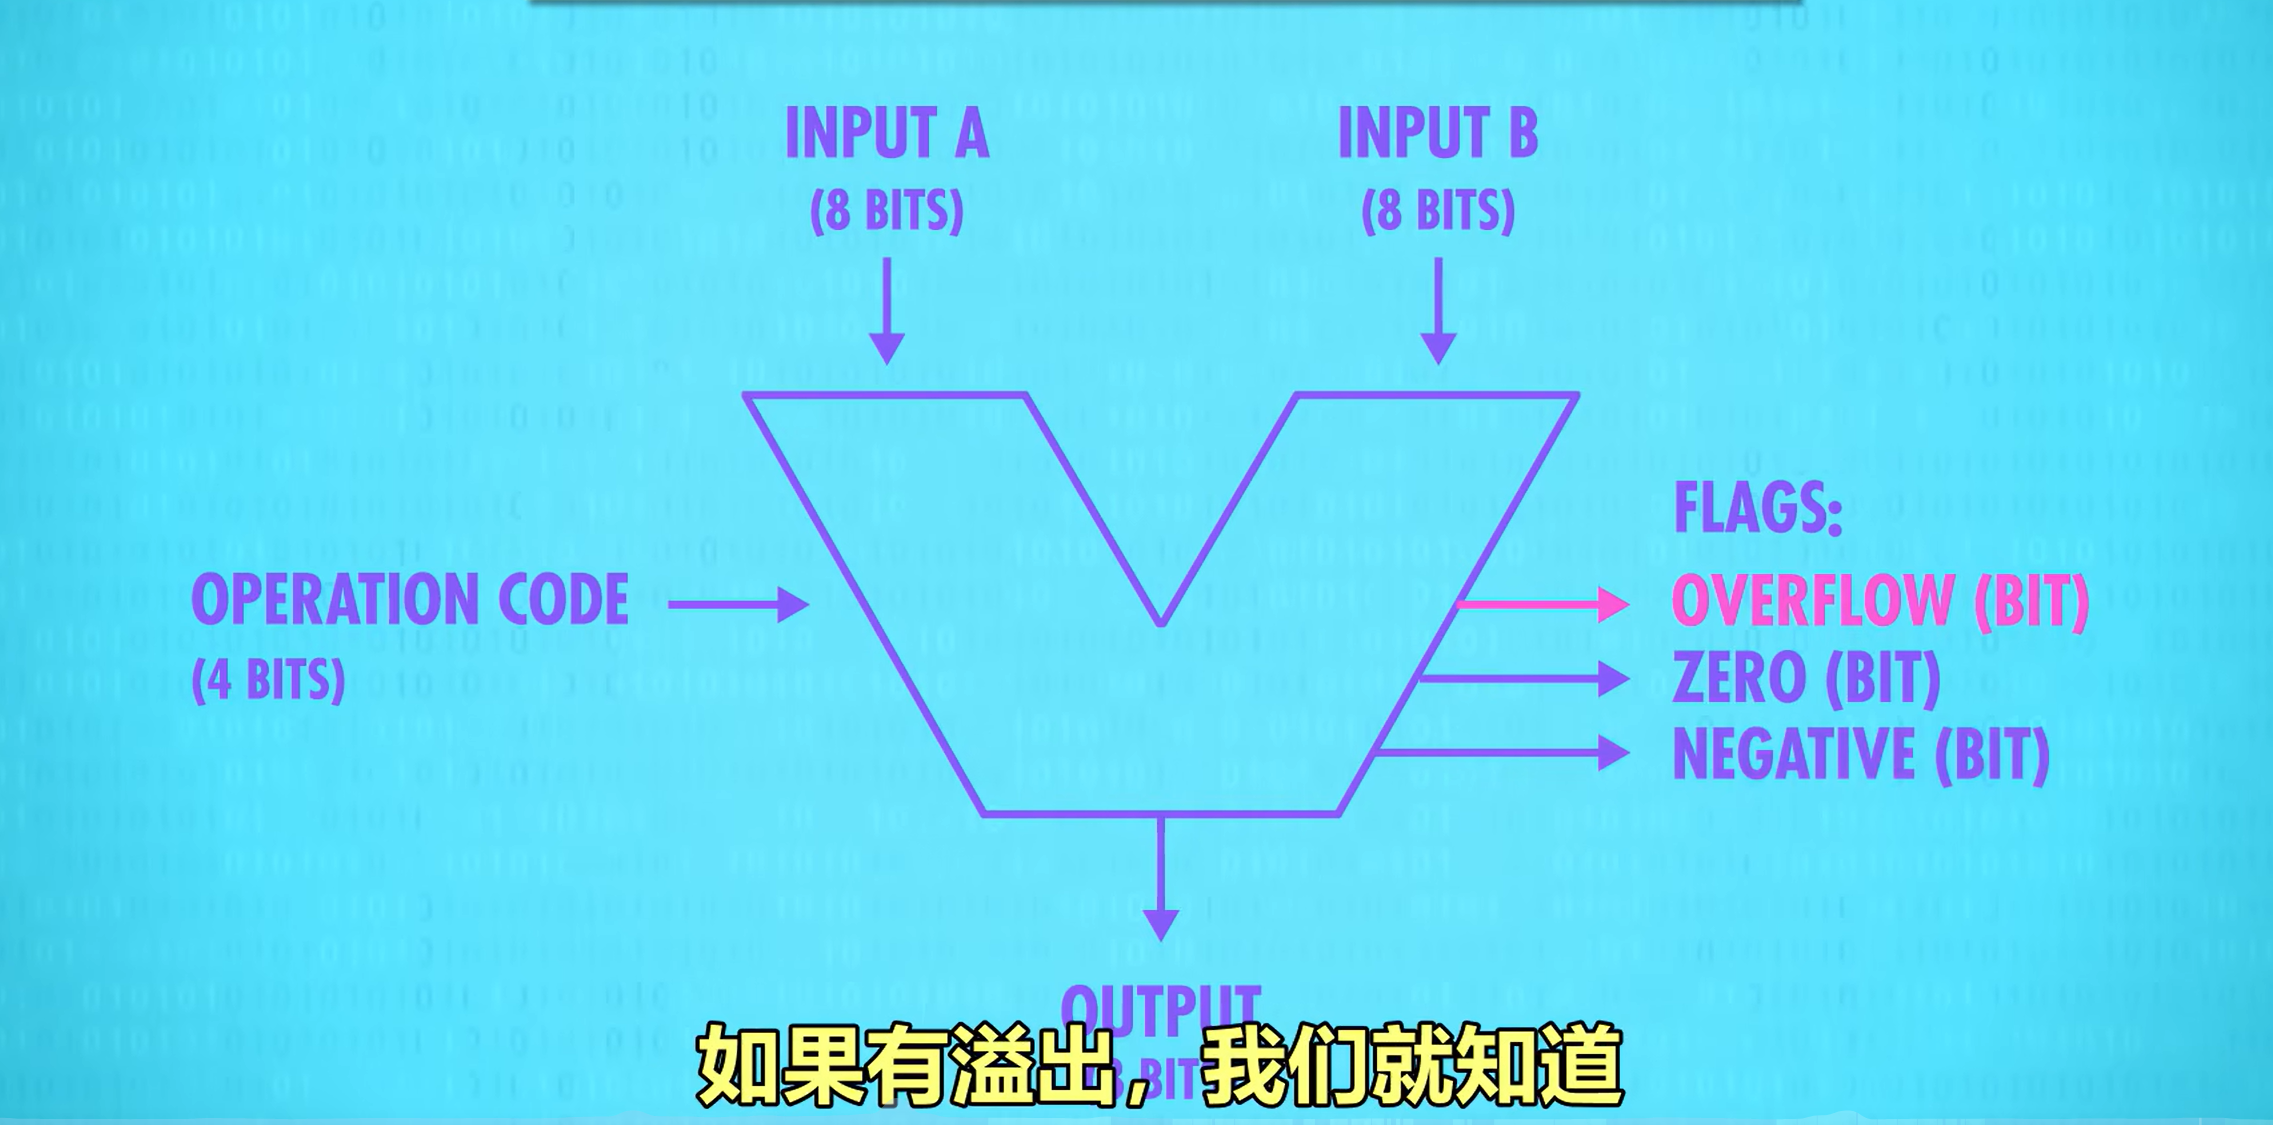
这个ALU可以接收一个操作码并处理两个8位二进制数的基本运算,并判断是否溢出、结果是否为零或者小于零
RAM
解决了运算的问题,接下来我们来看看怎么将数据保存起来,并最终解决RAM,即内存的实现
锁存器
首先,我们先看看怎么做一个存1位的电路,也就是锁存器
这一块的实现真的很fantastic,可以看看这个视频:计算机科学速成课 | 寄存器 & 内存
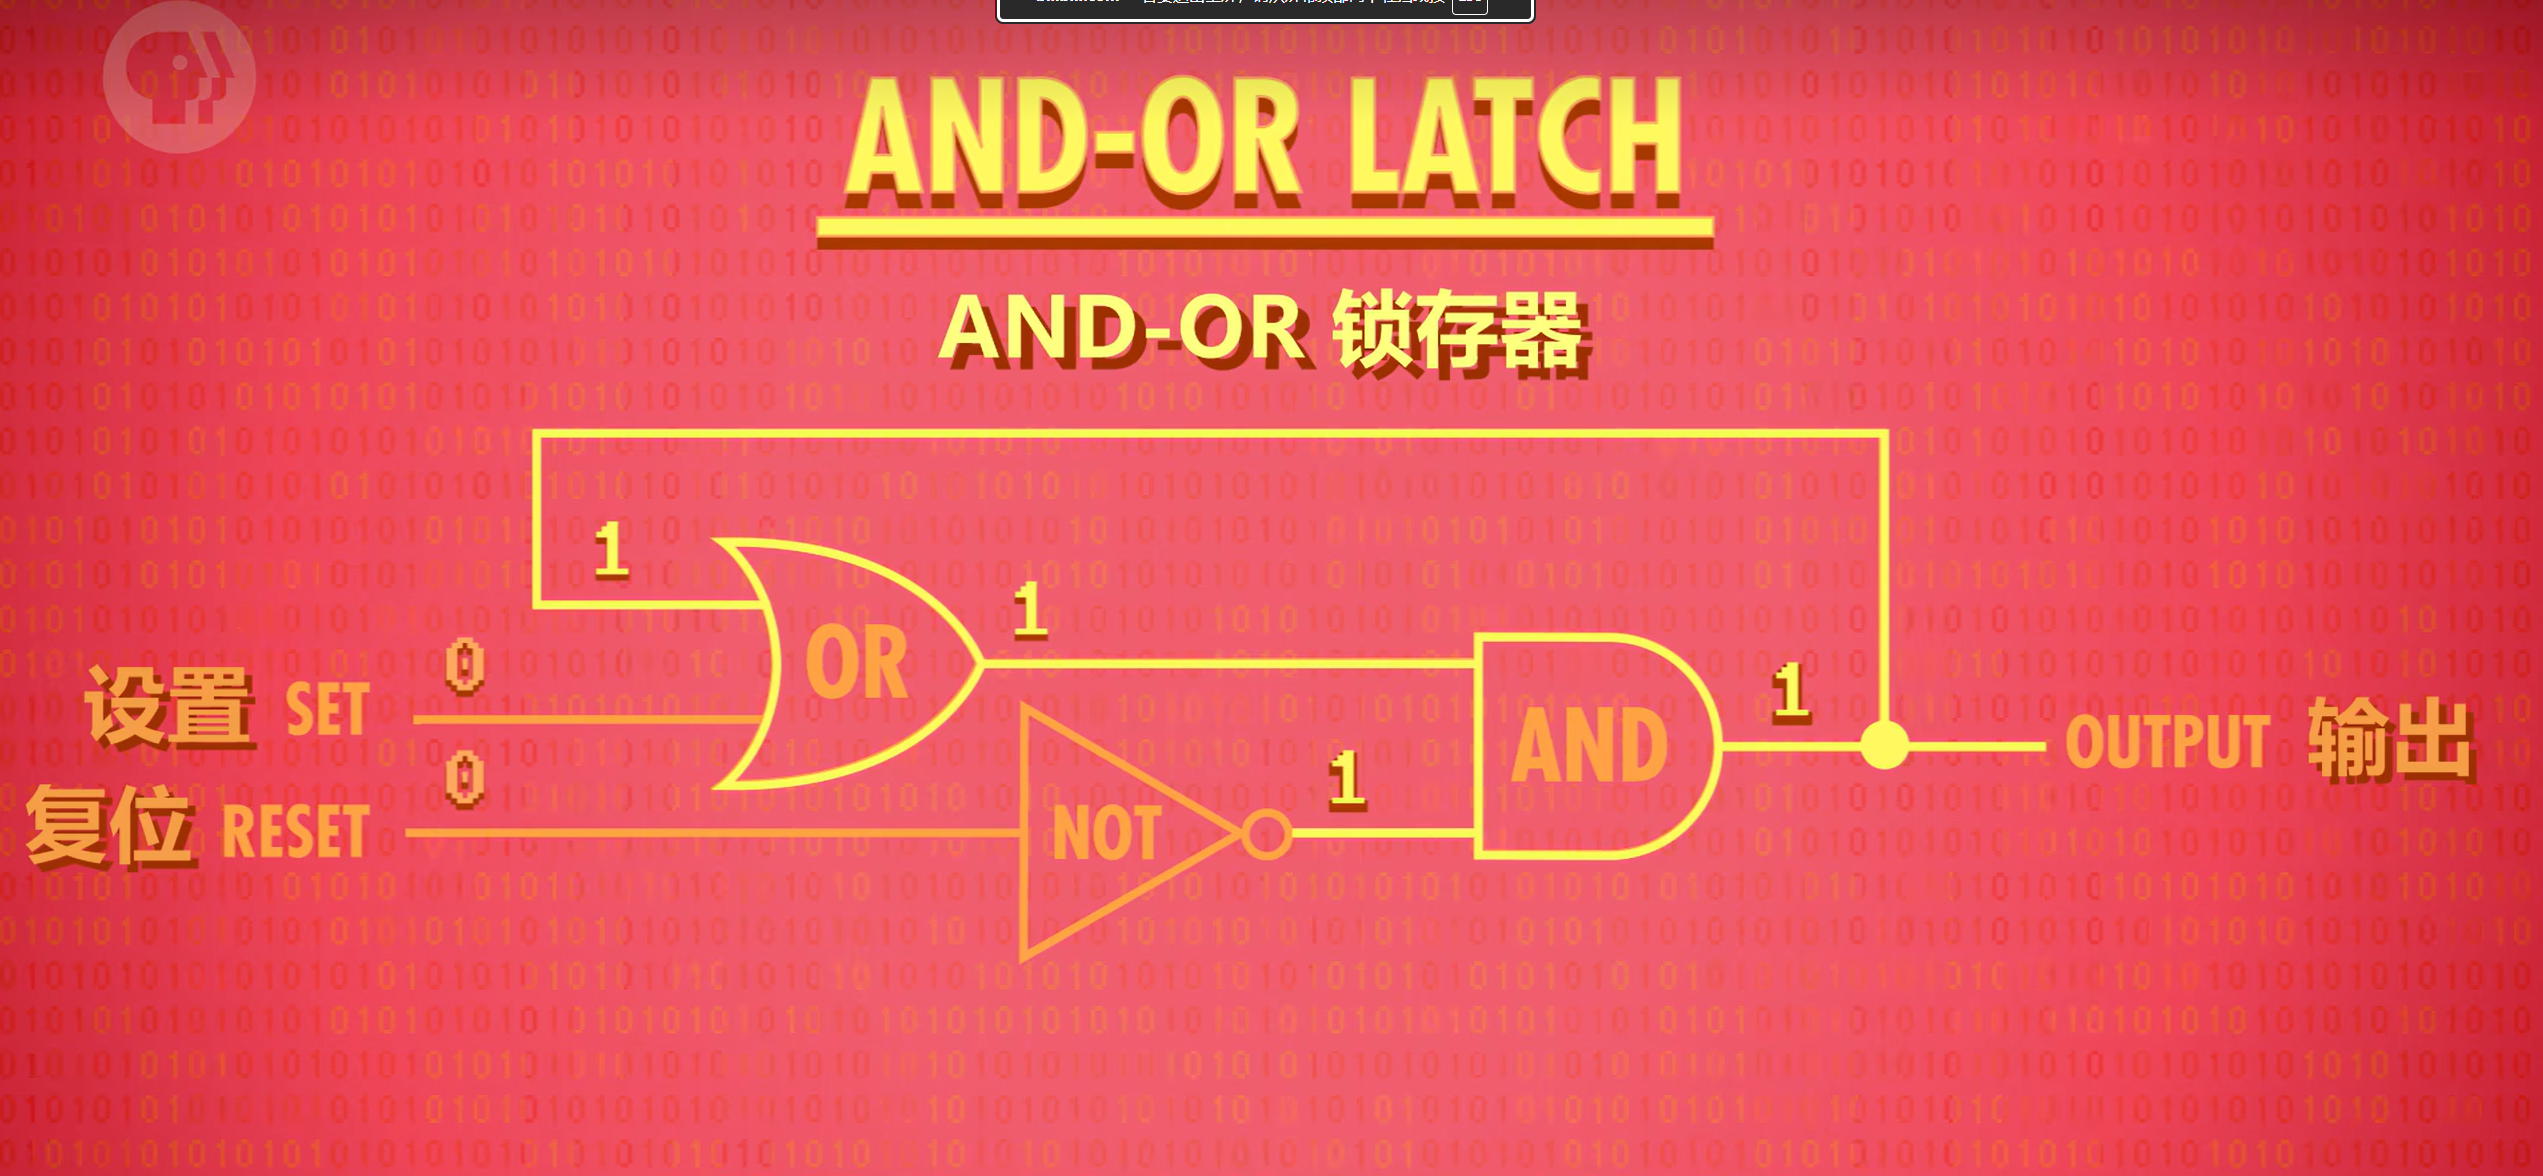
这样的一个AND-OR锁存器可以存储一位的二进制信息,但是用“复位”和“设置”来控制锁存器,还是有点复杂,于是我们可以层这个样子:
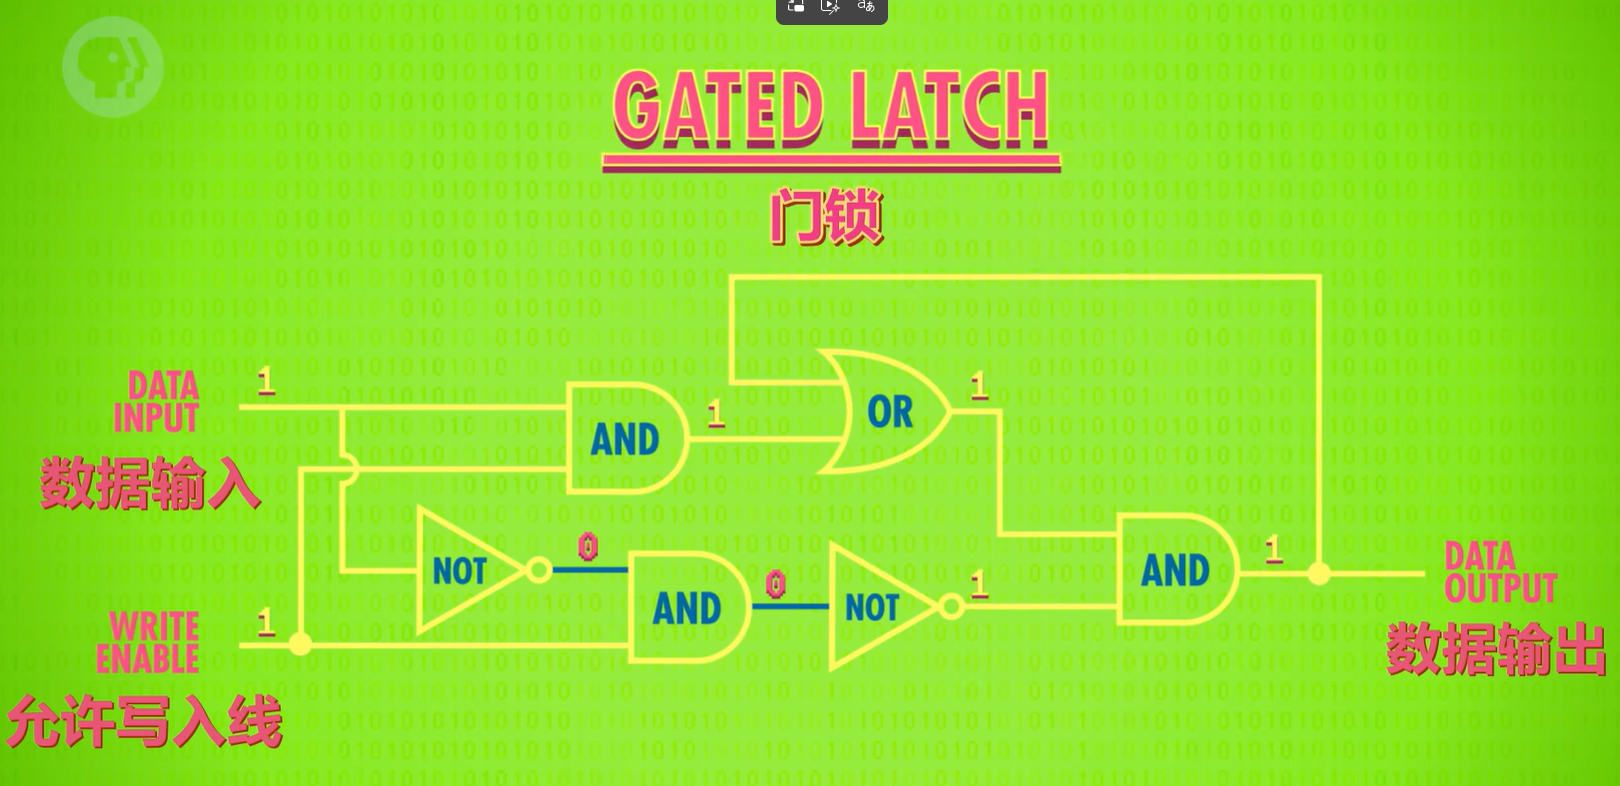
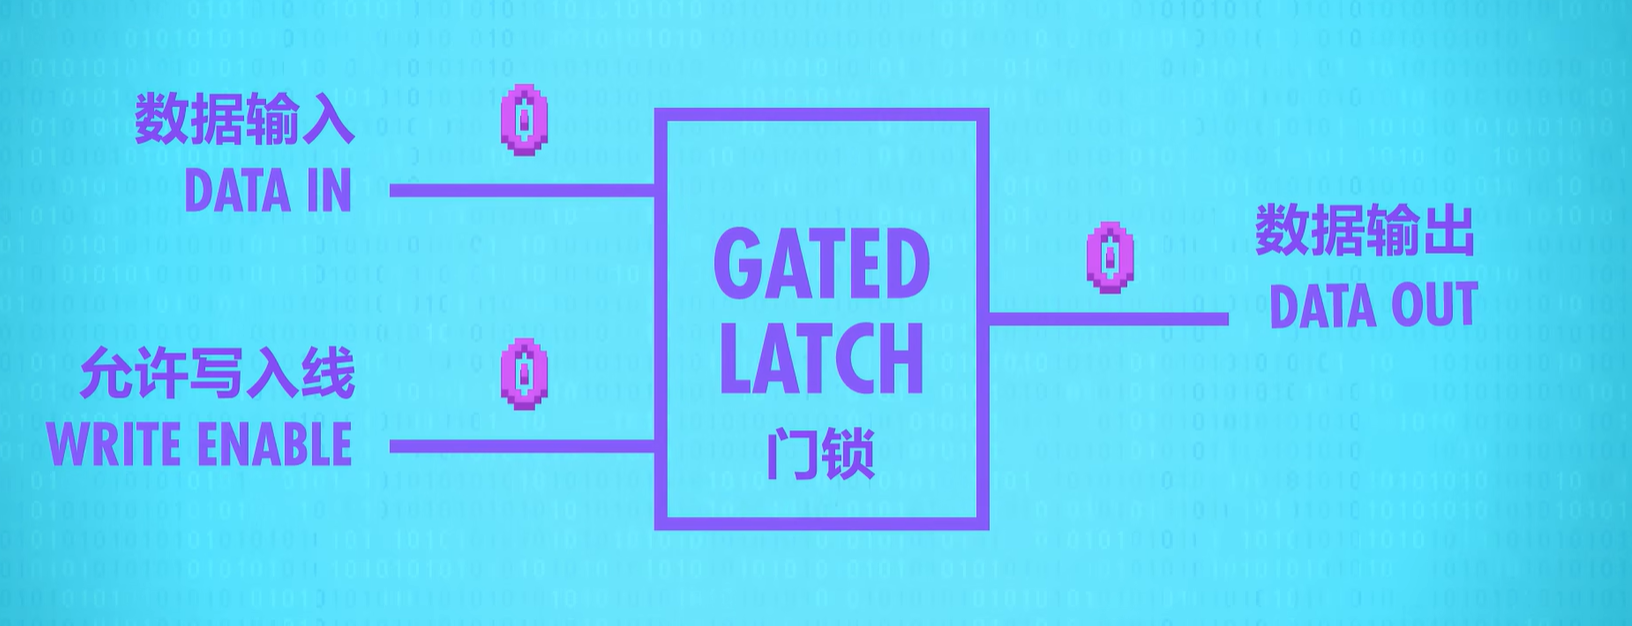
这种结构允许我们用“数据输入”线和“允许写入线”来控制信息存储
现在,我们又可以把门锁向上抽象,包装为一个不关心细节的整体结构,像这样:
寄存器
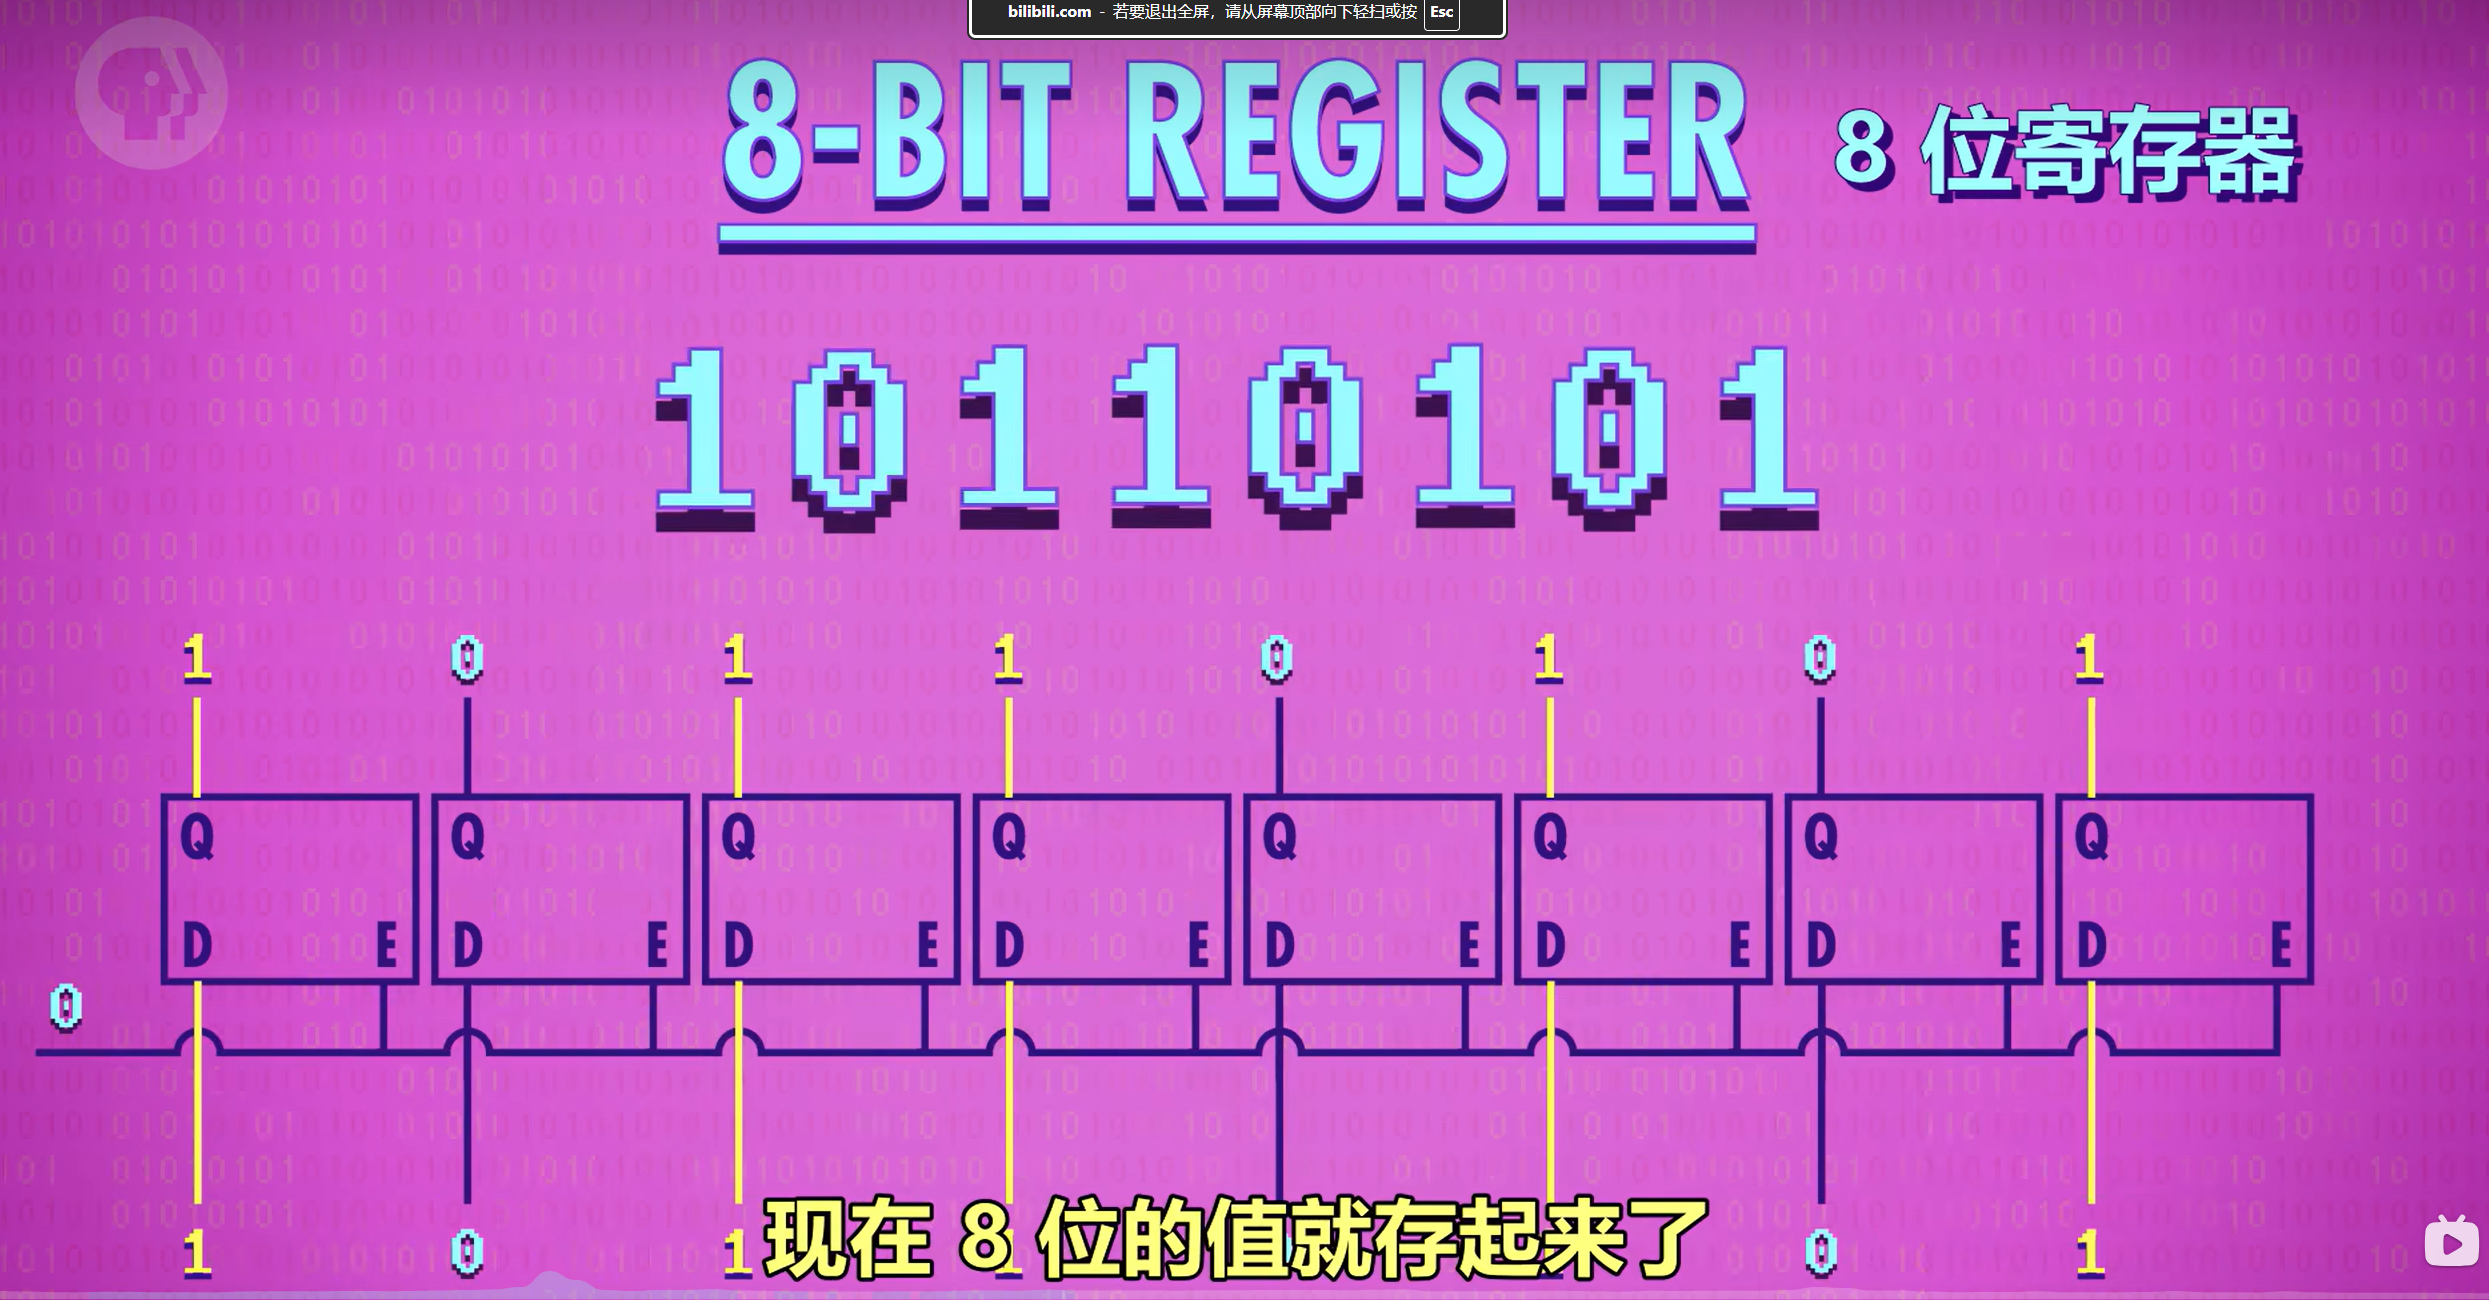
只存储一位信息并没有什么用处,但如果我们并排放8个锁存器,这样就可以存储8位信息,例如一个8位数字。一组这样的锁存器就叫做寄存器。寄存器能存储一个数字,大小取决于其位宽,现在大多数电脑都使用64位宽的寄存器
写入寄存器前,要先启用所有锁存器,我们可以用一根线链接所有“允许输入线”,设为 1 ,然后用8条数据线发数据,再将“允许写入线”改为 0 ,这样就可以存储n位信息。例如一个八位寄存器:
矩阵存储
问题来了:如果只存8位数字很简单,但如果我们要存64位数字,就需要用到至少129根线;256位要用513根线,大大增加了物理成本
解决方法是矩阵。在矩阵中,我们不并排放置锁存器,而是做成网格
我们要存256位数据,就用16x16网格的锁存器,要启用某个锁存器,就打开对应的行线和列线
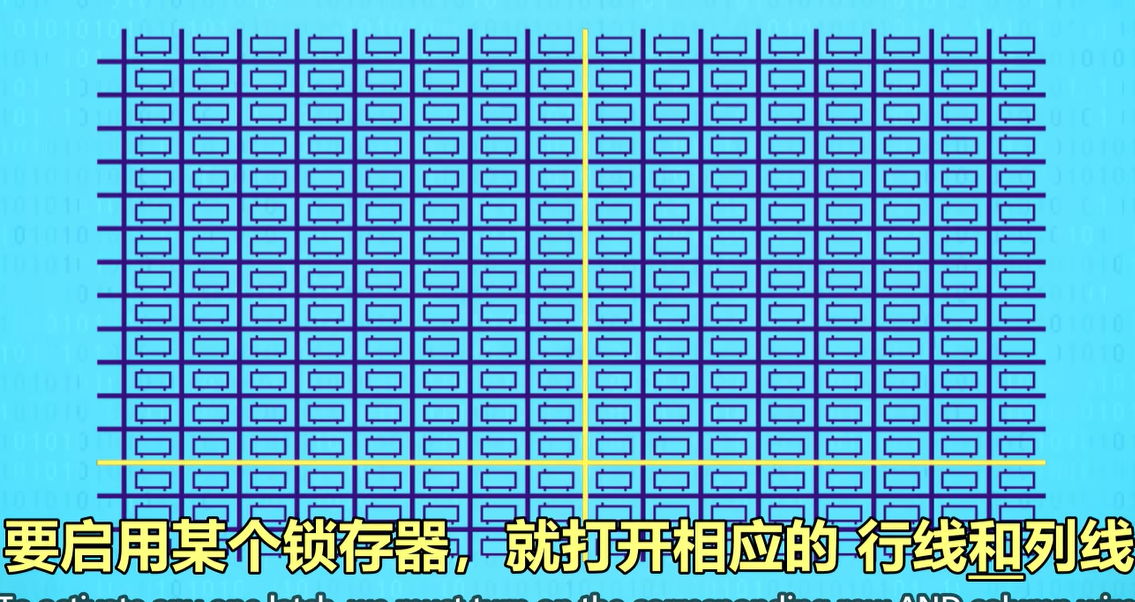
并且,我们在锁存器前加一个AND逻辑门,只有当行线和列线均为1,AND门才输出1,这个锁存器才被启用,这样就可以选择使用单个锁存器
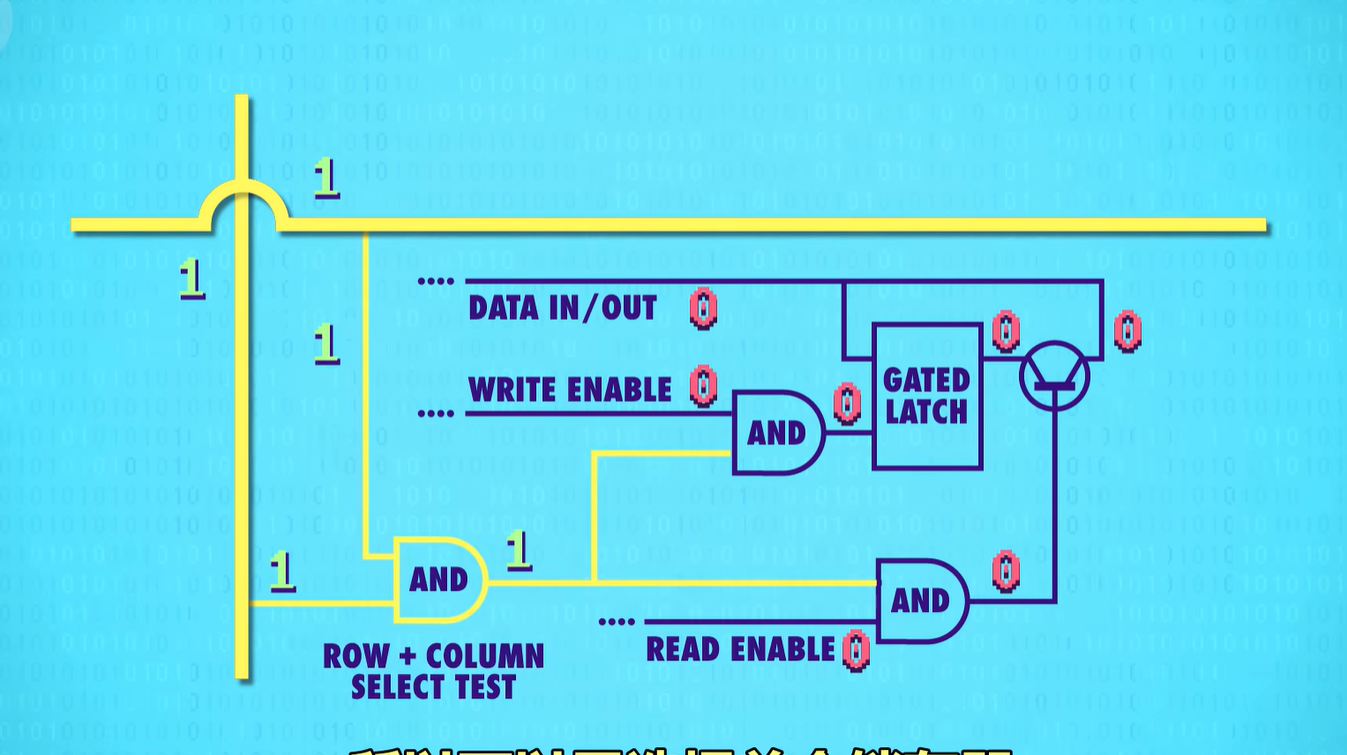
这种行列排列法,用一根“允许写入线”连所有寄存器,并且由于写入数据需要行列线均被打开,能保证每次只有单个锁存器被使用,我们也就可以只用一根“数据传输线”连所有锁存器来存数据。类似地,我们也可以只用一根“允许读取线”从一个指定的锁存器中读取数据
这样一来,我们只需要用16+16+1+1+1=35条线就能做到256位存储
多路复用器
同时,我们可以把一个锁存器所在地位置称为“地址”,例如一个12行8列的锁存器。由于行列数都是16,我们可以使用4位数来表示地址,所以12行8列也可以说成地址1100 1000
为了将地址转换成物理上的行和列,我们需要用多路复用器
因为有16行16列,我们使用两个1到16多路复用器:
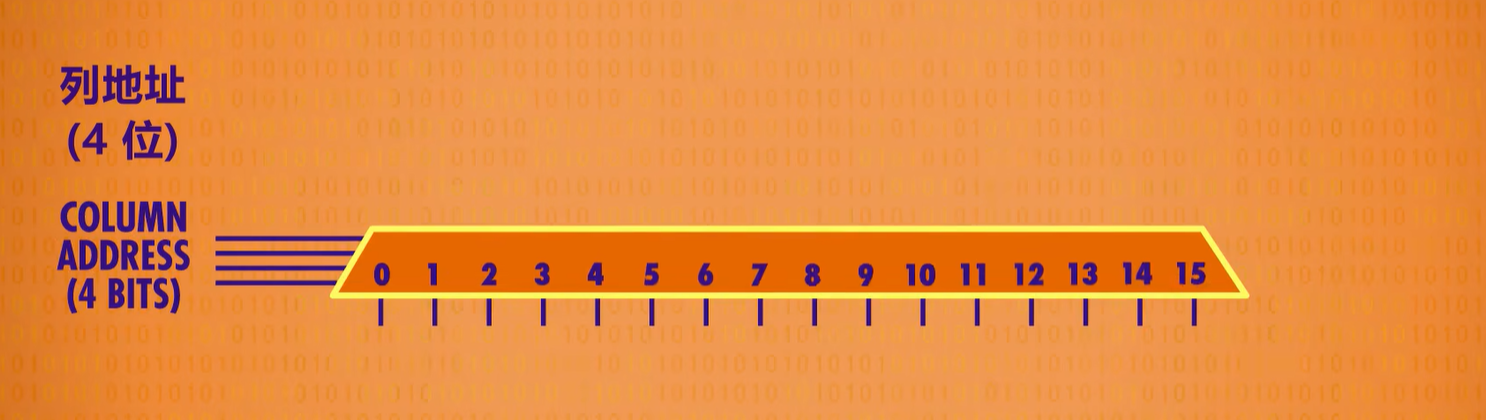
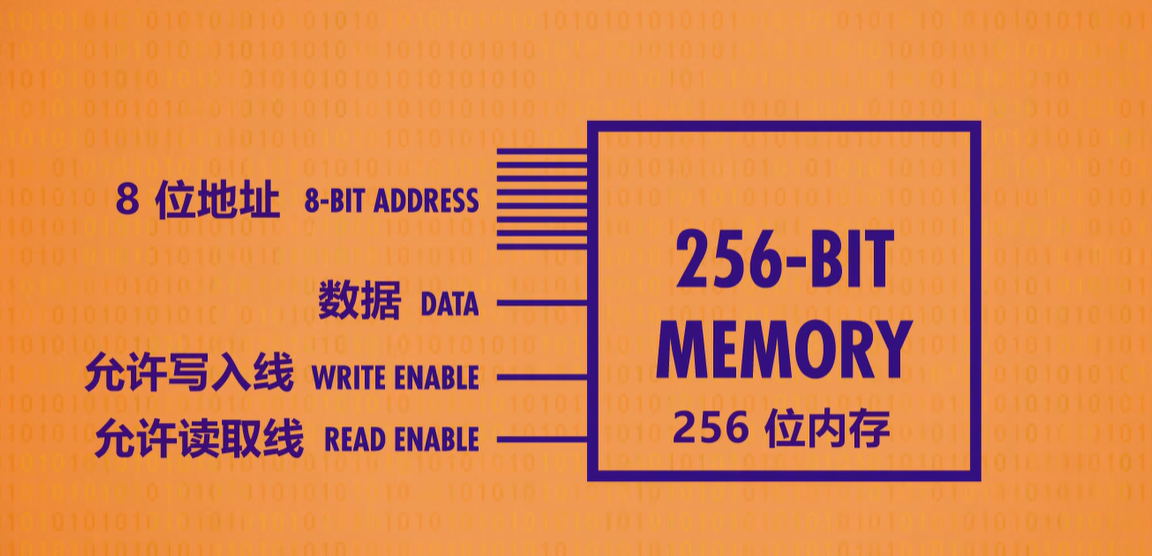
使用两个这样的多路复用器管理地址后,我们便做成了一个256位内存,于是我们又提升了一个抽象:
RAM
可惜的是,即使是256位内存也干不了任何事
我们可以把这些内存单元并排放置,一行八个,可以存256个8位数字,八位也是一个字节。为了存8位数字,我们同时8个256位内存一样的地址,每个地址存一位,总共能存256字节的数据,这样我们就做成了一个可寻址内存——RAM:
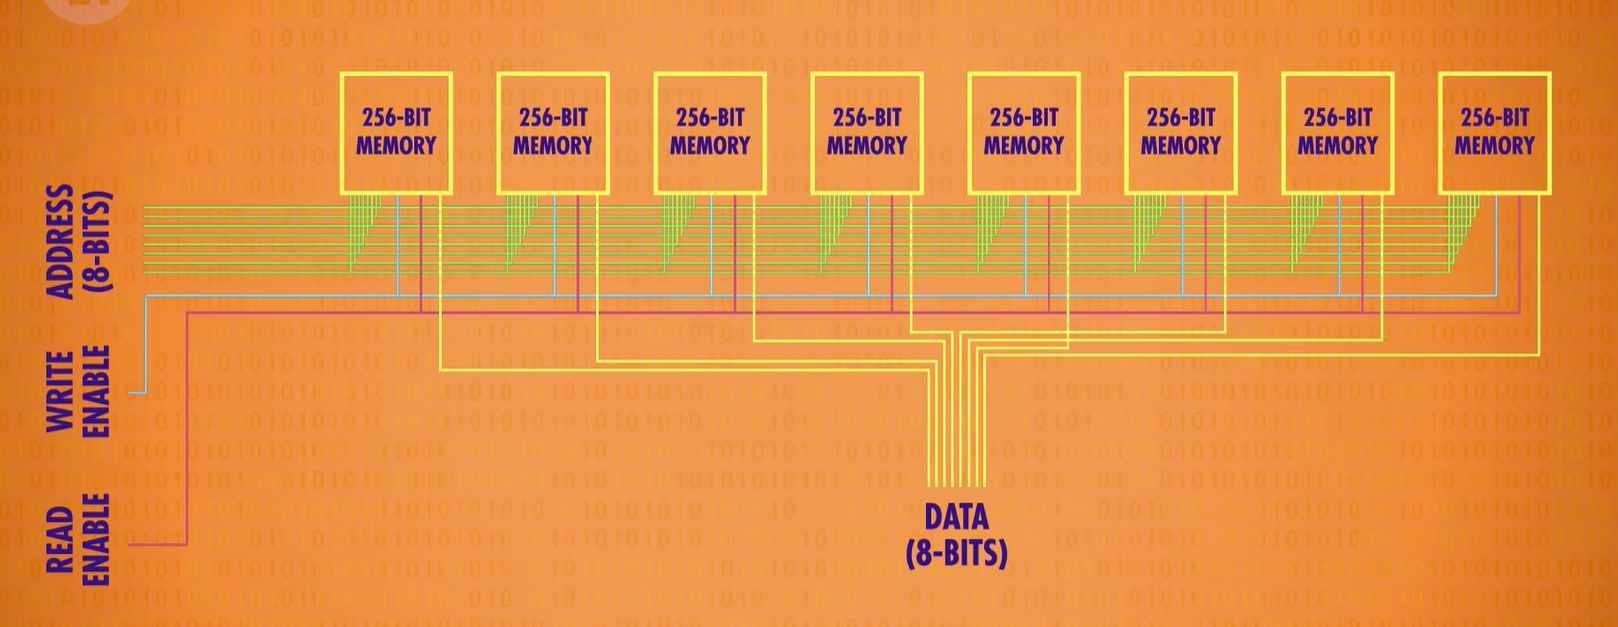
我们再次向上抽象,得到这样的RAM结构:
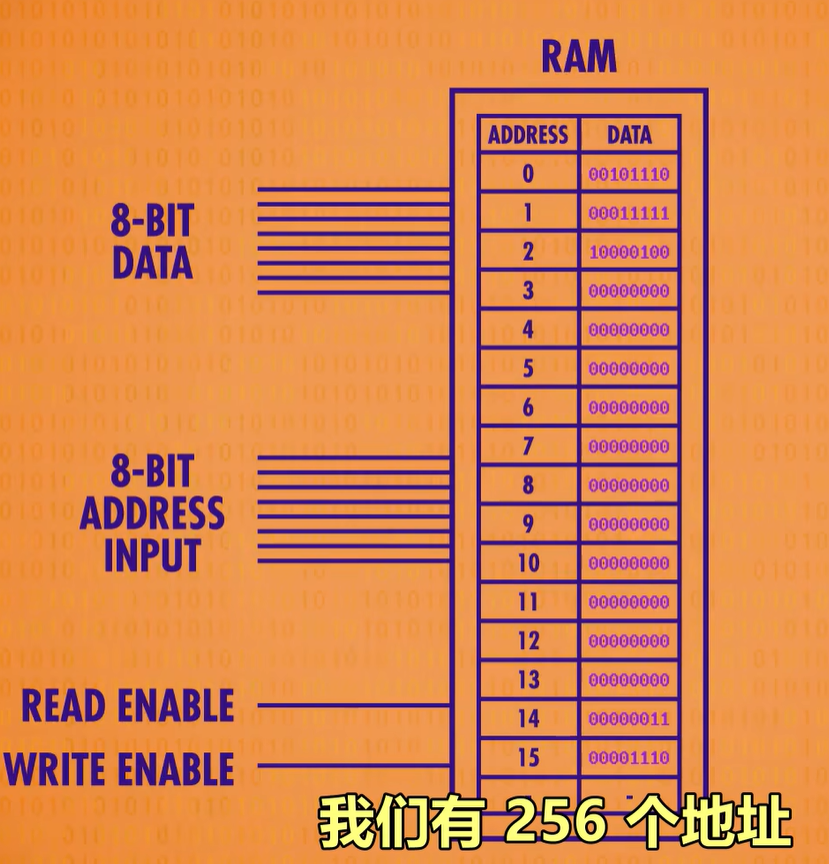
我们的RAM就这样做出来了
内存的一个重要特性就是:可以随时访问任何位置,所以才叫做“随机存取存储器(Random Access Memory)”,即RAM
同时,我们使用寄存器这样实现RAM叫做SRAM,即静态随机存取存储器
CPU
之前,我们设计并实现了加法器、ALU、寄存器、RAM等部件,现在我们来看看怎么用这些部件构建一个中央处理单元——CPU
首先我们要知道,程序由一个个操作组成,这些操作叫做“指令”。如果是数学指令,例如加减乘除,CPU会让ALU进行数学运算;也可能是内存指令,CPU会和内存通信,然后读/写值
现在我们来构建CPU,推荐视频:计算机科学速成课 | 中央处理器(CPU)
CPU的构成
首先,我们使用上次搓的RAM,再加上4个寄存器A、B、C、D存储临时数据,用来实现CPU执行内存指令的操作
然后,我们给CPU支持的所有指令分配一个ID,叫做指令表。例如0010表示LOAD_A,将当前地址的内存值放进寄存器A中:
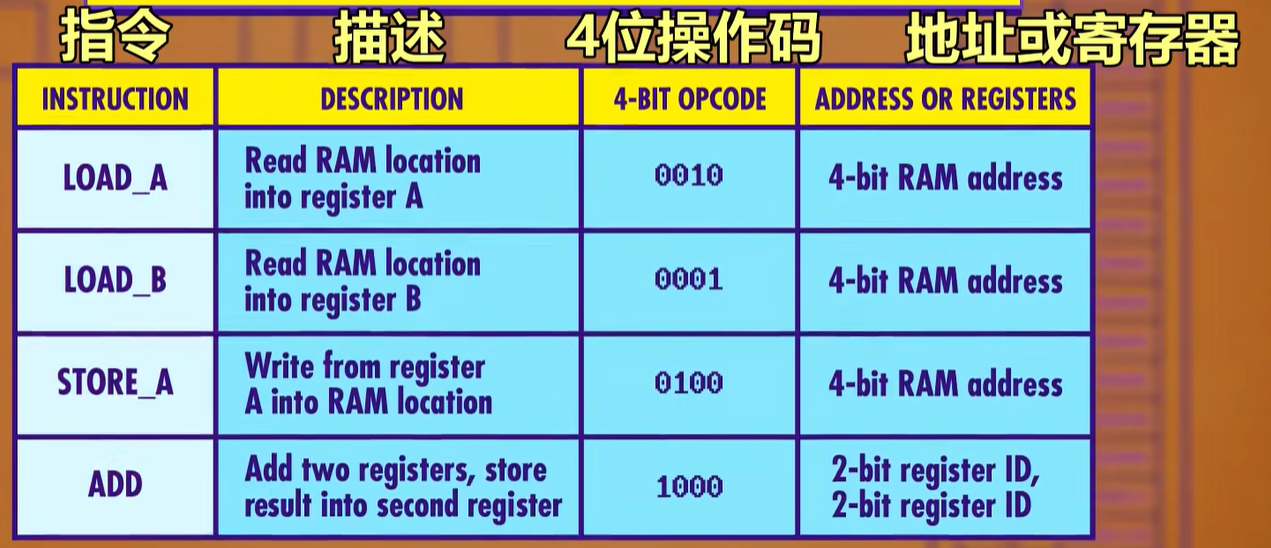
然后,我们还需要两个寄存器来完成CPU:
- 其一,用一个寄存器跟踪程序运行到哪里了,我们叫它“指令地址寄存器”,用来存当前指令的内存地址
- 其二,用一个寄存器存当前指令,叫“指令寄存器”
最终结构是这样的: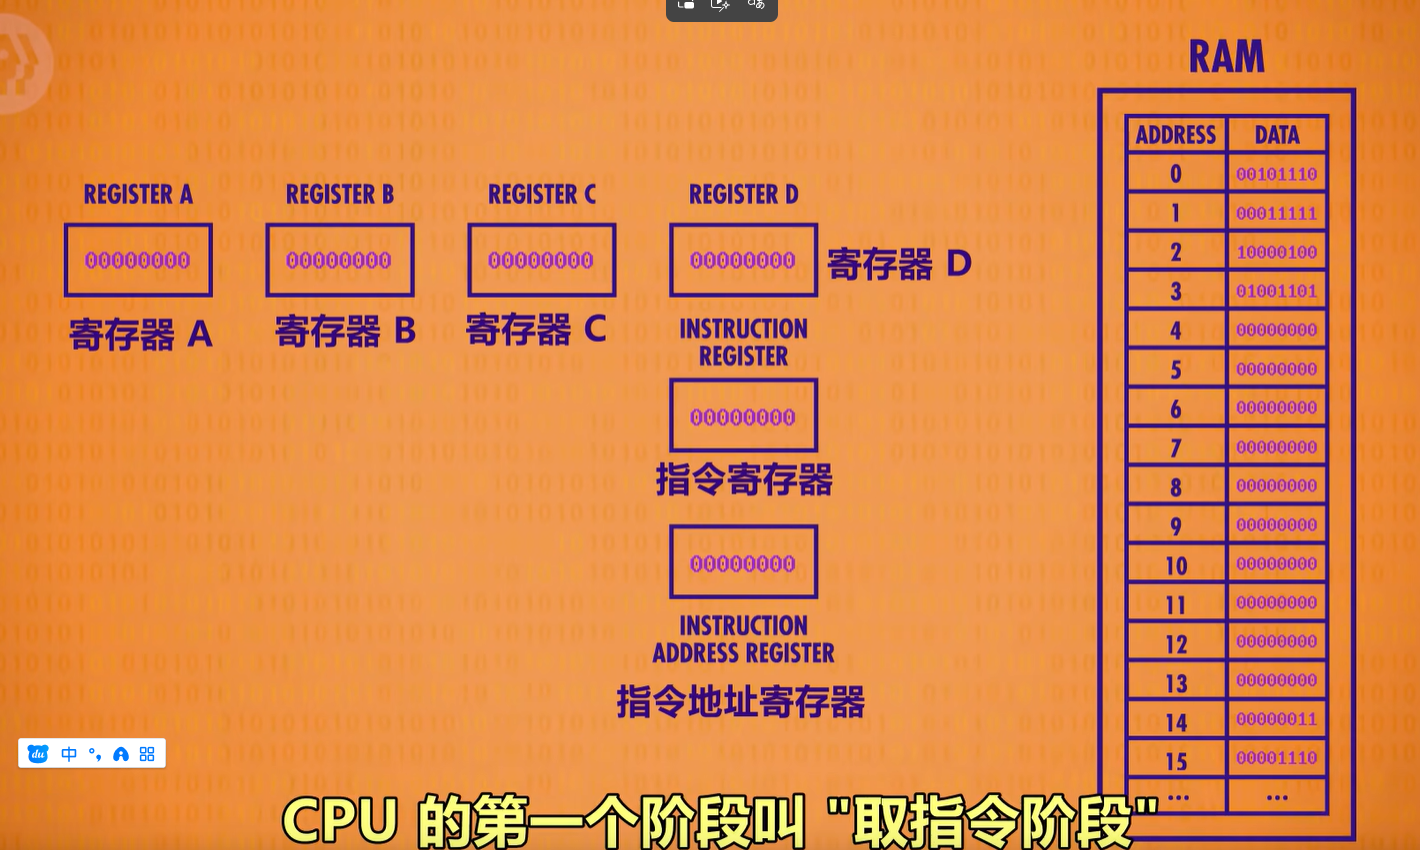
CPU的运行
当启动计算机时,所有寄存器从0开始
然后,CPU进入这些阶段:
- 首先,进入“取指令阶段”,CPU将“指令地址寄存器”连到RAM,把RAM里的值复制到“指令寄存器”里
- 然后,来到“解码阶段”,分析指令寄存器里的值,并把值转换成操作码和数据,并进一步把操作码映射成指令
- 接下来,来到“执行阶段”,执行指令对应的操作
我们可以把CPU内部控件,除了四个寄存器以外的部件都进行抽象包装,得到这样的结构:
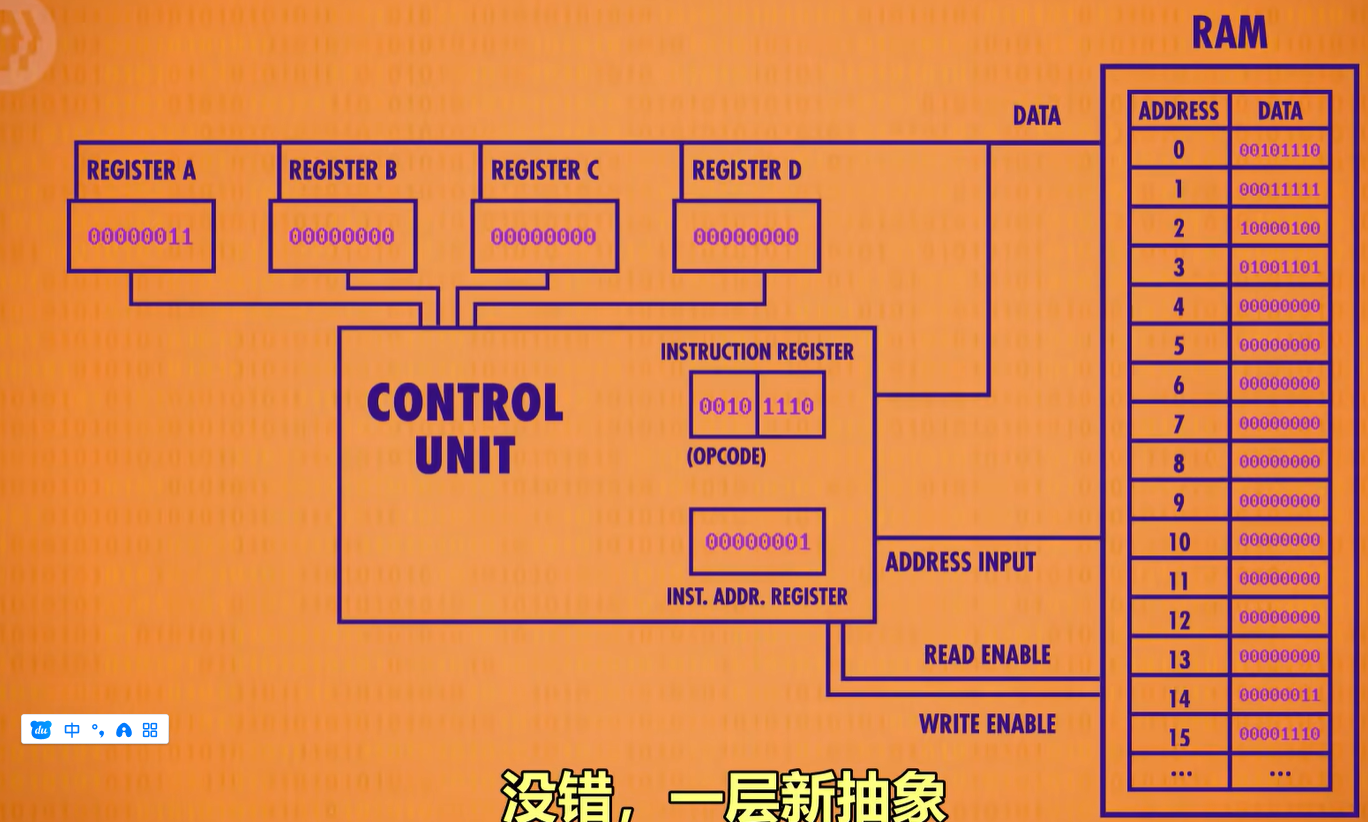
同时,对于一些需要计算的指令,如ADD,我们需要将ALU集成到CPU中进行运算:
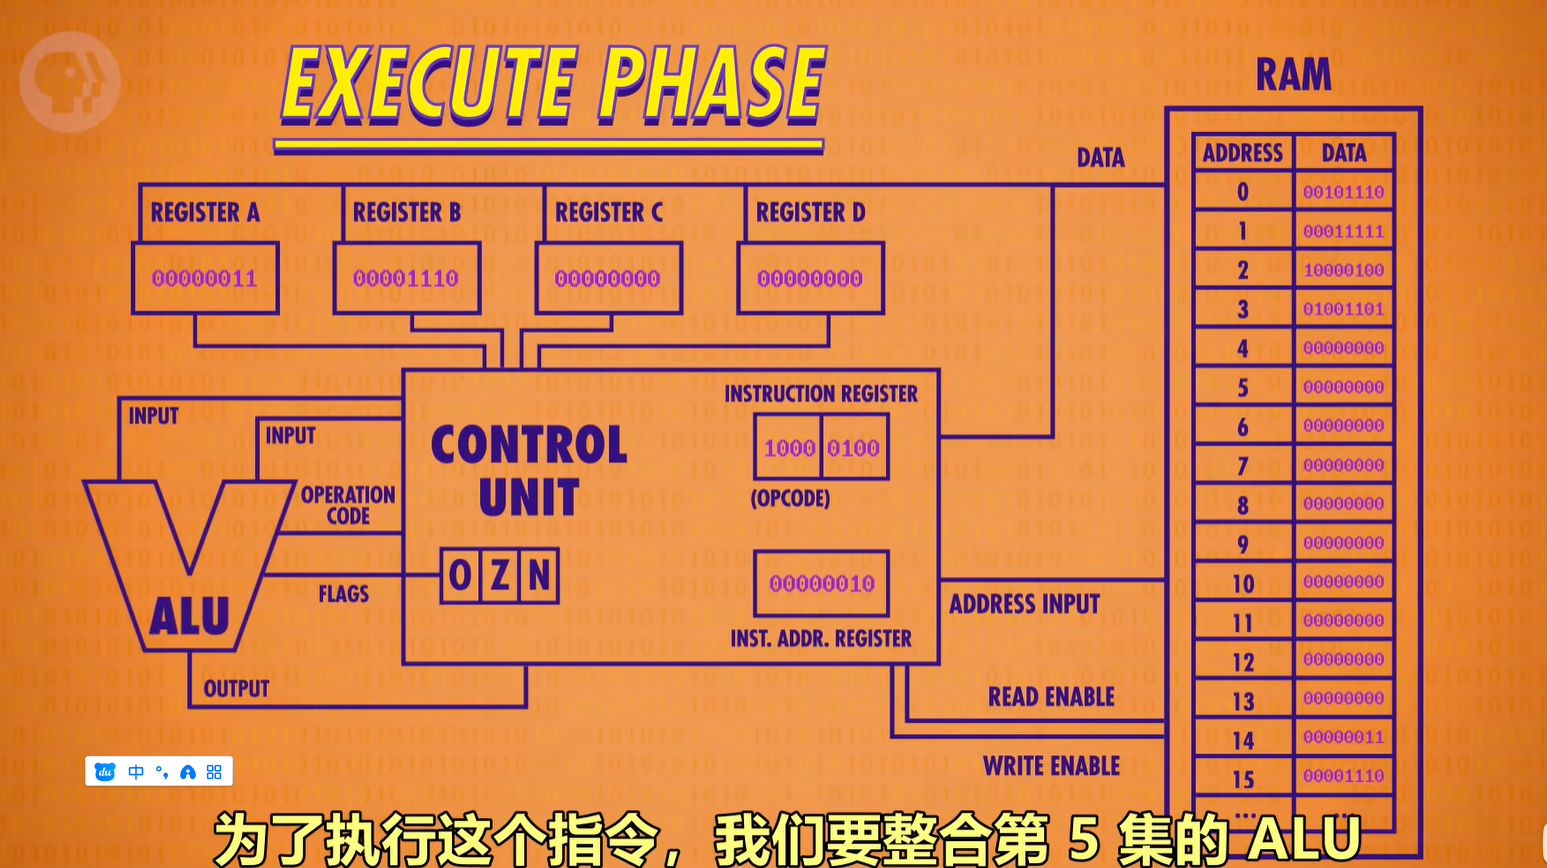
CPU时钟
CPU循环的运行还需要CPU时钟的操控,时钟负责管理CPU的节奏,以精确的间隔触发电信号,而控制单元会用这个电信号推进CPU的内部操作
CPU“取指令 -> 解码 -> 执行”的速度叫“时钟速度”,单位是赫兹Hz
CPU组成 - 指令集 - CPU循环 - 时钟/赫兹
加上CPU时钟后,我们便构建了一个完整的CPU:
机器码、汇编语句与指令集
我们说到,CPU可以执行特定指令,这个指令就是机器码,不同的机器码代表不同的指令,例如“将寄存器A与寄存器B的值相加并吧结果存在寄存器A里”
但是,机器码是一串二进制数据,直接由人来书写和阅读都非常困难。因此,人们设计了汇编语言,并通过汇编器把可读的汇编语句转换成机器码。例如0001 1111,我们可以设计机器码的前4位表示操作行为,后4为表示数值,如果 0001 表示 LOAD B,而 1111 表示地址 15,那么这条机器码就可以表示 LOAD B, 15,即将 RAM 里地址为 15 的复制值到寄存器 B 里
这就是汇编语句,是机器码的人类可读写法,而指令集 ISA 就是 CPU 支持的所有机器指令的集合。不同指令集有各自不同的机器码格式,也通常有不同的汇编语法
| 操作含义 | x86 / x86-64 | ARM / AArch64 | MIPS | RISC-V |
|---|---|---|---|---|
| 数据移动 | mov eax, ebx |
mov x0, x1 |
move $t0, $t1 |
mv x5, x6 |
| 加法 | add eax, ebx |
add x0, x1, x2 |
add $t0, $t1, $t2 |
add x5, x6, x7 |
| 减法 | sub eax, ebx |
sub x0, x1, x2 |
sub $t0, $t1, $t2 |
sub x5, x6, x7 |
| 乘法 | imul eax, ebx |
mul x0, x1, x2 |
mul $t0, $t1, $t2 |
mul x5, x6, x7 |
| 除法 | idiv ebx |
sdiv x0, x1, x2 |
div $t1, $t2 |
div x5, x6, x7 |
| 读取内存 | mov eax, [ebx] |
ldr x0, [x1] |
lw $t0, 0($t1) |
lw x5, 0(x6) |
| 写入内存 | mov [ebx], eax |
str x0, [x1] |
sw $t0, 0($t1) |
sw x5, 0(x6) |
| 比较 | cmp eax, ebx |
cmp x0, x1 |
slt $t0, $t1, $t2 |
slt x5, x6, x7 |
| 无条件跳转 | jmp label |
b label |
j label |
j label |
| 条件跳转 | je label |
beq label |
beq $t0, $t1, label |
beq x5, x6, label |
| 函数调用 | call func |
bl func |
jal func |
jal ra, func |
| 函数返回 | ret |
ret |
jr $ra |
ret |
不同指令集的汇编语法差异很大。比如 x86 常见写法是“目标在前,来源在后”,而 MIPS、RISC-V 这类 RISC 指令集通常采用“三操作数格式”,也就是 操作 目标, 来源1, 来源2。
CPU流水线
概述
我们前面提到过CPU的运行原理,而在实际上,CPU还会使用流水线提高指令吞吐率
单周期处理器中,一条指令必须完整走完取指、译码、执行、访存、写回之后,下一条指令才开始。流水线把一条指令的执行过程拆成多个阶段,让多条指令同时处在不同阶段中,就像生产线一样
流水线把指令执行拆成若干阶段,例如:
IF -> ID -> EX -> MEM -> WBIF:Instruction Fetch,取指。ID:Instruction Decode / Register Read,译码和读寄存器。EX:Execute,执行 ALU 运算或计算地址。MEM:Memory Access,访问数据存储器。WB:Write Back,写回寄存器
而对于一条完整的CPU循环,需要顺序执行这五个操作,我们假设每个操作需要一个CPU时间,那么一个完整CPU循环需要5个时间,这不符合我们对高性能的需求。同时,我们注意到,循环中每个阶段涉及到的硬件是不同的,那么意思就是说,我们可以在同一时间安排不同循环的多个阶段一起工作,就像这样:
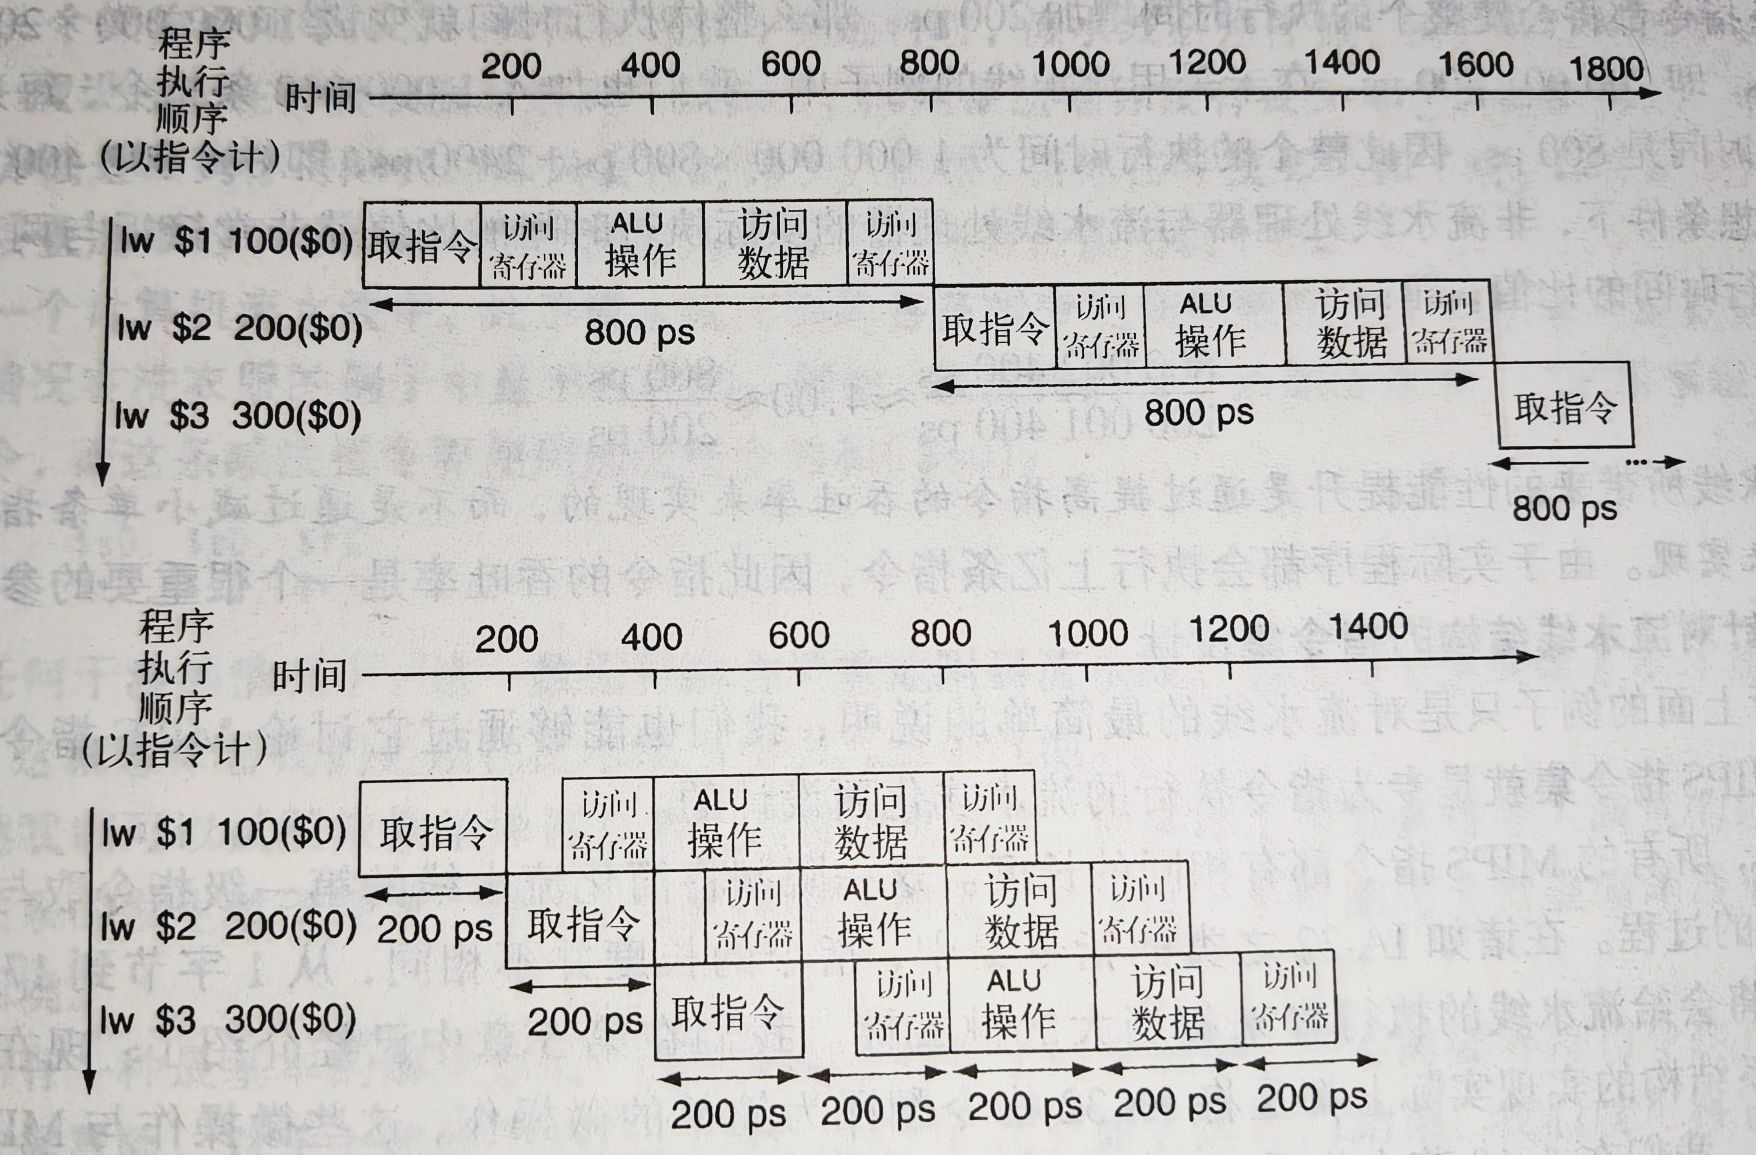
这样一来,当我们使用流水线后,原来5时间才能运行一次,现在只需要1时间就能运行一次了
流水线冒险
在使用流水线时,当某一条指令不能正常顺序执行时,我们就将其称之为冒险,一般将其分为三类:
结构冒险
结构冒险,是指一条本来在某个时钟周期计划要执行的指令,由于硬件缺乏对当前要执行的所有指令的支持,而不能执行的情况
简单来说,就是在物理上不支持某个流水线设计,例如两个指令同时在某个内存地址或寄存器上操作的情况,这个较为简单,无需多言
数据冒险
数据保险,是指由于指令执行所需的数据暂时不可用而造成将要执行的指令不能在原定时钟周期内执行的情况,也就是数据依赖导致的停顿
例如流水线中有两个加法指令:s0=t0+t1; t2=s0+t3;
很显然在流水线中,当第二个指令开始执行时,第一个指令才执行到第一个步骤“取值”;而当第二个指令开始执行“译码和读寄存器”时,第一个指令才走到“执行ALU”这一步,还没有将修改后的s0值通过第四步“访问寄存器”存入新值,导致第二个指令在寄存器中读到的值还是旧数据,所以为了让第二个指令读到新值,我们必须在流水线当中引入三个气泡(即停顿),造成了性能浪费
我们有一种最原始的解决方法:加硬件——我们在ALU和要接受数据的流水线间拉一条路,一旦ALU生成了运算的结果,该结果就能立即传输到下一条线的输入。这个过程称为数据定向或数据旁路,就像这样:
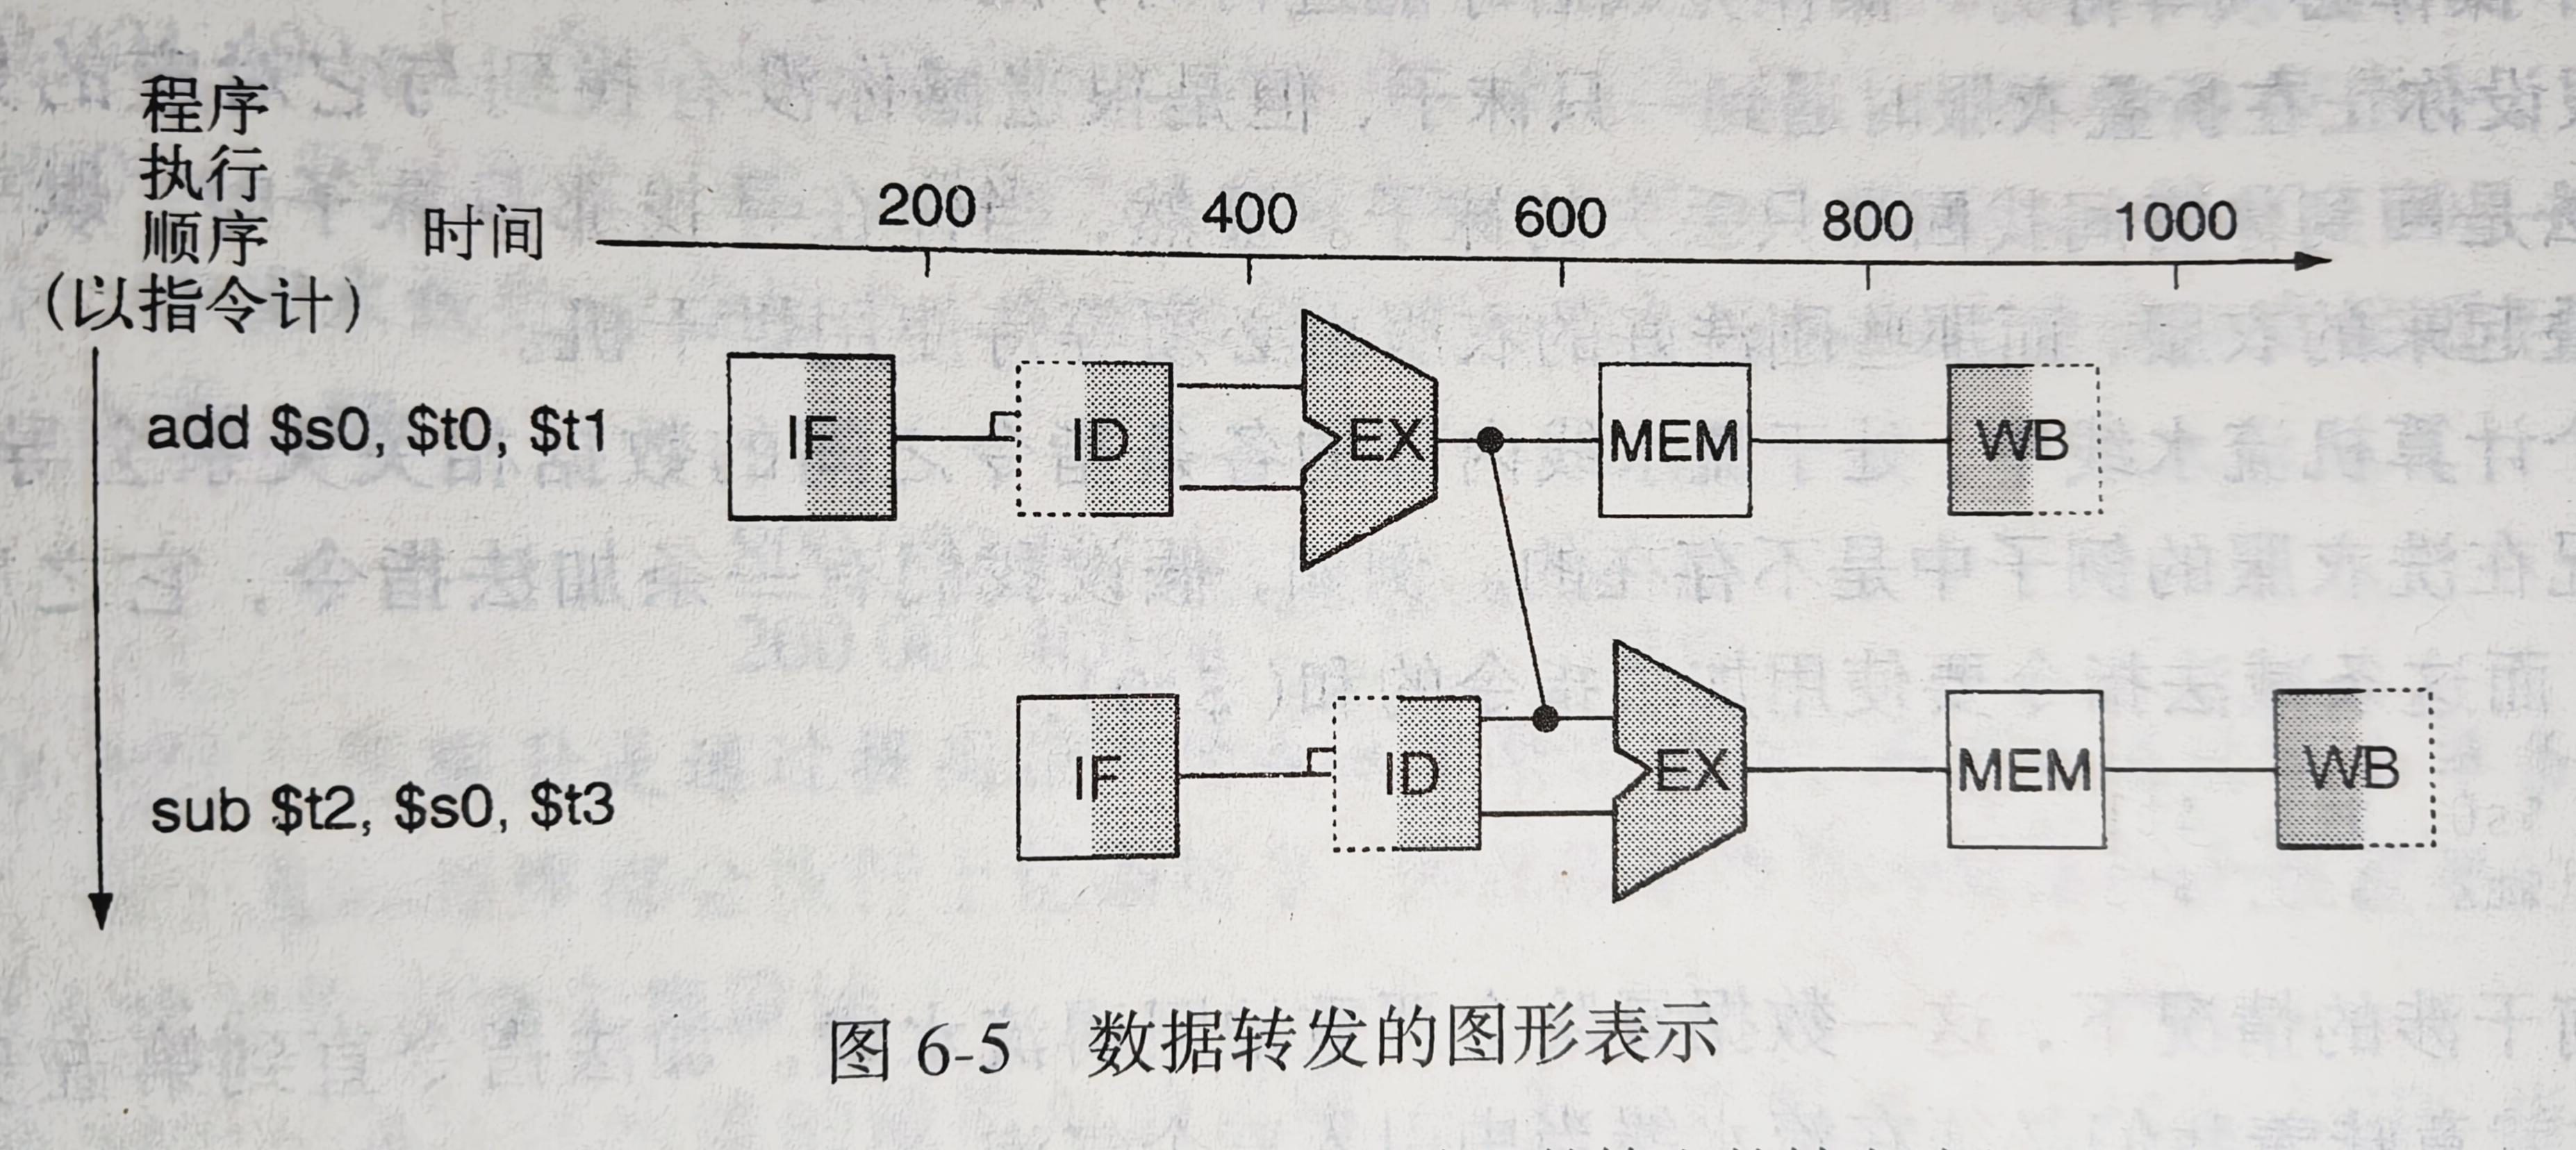
控制冒险
控制冒险,是指在某个周期内应当被执行的指令由于当前取得的指令不是这条真正需要的指令不能被执行的情况,简单点说,就是分支延迟延迟跳转导致的指令错开
通俗地讲,控制冒险就是程序遇到跳转等地址操作跳跃的情况下,取得跳转操作目标地址的时间在执行下一条指令之后,导致当指令跳转时,在跳转前就错误地执行了本不该在跳转前执行的操作
让我们举一个例子,在五级流水线中:
IF  -> ID  -> EX  -> MEM -> WB
取指   译码   执行   访存   写回
假设当前指令是 jump 等跳转指令,这类指令实际上取得跳转目标地址的结果过程在 EX 执行这一步,这代表在执行到这一步之前,如果流水线继续运作,会导致在jump后操作本该被跳过的指令,直到ex获得取值并执行跳转,就像这样:》
周期 1:读取分支指令
周期 2:读取分支后面的指令 A
周期 3:读取指令 B,同时才确定分支应该跳转,此时错误地额外读了AB指令要解决这个问题,除了死板地阻塞,计算机采用分支预测的方法处理分支。具体的预测方式有:
最简单的是 总是遇测分支未执行,即预测不产生分支(跳转),在审核时候都顺序执行,如果遇到跳(即预测错误)就冲刷流水线,CPU 会把错误路径上已经进入流水线的指令标记为无效,然后重新取正确指令
即使是这样,也略显力不从心,于是,一种更复杂的分支是预测方法是 总是预测一些分支成功而一些分支失败,也就是在某些指令后固定预测分支成功,即不跳转,执行下一条;或者在某些指令后总是预测分支失败,即跳转,并猜测跳转地址
比如在下面的go代码中:
for i:=0;i<=100;i++{
    err := excute();
    if err != nil{
        fallback();
    }
}我们就总是预测for循环成功,不跳转,继续执行下一轮循环;并且总是预测if err != nil失败,就跳转到if的下一条指令。这样预测,就能达到这个程序的理想预测状态
但是这些预测方法仍然不满足需求,都是以固定的规律进行预测,我们称之为 静态预测,不会根据程序运行情况改变,当遇到复杂业务时预测概率就飘忽不定,大幅影响服务器性能。而现在常用的预测方式都是动态预测
最简单的就是1-bit预测器,它为分支保存一个二进制状态,0表示上一次没有跳转,下次预测不跳转;1表示上一次发生了跳转,下次预测跳转。这样一来,当分支真正执行后,预测器用实际结果覆盖原来的状态:上次跳转,那么下次预测跳转;上次不跳,那么下次预测不跳。1-bit 预测器的问题是过于敏感。只要出现一次反常结果,它就会立刻改变预测方向
进阶地为了避免预测器被一次偶然结果带偏,我们可以使用 2-bit 饱和计数器,它包含四个状态:
- 00:强不跳转
- 01:弱不跳转
- 10:弱跳转
- 11:强跳转
状态转换规则为 强不跳 00 <-> 弱不跳 01 <-> 弱跳 10 <-> 强跳 11。也就是,每次发生跳转就让计数器+1,否则-1。预测时只需要观察最高位,00、01 预测不跳转;10、11 -> 预测跳转。2-bit 预测器的核心优势就是具有一定“惯性”,通常需要连续出现两次相反结果,才会真正改变预测方向
CPU 不能只保存一个预测状态,因为程序中存在大量不同的分支指令。为此,CPU 会使用 BHT(Branch History Table,分支历史表)
BHT 可以理解为一张由分支指令地址索引的表,PC会进到BHT,找到对应的 1-bit 或 2-bit 预测状态,预测跳转或不跳转
不过,只知道“会跳转”还不够,CPU 还必须知道应该跳到哪里。因此,CPU 还会使用 BTB(Branch Target Buffer,分支目标缓冲)
BTB 主要保存分支指令地址和其映射的预测的目标地址缓存,写一次跳转就直接尝试使用地址缓存跳转
不过现在多使用更先进的分支预测技术,此处不再阐释
层次结构的存储器与高速缓存
概述与提要
接下来,就让我们来到高速缓存的部分,这也是计组对于上层开发者而言最重要的部分,我们要接触并了解CPU Cache 及其衍生机制
在这之前,我们要先知道局部性原理:
- 时间局部性:如果一个数据项被引用,那么在不久的将来它很可能再次被引用
- 空间局部性:如果某个数据项被引用,与它地址相近的数据项可能很快会被引用
其次,我们再介绍一下SRAM和DRAM:
- SRAM 是 Static RAM,静态随机访问存储器。它通常用类似触发器的电路保存 bit,只要不断电,数据就能稳定保持,不需要周期性刷新
- DRAM 是 Dynamic RAM,动态随机访问存储器。它通常用电容中的电荷表示 bit,但电容会漏电,所以必须周期性刷新
我们之前手搓的RAM在构造上严格来说属于SRAM
SRAM 和 DRAM 都是易失性随机访问存储器,断电后数据都会丢失。它们的主要区别在于存储一个 bit 的电路结构不同,因此速度、成本、容量也不同
CPU Cache
我们要知道,CPU 的运算速度远快于 DRAM 的访问速度。如果 CPU 每执行几条指令,都必须停下来等待主存返回数据,那么即使 CPU 的计算单元非常快,大部分时间也会浪费在等待内存上,而这样的速度差异是由物理硬件上的线路和距离带来的
因此,我们希望CPU操作的主存尽可能地接近CPU本身,于是就有了CPU Cache,一块存在于CPU内部的”主存”,CPU Cache 就是位于 CPU 与主存之间的小容量高速存储器,CPU Cache 使用速度较快的 SRAM,保存主存中一部分数据的副本
这样一来,CPU操作内存地址的路径就变成了CPU -> CPU Cache -> DRAM 主存,这就是为什么这一章主要讲解“层次结构的存储器”。当 CPU 需要读取某个数据时,会优先检查 Cache:
CPU 请求数据
    ↓
检查 CPU Cache
    ├── 找到:直接使用缓存中的数据
    └── 没找到:从下一层存储读取,并装入 Cache
现代处理器通常不只有一级 Cache,而是使用多级高速缓存:CPU Core -> L1 Cache -> L2 Cache -> L3 Cache -> DRAM 主存
- L1 Cache 是一级高速缓存,通常离 CPU 核心最近,速度最快,容量最小
- L2 Cache 是二级高速缓存,位于 L1 Cache 和更低层存储之间。它比 L1 慢,但容量通常更大;比主存快得多,但容量小得多
- . . . . . .
当 L1 miss 时,先去 L2 查找。如果 L2 命中,就不必直接访问更慢的主存,从而降低 L1 miss 带来的平均缺失损失
Cache Line
CPU Cache 通常不会只保存程序当前请求的一个变量,而是以一段连续数据为单位,在 Cache 与下层存储之间进行传输,这个基本单位称为Cache line/Cache block/高速缓存块。可以说,CPU Cache的基本单位就是Cache Line,当CPU需要读取一个 8 字节的数据,他就会以一定策略(下文介绍)去Cache Line中查找数据。
还记得空间局部性吗?如果某个数据项被引用,与它地址相近的数据项可能很快会被引用。在这里,如果发生缓存缺失,CPU 不会只从主存读取 8 个字节,而是把包含它的一整条 64 字节 cache line 都装入 Cache,这样当程序读取numbers[0]时,后面的若干元素也可能被一起带入 Cache,程序继续顺序访问 numbers[1]、numbers[2] 时,就有较大概率直接命中缓存,这正是 CPU Cache 对空间局部性的利用
映像高速缓存
我们知道了 Cache 和 Cache Line 的构造和作用,那么地址是怎么定位寻址到Cache Line的呢?答案是映像高速缓存
直接映像高速缓存
首先,我们来看最直接的一种高速缓存,就是直接映像高速缓存,一种每个主存地址对应于高速缓存中唯一地址的高速缓存结构
对直接映像的高速缓存而言,主存地址和高速缓存地址的典型映射通常比较简单,比如几乎所有的直接映射高速缓存都使用以下方式:(块地址)取模(高速缓存中块的数目)。这种映射的优点在于,如果高速缓存块的数目是 2 的幂,取模的计算就可以很简单,只需要取块地址的低 log2 位,因此可以通过低位直接访问高速缓存。同时,由于每个高速缓存的地址可能对应于主存中多个不同的地址,我们怎么知道高速缓存中的数据项是否就是所请求的字呢?我们可以考虑在高速缓存中添加标记,这些标记必须包含能够判断高速缓存中的字是否为所请求的字的地址信息。标记只需包含地址的高位部分,即地址中没有用作高速缓存下标的那些位。在此之外,我们还需要一种方式判断高速缓存块中确没有有效信息。最常用的方法是加一个有效位,来说明一个块是否含有一个有效地址。如果这个位没有设置,则不能取用该块内容。
也就是说,在直接映像高速缓存中,一个地址通常被拆成三部分以及一个有效位:| tag | index | block offset |
block offset:在一个 cache block 内部找具体字节或字index:选择 Cache 中的哪一行,由地址的低 log2 位实现tag:判断这一行里放的是不是目标主存块,由地址的高位部分实现- 一个有效位 valid bit
这种直接映像高速问团的方式简单而又快速,但同时容易发生高速缓存缺失。高速缓存缺失,是指由于数据不在高速缓存中而无法满足的高速缓存的数据请求。例如主存块 0 和主存块 8 都映射到 Cache 第 0 行,如果程序反复访问二者,它们会互相替换,导致频繁 miss,浪费性能
全相联高速缓存
如果说直接映像高速缓存是把每一个主存快块都放在特定的 Cache Line 里,那么全相连高速缓存就是同一个主存块请求可以被放在任意的Cache Line里。因此它没有直接映像中“某个主存块只能去固定一行”的限制,冲突缺失更少。访问时,硬件需要把目标地址的 tag 与 Cache 中所有行的 tag 进行比较,只要任意一行匹配且 valid bit 有效,就是命中
这种方式的优点是放置灵活且冲突缺失少;缺点是需要增加复杂的硬件,并且需要并行更多的 tag,成本较高
组相联高速缓存
组相连高速缓存就是直接映像和全相联之间的折中,它先把 Cache 分成多个组,每组有若干行。一个主存块只能映射到某一个组,但可以放在这个组里的任意一行,在查找主存块位置时,类似于直接映像高速缓存,同样使用低位主存块号对块数取模,也在目标组内比较 tag
所以可以说,直接映像高速缓存和全相联高速缓存,都是组相联高速缓存的一种特殊分类:
- 直接映像高速缓存:就是每个组都只有一行值的组相联高速缓存
- 全相联高速缓存:就是只有一个组的组相联高速缓存
与直接映像相比,组相联减少了冲突缺失;与全相联相比,它不需要搜索整个 Cache,只需要在目标组内比较 tag,硬件成本更低
LRU
对于以上包含组的高速缓存相连方式(比如全相连高速缓存和组相连高速缓存),它们都需要在一个组内,也就是在多个缓存池中进行缓存刷新的取舍。也就是说,当一个新的缓存进入时,必须以一定的策略舍弃一个缓存,并把这个新缓存重新写到该位置上
我们一般使用LRU,Least Recently Used,意思是最近最少使用
在组相联或全相联高速缓存中,如果发生 miss,且目标组内所有 cache line 都已经被占用,就必须选择一行替换出去。LRU 的规则是:
淘汰最近最长时间没有被访问过的那一行它背后的依据是时间局部性:如果一个块最近刚被访问过,那么它很可能马上还会被访问;反过来,最久没被访问的块,未来被访问的概率相对更低
真实硬件中,严格 LRU 的维护成本可能较高,尤其关联度较大时,因此有些处理器会使用近似 LRU
写操作处理
在项目中使用过缓存的我们都知道,要读缓存非常轻松,但是一旦要写缓存,各种问题就接踵而至,CPU Cache也是一样
读miss通常只是把主存中的块复制到 Cache,一般不会造成主存和 Cache 不一致。但是写操作 store 是 CPU 写入新值,这时主存和 Cache 对同一地址保存了不同的值,导致不一致的出现。例如:
原来:
主存 x = 10
Cache x = 10

CPU 执行 x = 20
如果只写 Cache:
主存 x = 10
Cache x = 20
为解决写入后的不一致问题,常见写策略有以下几种:
Write-through
写通过(Write-through)是 写操作总是同时更新高速缓存和主存,以保持数据一致性的策略,也就是每次写 Cache 的同时也写主存
优点是主存和 Cache 保持一致。缺点是每次写都要触达更低层存储器,开销较大,一般不使用
Write buffer
写缓冲(Write buffer)是 在数据等待被写入主存时,存放数据的队列,用来暂存还没来得及写入下一层存储器的写请求
在 write-through 策略中,如果 CPU 每次写 Cache 后都必须等待主存写完,写操作会非常慢。加入 write buffer 后,CPU 可以先把写请求放进缓冲区,然后继续执行后续指令,由写缓冲区在后台慢慢把数据写到主存
write buffer 的作用是降低 CPU 因等待主存写入而停顿的概率,但它不能让主存写入本身消失。如果写入速度太快,write buffer 被填满,CPU 仍然需要等待
Write-back
在现代CPU中,我们常采取写回,也就是write-back的策略。也就是 写操作时只更新高速缓存中的块,当高速缓存块被替换时,才将修改过的块写入底层存储器,提高效率
简单来说,CPU 先只写 Cache,并把该 cache line 标记为 dirty bit。等这个块被替换出 Cache 时,再把标记为 dirty bit 的Cache line写回主存。优点是多次写可以合并,性能较好。缺点是主存和 Cache 会在一段时间内不一致,需要 dirty bit 管理
False Sharing
同时结合我们的日常业务来说,在单核单机情况下,缓存策略已经解决得差不多了,但在分布式情况下,缓存也会面临新的问题。同样地,在电脑中,一般是多核 CPU 一起工作的,这导致多核 CPU 在并发状态下也会产生很多缓存问题。false sharing 就是多核缓存场景下的性能问题。如果两个核心上的线程分别修改不同变量,但这两个变量恰好落在同一个 cache line 中,那么硬件缓存一致性协议会把整条 cache line 当作共享单位来同步。结果是两个线程虽然没有逻辑上共享同一个变量,却会因为共享同一条 cache line 而互相使对方的缓存行失效
解决思路是让高频写入、由不同核心修改的变量分布到不同 cache line,例如使用 padding 或调整结构布局。我们在后文 多处理器与并发 中会再次详解
虚拟存储器
那我们再回头看 CPU cache 的设计哲学:将缓存放在与 CPU 极近的距离,来提高 CPU 的运行性能。同样的,我们把这个思想类比到储存与磁盘中:虚拟存储器可以理解为把主存作为辅助存储器的高速缓存。这里的“辅助存储器”通常指磁盘或 SSD
在层次结构的思想之外,虚拟存储器更是提供了计算机系统的一个重要根基:地址抽象。在程序运行中,虚拟存储器会为程序提供虚拟地址,并非真实物理地址。每个进程看到独立、连续的虚拟地址空间,最后再由硬件解成物理地址
更完整地说,虚拟存储器不是某一块具体硬件,而是硬件和操作系统共同提供的一套内存抽象机制。它让程序使用虚拟地址,而不是直接使用真实 DRAM 的物理地址。因此,现代系统里,虚拟存储器更常见、更重要的作用是地址翻译、进程隔离、按需分配和内存映射,而不只是用磁盘扩充内存容量
它主要提供三个能力:
1. 地址抽象:每个进程看到独立、连续的虚拟地址空间
2. 保护隔离:不同进程不能随便访问彼此的内存
3. 按需调入:只把当前需要的页放入主存,不需要的页可以暂时留在磁盘
因此,“虚拟存储器允许程序可使用的虚拟地址空间大于物理内存”这个理解是对的,但不完整。现代系统里,虚拟存储器更常见、更重要的作用是地址翻译、进程隔离、按需分配和内存映射,而不只是用磁盘扩充内存容量
虚拟存储器的基本单位是页 page。主存中保存的是一部分当前正在使用或最近使用的虚拟页;不在主存中的页可以暂时留在磁盘上。访问不在主存中的页时,会触发缺页异常,由操作系统把对应页从磁盘调入主存
存储器与IO
这一章主要是讲存储器,网络和其他外围设备的,网络部分也只是短短几行字提了一嘴,我们就跳过在计网再深入探讨。并且本书只提及机械硬盘(HDD)的存储器原理,而非现在主流的固态硬盘(SSD),所以我们会在机械硬盘原理上进行部分拓展
磁盘存储
HDD
首先,我们要知道,HDD(机械硬盘)通过磁性盘片保存数据。盘片表面被划分为多个同心圆,这些同心圆称为 磁道(Track);每条磁道又被划分为多个 扇区(Sector)。磁头悬浮在盘片表面,通过盘片旋转和磁头移动完成数据的读取与写入。如果硬盘有多个盘面,那么不同盘面上半径相同的一组磁道可以构成一个 柱面(Cylinder)。而一次机械磁盘 I/O 的总时间可以拆成:T_total = T_seek + T_rot + T_trans
T_seek:寻道时间,磁头移动到目标柱面T_rot:旋转延迟,盘片转到目标扇区T_trans:传输时间,真正读写数据所花时间
因此,HDD的关键特征是:定位成本 seek + rot 远大于传输成本 trans
因此,顺序的I/O普遍都比较顺畅,而随机的I/O,例如散落小文件剪贴,则很慢
SSD
相反,现在计算机多使用SSD,即固态硬盘作为持久化存储设备
与 HDD 不同,SSD 没有磁头、盘片和机械运动部件,而是使用 NAND Flash 闪存保存数据。因此,SSD 不需要执行寻道和等待盘片旋转,通过电子信号直接访问闪存单元。这使 SSD 的随机访问延迟远低于 HDD,尤其适合数据库、编译、大量小文件访问等随机 I/O 较多的工作负载。
但是,SSD 并不是一块简单的“大容量内存”。NAND Flash 有一条重要限制:数据可以按 page 读取和写入,但必须按更大的 block 擦除
SSD 内部的存储层次可以简化为:
- Cell -> 保存一个或多个 bit
- Page -> 读取和写入的基本单位
- Block -> 擦除的基本单位,包含许多 page
SSD 通常不能像 DRAM 那样直接在原位置覆盖已有数据。当主机修改某个逻辑地址的数据时,SSD 通常会找到一个新的空闲 page,将新数据写入这个 page,然后更新逻辑地址与物理 page 的映射,再将旧 page 标记为无效,再在之后的垃圾回收中擦除旧数据所在的 block。这称为 异地更新(Out-of-place Update),即旧逻辑地址 指向的是 旧物理 page,在发生修改后旧逻辑地址 才指向 新物理 page,而旧物理 page 被标记为无效。这也是为什么有时候我们可以通过硬盘修复某些被硬删除的数据
FTL
操作系统看到的 SSD 是一系列连续的逻辑块地址,但 NAND Flash 内部的数据位置会不断变化,负责维护这种映射关系的是 FTL(Flash Translation Layer,闪存转换层)
操作系统访问逻辑块地址 LBA
             ↓
       SSD 控制器中的 FTL
             ↓
      实际 NAND 物理 page
FTL 的主要职责包括:
- 逻辑地址到物理地址的映射
- 垃圾回收
- 磨损均衡
- 坏块管理
- 空闲空间管理
垃圾回收与写放大
由于 SSD 只能按 block 擦除,当一个 block 中同时存在有效 page 和无效 page 时,SSD 不能直接擦除整个 block,它必须先将仍然有效的数据搬到其他位置,即在读取有效 page后,需要先写入其他 block,才能擦除原 block。这个过程称为 垃圾回收(Garbage Collection,GC)
垃圾回收会导致 SSD 内部实际写入的数据量超过应用程序请求写入的数据量,这种现象称为 写放大:
例如,应用程序只写入 4KB 数据,但 SSD 为了搬迁有效 page,内部可能实际写入 16KB
写放大会带来写入延迟上升,SSD 内部带宽被占用,闪存单元磨损加快,P99、P999 尾延迟出现抖动等问题。当 SSD 接近写满时,可供 FTL 选择的空闲 page 和 block 变少,垃圾回收成本通常会明显上升。因此,数据库和高写入服务通常不应该把 SSD 容量完全用满
DMA
DMA 是 Direct Memory Access,直接内存访问
没有 DMA 时,CPU 需要亲自把数据从设备搬到内存,或者从内存搬到设备。有 DMA 时,CPU 会配置 DMA 描述符,然后让设备/DMA 控制器直接读写内存,传输完成后通过中断或轮询通知 CPU
多处理器与并发
在计组的最后,我们从思考走向实际:在现代计算机体系中,往往不使用单处理器,而是走向多处理器、片内多核、多线程和集群,继续提高系统性能。与此同时,多核的并发写入也会带来新的问题
缓存一致性与MESI协议
多核系统中,每个核心通常有私有 L1/L2 Cache。如果多个核心缓存了同一个内存地址,就必须保证它们看到的数据符合一致性规则
例如:
Core A 的 Cache 中 x = 0
Core B 的 Cache 中 x = 0
Core A 写 x = 1
Core B 如果继续读自己的旧副本,就会读到 x = 0为了解决缓存一致性问题,我们通常使用MESI协议
MESI 是一种常见缓存一致性协议。它以 cache line 为单位维护状态。MESI有四种状态:
M Modified:本核心修改过,内存中是旧值,只有本核心副本有效。E Exclusive:本核心独占,内容和内存一致,其他核心没有副本。S Shared:多个核心可以读,内容和内存一致。I Invalid:该副本无效,不能使用。
在该协议下,并发缓存的典型流程是这样的:
多个核心读同一 cache line -> 状态为 Shared
某个核心要写 -> 通知其他核心把该 line 置为 Invalid
写入核心获得 Modified 状态
其他核心再读 -> 必须重新获取最新数据
MESI 管理的是 cache line,不是单个变量
伪共享
伪共享,也就是我们之前提到过的 False Sharing,是多核程序中的重要性能陷阱
如果两个不同变量位于同一个 cache line 中,即使它们在逻辑上互不相关,只要不同核心频繁写它们,就会互相使对方的 cache line 失效
例如在Go代码中:
type Counters struct {
    A int64
    B int64
}
如果 goroutine 1 高频写 A,goroutine 2 高频写 B,而 A 和 B 位于同一个 64B cache line 中,就可能产生伪共享。
解决思路是padding,通过占位,让高频写变量落在不同 cache line 上:
type Counters struct {
    A int64
    _ [56]byte
    B int64
}
Amdahl 定律
在一个系统中,他的加速上线由他并行的部分决定——Amdahl 定律描述并行加速上限,其关键结论是:哪怕串行部分很小,也会限制无限加核后的最高加速比。例如 10% 串行,则理论最大加速比不超过 10 倍。所以我们可以发现,Redis 的核心命令执行长期采用单线程模型,并不是因为不能使用多核,而是因为它选择避免锁、共享状态和缓存一致性开销
GPU
我们发现,书上没有讲解GPU这一如今十分重要的计算机组成部件,此处拓展
GPU(Graphics Processing Unit,图形处理器)同样是处理器,但它和 CPU 的设计目标不同
- CPU 追求低延迟和通用性:核心较少但较强,拥有复杂的分支预测、乱序执行和较大的缓存,适合执行控制流程复杂、任务差异较大的程序
- GPU 追求高吞吐量:拥有大量相对简单的计算单元,让大量线程同时执行相似操作,适合图形渲染、矩阵计算、机器学习和科学计算
GPU 并没有脱离前面章节的知识体系,它仍然包含:
- 指令与数据通路。
- 流水线。
- 寄存器和多级缓存。
- 主存或显存。
- 多处理器与多线程。
- 存储层次和局部性。
GPU 的关键执行思想通常称为 SIMT(Single Instruction, Multiple Threads,单指令多线程)。大量线程会被分组执行;在 NVIDIA 术语中,一组通常称为 warp(线程束)。同一线程束中的线程通常执行同一条指令,但处理不同的数据
如果同一线程束中的线程遇到分支并走向不同路径,就会发生分支发散。硬件通常需要分批执行各条路径,使并行效率下降。因此,GPU 擅长规则、数据并行度高的工作,不擅长大量不规则分支和强串行依赖的工作
GPU 通过大量并发线程隐藏访存延迟:当一组线程等待数据时,调度器切换到另一组可运行线程。它更依赖高并发和高显存带宽,而 CPU 更依赖大缓存、复杂控制逻辑和较低的单线程延迟
显存通常指独立显卡上的高带宽内存,例如 GDDR 或 HBM。独立 GPU 与 CPU 往往拥有各自的内存空间,数据需要经过 PCIe 等互连传输;这段传输开销可能抵消 GPU 计算带来的加速。集成 GPU 则通常与 CPU 共享主存,但仍可能有不同的缓存和一致性设计
如今,GPU更是用来训练和运行AI大模型,这都是因为神经网络的大部分计算可以转化为矩阵乘法、向量运算和乘加运算。一次运算中的大量元素通常可以彼此独立地计算,因此具有很高的数据并行性
CPU 擅长复杂控制流程和低延迟任务;GPU 则拥有大量计算单元,可以同时处理矩阵中的大量元素。现代 GPU 还可能包含专门加速低精度矩阵乘法的 Tensor Core。CUDA、ROCm 等软件平台负责把 PyTorch 等框架中的张量运算调度到 GPU 上执行
后记
从咸鱼花了几块钱淘了一本第三版(2008年版)《计算机组成与设计:硬件/软件接口》,闻起来有股老图书馆里的图书的味道,或者说灰尘或者尘霉的味道?反正花了与大概8天时间啃完了这本书。这本书有相当多的部分是讲解硬件原理的,这些部分都跳过不看,剩下软件的部分我认为也讲的可圈可点,只是其需要默认你知道计组的一些底层设计,如CPU的组成和运作原理,汇编和指令集等,因此我才理解了小林Coding说为什么这本书适合先看完《计算机科学速成课》后再进行深入阅读,否则很容易看得云里雾里,不知所云的。有些东西啃书的时候有很多理解,也产生了很多思考,但是实际隔几天写出来的时候却全都忘了,或许是我写得太心急了。之后学的时候我打算每天都记录一点相关思考,随记在手机啥的上面,防止写出来的东西又浅浅的
同时,计组部分的知识相对os等其他底层来讲也许并没有如此重要,因此这篇博客实际上记录得并不算细节,也只算是把所有知识都过了一遍
接下来就打算开始学习OS相关内容了,目前准备先看一下汇编(看学长博客说的看王爽汇编),然后再啃CSAPP这本书,啃了关键那几章后就去做mit 6.S081的前四个 Lab,这一套组合拳下来估计又要花一个多月
顺带一提,正在激情上连续20天的高数早八小学期,微死(甚至有两天没起来刚好点名导致缺勤两次),什么时候好好休息一上午啊!!!小学期完了又是驾照啥的,烦死了(>д<)
参考文章
《计算机科学速成课》
《计算机组成与设计:硬件/软件接口》
评论
留言与讨论 ↗欢迎留下想法或问题。这里承接旧站已有评论。
正在加载评论…